2026 年 8 月,一个研究团队做了一件听起来很笨的事:把 65.7 万条网页链接逐条点开,看它们还活着没有。结论让人心里发凉——76.7% 已经打不开了。换句话说,你十年前随手收藏的网页、当年转发过的新闻、曾经天天刷的老博客,很可能早就消失了,只是你不知道。
这个测试之所以可信,是因为它够大、够笨。几万条样本容易被人质疑抽样偏差,而 65.7 万条,几乎是当年一个真实网络社区分享过的全部网址。
这些链接从哪里来
这 65.7 万条链接,来自一个叫 0.mk 的短网址服务——北马其顿的第一个,2009 年由三个业余爱好者搭起来。他们平时上班,周末维护,帮大家把长长的网址变成短链接。2014 年,这个服务撑不下去了:没有收入,服务器要花钱,垃圾链接泛滥,三个人关掉了它。十七年后,其中一人在旧硬盘里翻出一份数据库备份,把数据恢复了回来。
这批数据因此成了一个小小的「数字琥珀」:2009 到 2014 年间,一个互联网社区分享过的所有网址,原封不动地躺在数据库里。六年间用户一共创建了 65.7 万条链接,2013、2014 两年最活跃,每年都超过 20 万条。
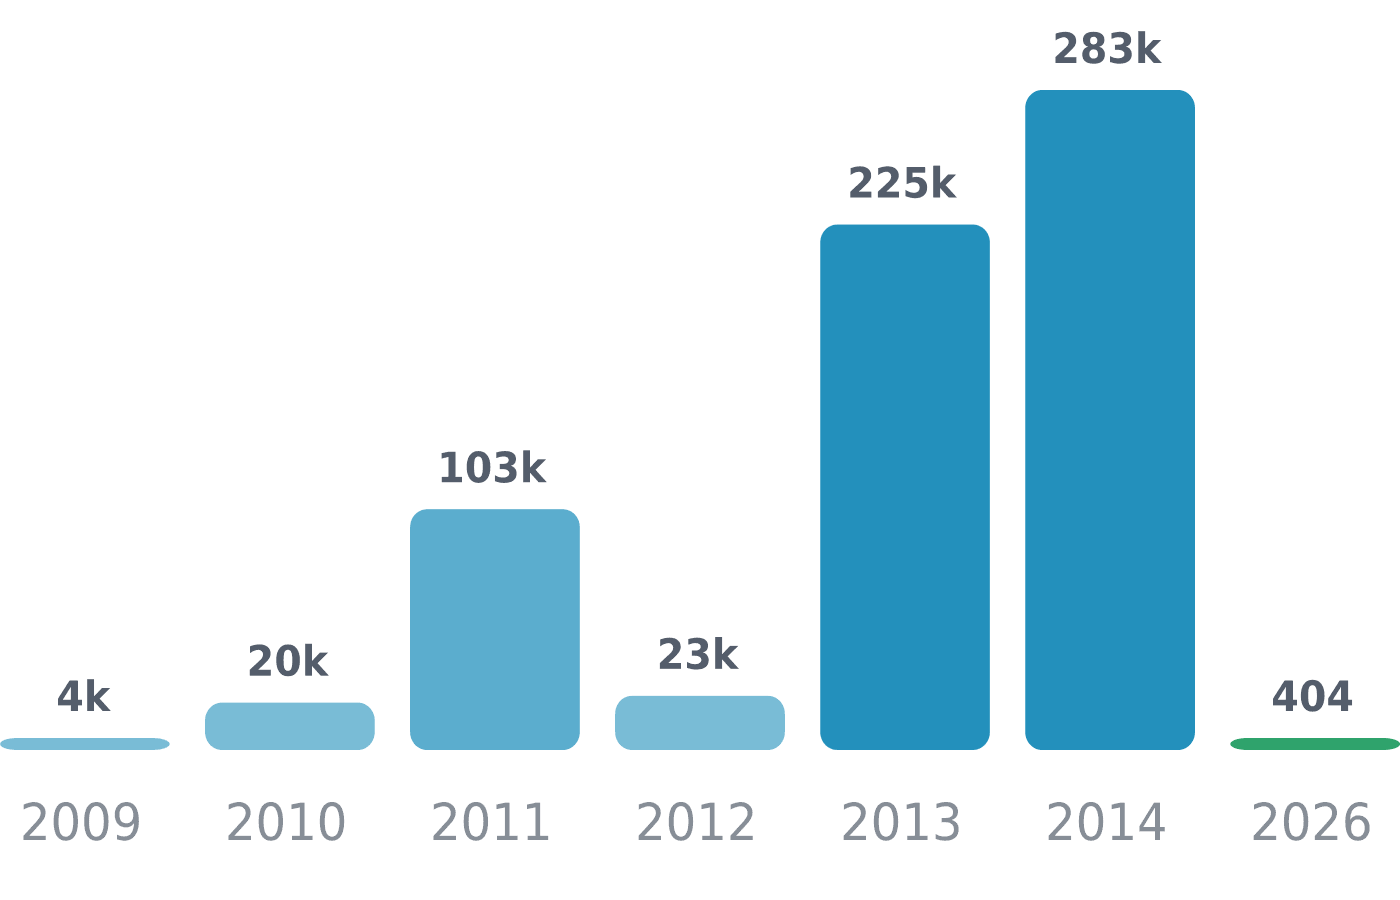
图:0.mk 用户每年创建的链接数量,2013、2014 年是高峰。来源:0.mk 原文
测试是怎么做的
研究者写了一个程序,把每条链接当成普通访客去访问:允许网站跳转最多五次,第一次连不上的,换一条网络线路再试一次。这样测出来的结果已经相当「宽容」——只要网站还愿意回应,就算它过关。
结果是三块:
- 51.24% 的链接完全连不上:域名没了、服务器关了、网站被删了;
- 25.44% 返回错误页面,最常见的是 404,也就是「页面不存在」;
- 23.32% 还能打开。
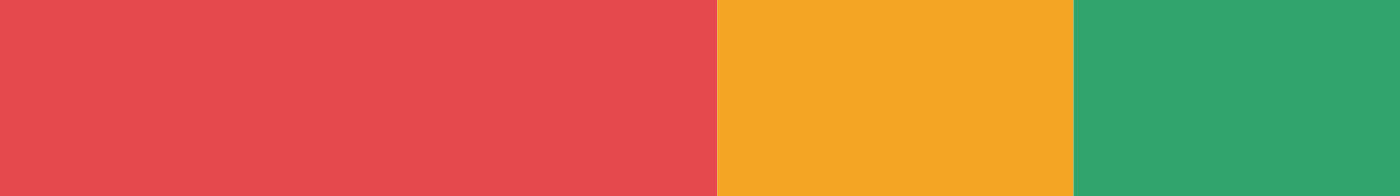
图:65.5 万条可测试链接的结果——红色是连不上,黄色是返回错误,绿色是能打开。来源:0.mk 原文
同一个网址被分享很多次,只算一次的话,情况也差不多:49.2 万个不同的网址里,只有 21.3% 能打开。再往上一层看更惊人——13.36 万个不同的网站域名里,9.87 万个连一条链接都打不开,等于整站消失。
这里有个容易被忽略的细节:23.32% 的「能打开」,水分很大。登录墙、域名过期后被广告商买下挂满广告的页面、「本内容已下架」的通知——这些在程序眼里都算「能打开」。页面还在,不代表内容还在。
链接为什么会死
从数据看,死法五花八门,大致能归成几类。
公司倒了。Rapidshare 和 Megaupload,当年全球最大的两个网盘,分别有 139 条和 71 条链接指向它们,如今一条都打不开。
平台改版或关停。当年大家习惯把 Facebook 的图片链接直接发到别处——835 条这样的链接指向 Facebook 的图片服务器,全军覆没,一张图都没留下。谷歌的 Picasa 相册,69 条全灭。谷歌的代码托管平台 Google Code 稍好一点,803 条里大部分被重定向到了存档页——注意,是「存档页」,不是原页面。
域名没人续费。这是最普遍的死法:个人站长不做了、公司注销了,域名到期没人管,一两年后就被抢注或彻底消失。小网站比大网站死得快得多——数据里幸存下来的,大多是 YouTube、维基百科、谷歌这种巨头;个人博客、论坛、地方新闻、相册站,才是重灾区。
短链套短链。有人当年把链接用别的短链服务缩短后,又套了一层 0.mk。如今谷歌在 2025 年关闭了 goo.gl 短链服务,中间那一环断了,两头都成了死路。短链本来是图方便,结果让链接加倍脆弱。
还有一个让人唏嘘的地方。0.mk 的用户大多是北马其顿人,数据里能看到这个国家的一部分历史:A1 电视台 2011 年关停,三份主要报纸在 2017 年停刊,它们的网页跟着编辑部一起消失。本地新闻的链接,如今只有在互联网档案馆里还能找到一些。短链接活得比新闻编辑部还久。
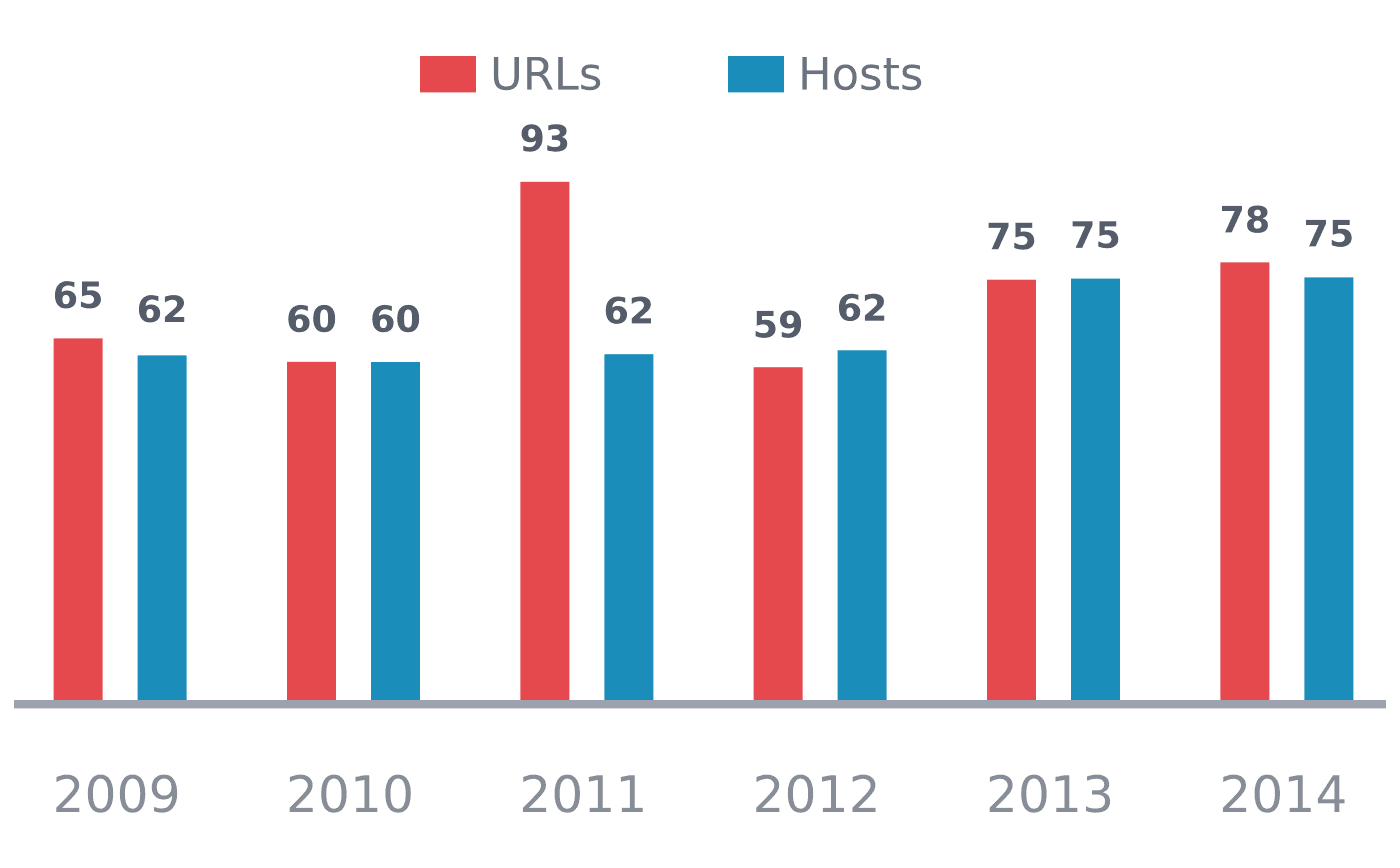
图:按年份统计的「打不开」比例,红色按链接算,蓝色按网站域名算。来源:0.mk 原文数据
按年份看,还有一个有趣的插曲:2011 年的链接死亡率高达 92.5%,远超前后年份。原因是一个账号当年向同一个教学网站发了 8.3 万条链接,网站后来没了,把这一年的数据整个带崩。按域名算,2011 年和 2010、2012 年几乎一样。这说明看数据要拆开看结构——总量会骗人。
谁在抢救
面对这场静默的大面积死亡,确实有人在抢救。最著名的就是互联网档案馆(Internet Archive)的「时光机」(Wayback Machine):从 1996 年起,它用爬虫定期抓取网页,把当时的页面原样存下来。今天输入一个网址,你就能看到它十年前、二十年前的样子。已经关停的论坛、被删掉的新闻、1990 年代的网站,很多只能在那里找到。
它甚至提供「即时保存」:你手动提交一个网址,它立刻抓一份存起来。这个功能对写作者和研究者来说是救命稻草——看到重要的页面,先存一份再说。
但抢救的速度远远赶不上死亡的速度。有网友举了真实的例子:一个很大的网站消失后,档案馆里只存下了部分网页,图片和数据库都没了。救不回来的原因有很多:
- 爬虫没发现它。太冷门、太深的页面,档案馆根本不知道它存在过;
- 网站用 robots.txt 声明「禁止抓取」,爬虫遵守规则绕开了——等网站消失,这个「别抓我」就成了它留在世上的最后一句话;
- 动态页面抓了也是空壳。需要登录、需要实时查询数据库、全靠脚本现场生成的内容,存下来的只是一副没有内容的骨架;
- 还有最底层的「比特腐烂」:存储介质上的数据会随时间慢慢出错,就像纸张会发黄。
这对普通人意味着什么
说回我们自己。这篇研究想说的其实很简单:我们以为互联网是永恒的,其实它不是。
你的收藏夹会失效;你写东西引用的新闻会找不到原文;当有人拿着截图传播谣言时,想找原始出处来对质,可能已经无处可寻——原文都没了,怎么证伪?有网友总结了一句扎心的「墨菲定律」:你想引用的时候,它一定没了;你想删掉的东西,一定永远都在。
互联网从设计之初就没打算保存自己。商业公司没有义务为你的记忆负责,服务器账单没人付,内容就会被抹掉。档案馆们在和腐烂赛跑,而且跑得很吃力。笔者写完这篇稿子,也顺手把自己的网页存进了「时光机」——在数字时代,这可能是普通人能做的唯一一件小事:重要的东西,自己留一份。
参考链接:
- 原文博客: Where did the old web go? We followed 657,607 links to find out
- HN 讨论 (item?id=49289532)
- 互联网档案馆: Wayback Machine