2026 年 9 月 11 日,开源安全代理 bomfather 的作者 Nathan Naveen 提交了一个核心改动。他通过引入 inode 级别的策略缓存,将内核侧 CPU 消耗压低了 90%。缓存策略判定结果能把成本砍掉九成。真正难的地方在于 key 怎么选。mount namespace ID + mount ID + inode 这个三元组,把文件系统语义里所有角落都暴露了出来。硬链接、目录改名与跨命名空间问题成了无法回避的技术债。性能数字是头条。正确性边界才是正文。
路径遍历吃掉八成判定开销
安全代理的性能瓶颈往往不在于阻断动作本身。执行 allow 或 deny 只是一次简单的条件分支。最昂贵的环节是判断当前访问的文件到底适用哪条策略。代理把策略检查逻辑挂在 LSM 的 file open 钩子上。每次应用层发起文件打开请求,内核都要沿着父 dentry 一级级向上回溯。内核需要逐级比对当前文件与所有祖先目录,以此确认是否命中阻断规则。
当 Postgres 数据库高频读取 data/base 目录下的分片文件时,这种设计的劣势被急剧放大。Postgres 每次读取 data/base/{123,234,345},引擎都要重走一遍完整的 dentry 链。同一个子树被高频反复访问。这些基于字符串比较的指针遍历动作被重复了成千上万次。无缓存状态下的内核火焰图给出了精确的量化结果。
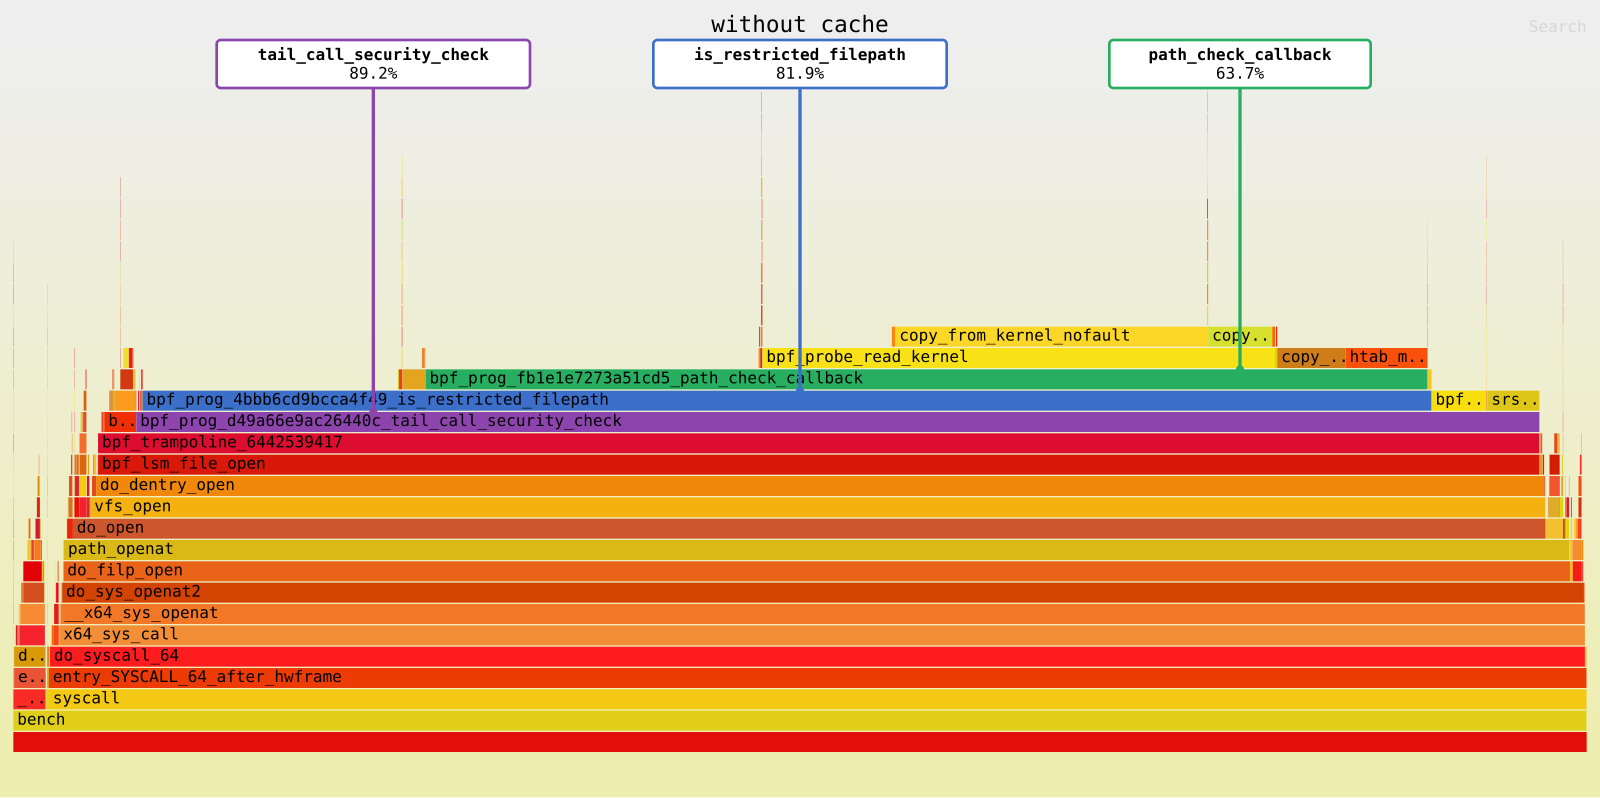 图:无缓存时的内核火焰图:路径遍历占据主要开销。来源:nathannaveen.dev
火焰图数据表明 tail_call_security_check 占了总开销的 89.2%。这其中 is_restricted_filepath 占据 81.9%,path_check_callback 占了 63.7%。字符处理在内核态属于成本极高的操作。这些函数里的字符串匹配与遍历吃掉了绝大部分的可用算力。
三元组做键撕开文件系统语义所有角落
引入缓存机制首先要解决缓存键的数据结构设计。dentry 是内核态管理目录层次的数据结构指针。eBPF map 的安全机制不允许直接将内核指针作为键值存储。如果把 dentry 的具体内容打包成庞大的结构体当键,结构体体积又会过大,导致内存开销与哈希计算成本飙升。作者最终选择了一个三元组作为 LRU 哈希表的键。
这个三元组是 mntns_id、mount_id 和 inode。这三个字段恰好对应了 Linux 虚拟文件系统的三种核心隔离维度。mntns_id 确保缓存条目不会在不同的 mount namespace 之间串联。容器 A 和容器 B 即使运行相同的文件树,也无法越权共享策略。
mount_id 解决的是挂载点重叠引发的路径歧义。inode 号只在单一的文件系统挂载树内保持唯一。内核必须明确区分当前访问是从哪棵存储树发起的。这个三元组强迫开发者直面那些容易被忽视的内核边缘场景。
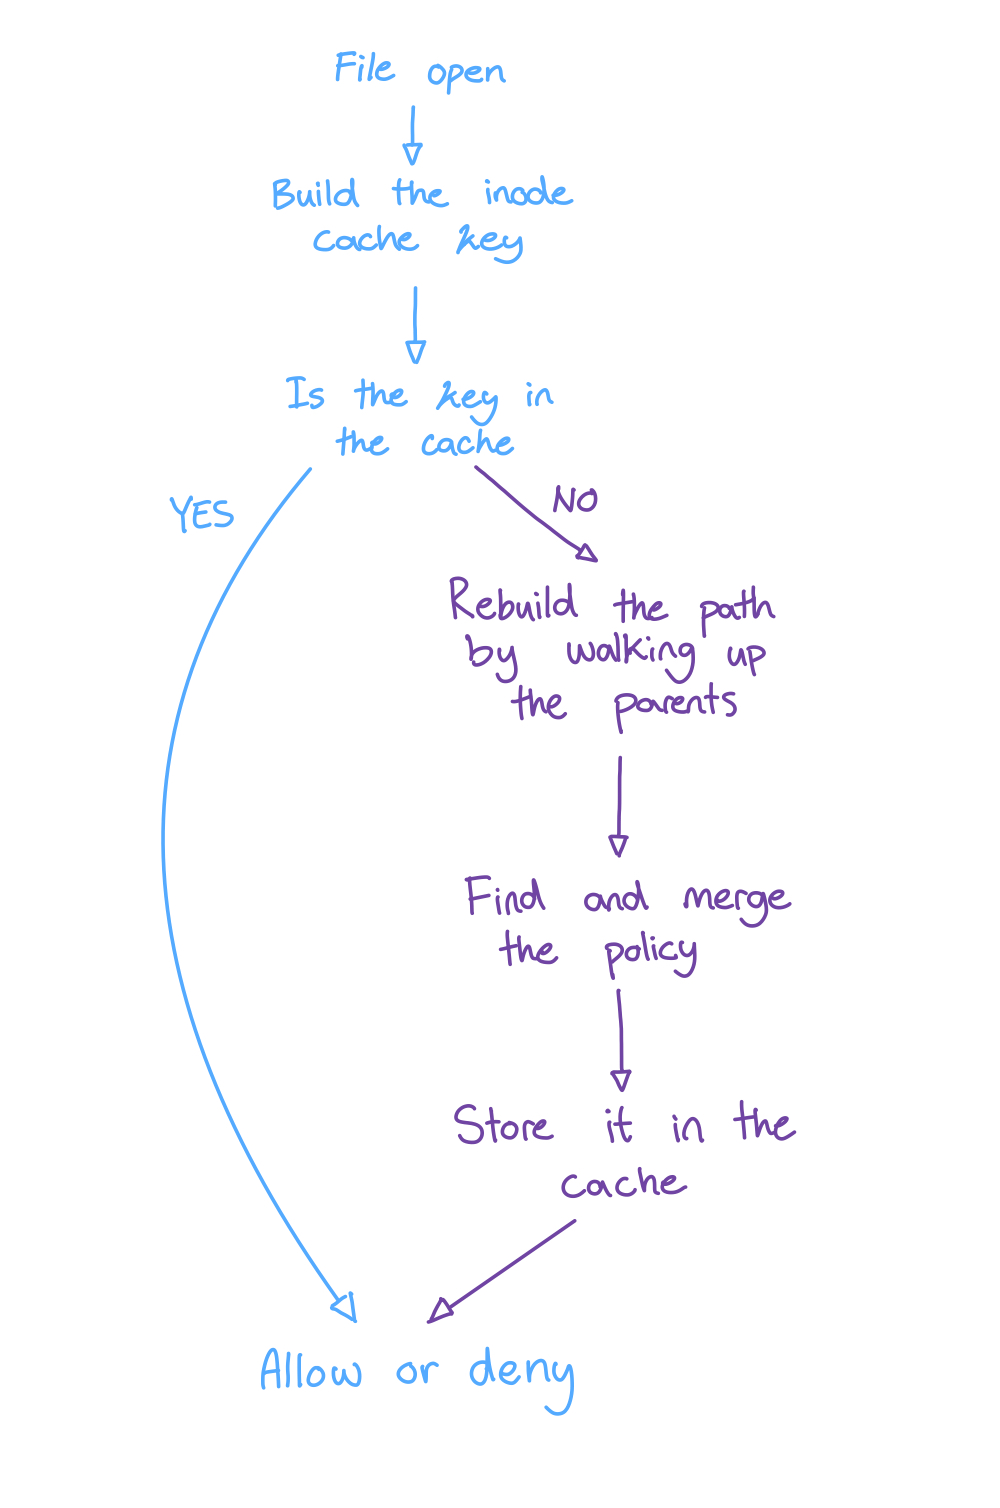 图:代理的检测与策略判定流程示意。来源:nathannaveen.dev
程序在 eBPF 中分配了一个 BPF_MAP_TYPE_LRU_HASH 类型的 map,最大容量设定为 10000,命名为 bomfather_inode_policy_cache。缓存的值分为 access_index 和状态标记。状态字段涵盖 NO_POLICY、ACCESS_INDEX、GLOBAL_READ_ONLY 和 ACCESS_INDEX_AND_GLOBAL_RO。命中缓存直接返回结果,未命中则回退到慢路径并将结果写回。这种设计把复杂的策略配置文件映射成了内存里的状态机。
遇到硬链接直接放弃缓存回退慢路径
缓存设计中最危险的情况是一键多值。文件系统里的硬链接机制完美命中了这个盲区。多个不同的绝对路径可以共享一模一样的 inode 编号。如果策略规定允许访问路径 A,同时拒绝访问路径 B。当 A 和 B 碰巧是同一个底层文件的硬链接时,缓存就会给出越权的放行结论。
作者处理这个问题的手法非常直接。代码逻辑中读取了内核数据结构里的 i_nlink 字段。只要判断出 nlink != 1,判定引擎就直接跳过缓存读取阶段。此时程序强制回退到耗时的慢路径,并向 INODE_CACHE_STATS_SKIPS_NLINK 统计变量累加计数。
这是拿缓存覆盖率换准确性的典型交易。硬链接文件每次访问都要承受完整的路径计算开销。作者在技术记录里给出了工程判断。准确比缓存性能更重要。安全产品在漏报和性能损耗之间只能倒向性能损耗。这种粗暴的降级机制规避了复杂的引用计数管理。
90% 降幅建立在最优读写场景上
缓存带来的性能跃升在图表上表现得十分惊人。在同一文件被连续打开 200,000 次的极限基准测试中,内核 cycles 消耗从 28 billion 暴降到 3.03 billion。这个测试成绩支撑了标题里 90% 的性能优化承诺。
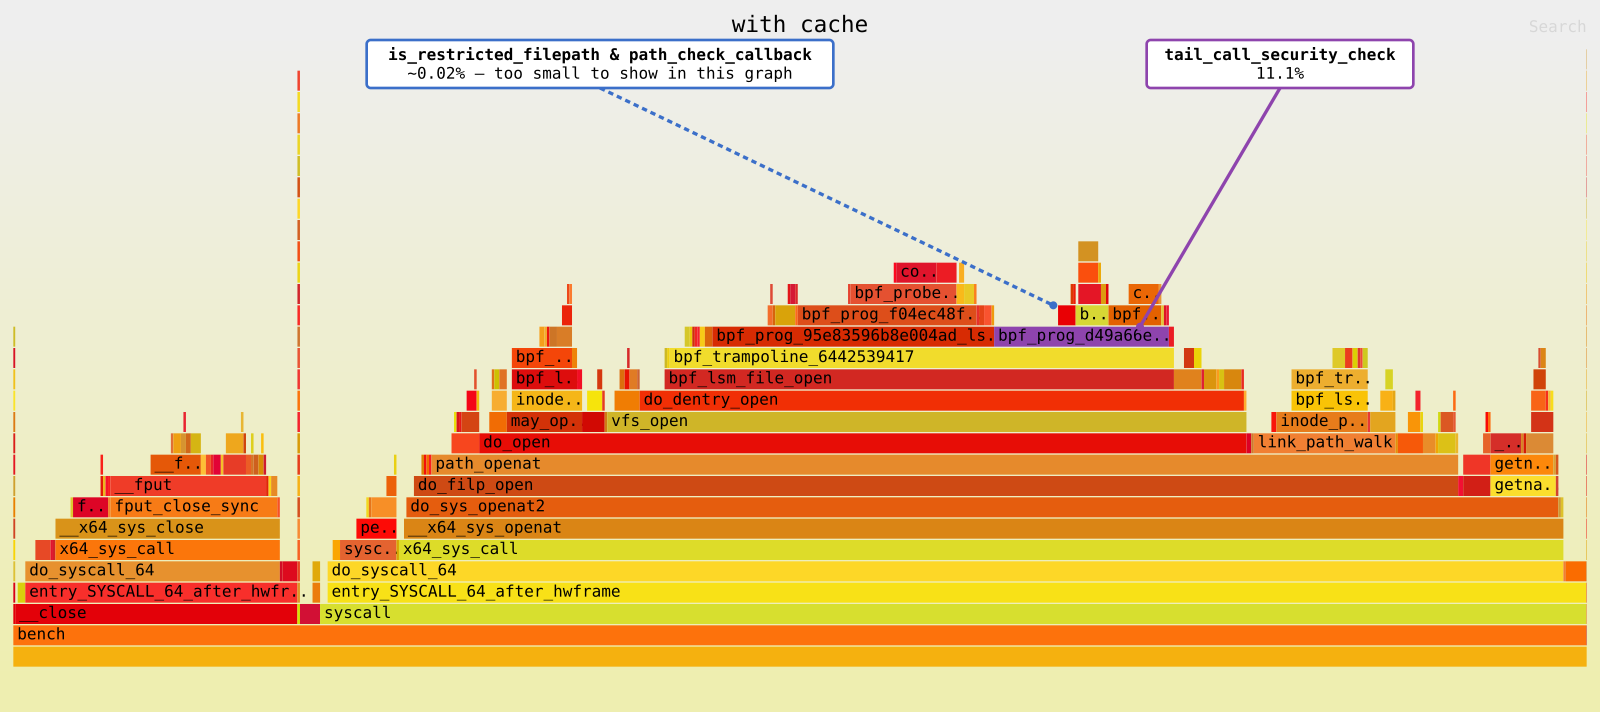 图:加缓存后的火焰图:路径遍历相关符号降到约 0.02%。来源:nathannaveen.dev
火焰图的变化揭示了底层的运行状态。加缓存后,原本占据大头的 is_restricted_filepath 与 path_check_callback 的开销各降到了约 0.02%。路径遍历的耗时在火焰图里基本被抹平了。这种夸张的提升是以很高的场景针对性为代价的。
测试用例完美贴合了 LRU 缓存的最优工作区间。高频重复访问同一文件的负载吃满了缓存命中率。这掩盖了首次加载和缓存未命中时的额外写回成本。缓存逻辑均封装在 eBPF 内部模块,用户的策略文件无需做任何改动。架构层的解耦让性能升级对运维团队平滑透明。
缓存失效与内存代价引发社区争议
Hacker News 上的讨论迅速偏移到了缓存架构的暗面。用户 salviati 提出了关于资源置换的质问。引入 memoization 本质上是拿内存空间换取 CPU 周期。作者提供了详尽的 CPU 压测数据,却未测量那 10000 个 entry 的 LRU Hash Map 带来的内存占用情况。缺少空间复杂度的分析让这份性能报告失去了一部分说服力。
用户 Allybag 进一步拆解了 90% 降幅的成立条件。对于从不重复打开同一个文件的离散型负载,多出的一步缓存写回动作反而会拖慢整体执行速度。同一个改动既能写成降 90%,也能写成略微变慢。两种说法描述了同一枚硬币的两面。
核心的质疑集中在缓存失效机制上。brookman64k 和 gnoack 等人列出了一长串可能导致缓存污染的边缘场景。文件权限变更、目录被移动、新增硬链接或是文件被删除,都会扰乱策略。bind mount 带来的路径伪装,甚至在 NFS 上发生内核无感的重命名,都能在不改变 inode 的前提下打破原有的安全策略。
作者针对改名问题做出了回应。如果保护的是特权目录,只有高权限用户才能移动它。恶意改名在理论上缺乏前置条件。如果目录未受保护,移动它也不会触发安全规则。作者透露正在考虑加入基于目录变动事件的缓存驱逐机制,尝试覆盖更多的边界情况。
eBPF 社区对这类技术并不陌生。SELinux 早就有 Access Vector Cache 的设计。缓存策略判定结果能把内核侧 CPU 成本砍掉九成。真正难的地方在于 key 怎么选。mount namespace ID + mount ID + inode 这个三元组,把文件系统语义里所有让人睡不着觉的角落都暴露了出来。处理这些硬链接和改名引发的边缘状态,才是构建高可用安全组件的真正门槛。
参考链接:
- eBPF 安全代理:用三元组缓存砍掉 90% 开销
- Hacker News 讨论