一个开发者花了一年多时间在 z486_MiSTer 上复刻了 486 处理器,然后把目光投向了 3D 加速卡的黎明。《极品飞车 2 SE》中平滑的纹理与雾化效果,曾是他对新一代 PC 游戏的第一印象。2026 年 9 月 7 日,nand2mario 放出了 zSST——一个用 SystemVerilog 实现的 3dfx Voodoo Graphics(SST-1)。当他把这套管线和自研的 100 MHz CPU 一起塞进 Xilinx KV260 芯片里时,原本被尘封的内存设计冲突再次浮现。复刻一块 1996 年的 3D 加速卡,最大的挑战在于如何把像素喂进去。
100MHz 重构原厂逻辑
zSST 将 CPU 与渲染器同步推到 100 MHz。系统在 FPGA 里完整跑起了原版 3dfx 渲染器的《古墓丽影》。KV260 板载了充足的逻辑资源、DSP 和 DDR 带宽。它足以同时容纳宿主处理器与图形扩展模块。老旧的 DE10-Nano 早已装不下这套庞大的硬件集合。在集成设计中,zSST 消耗了约 29500 个 LUT 和 97 个 DSP slice,并在 100 MHz 下满足了时序要求。
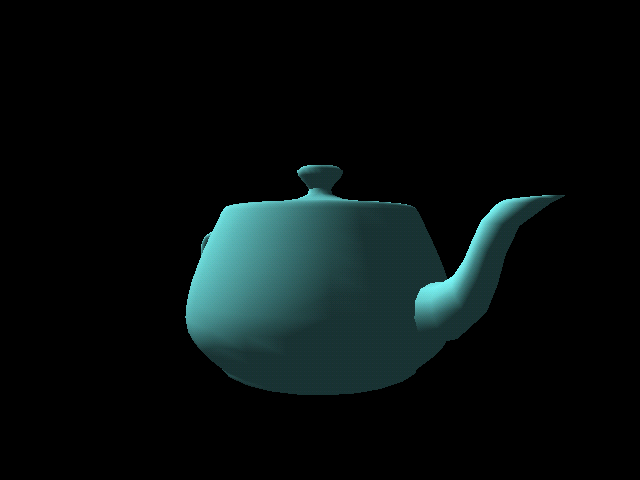 图:zSST 在仿真中渲染 Utah teapot。来源:Small Things Retro / nand2mario
这套 FPGA 实现支持了原卡的准备三角形(prepared triangles)、纹理过滤、深度与 alpha 测试、雾化以及抖动等核心特性。命令接口仅用五个主寄存器,就完成了渲染管线的控制:triangleCMD 启动一个准备好的三角形,ftriangleCMD 走浮点 setup 接口,nopCMD 冲刷管线并可选重置统计计数器,fastfillCMD 清除一个裁剪矩形的颜色或深度,swapbufferCMD 负责显示缓冲切换。两个三角形命令进入的是同一条渲染流水线,其余寄存器只管坐标、梯度与渲染状态。zSST 还同时提供了定点与浮点两套 setup 接口。定点格式将屏幕坐标 10.5 编码为整数 168(即 12.4 格式,含符号位的整数部分加 4 位小数)。颜色与 alpha 用 12.12,深度 Z 用 20.12,纹理坐标 S/W 与 T/W 用 14.18,倒数 W 用 2.30。浮点寄存器接受 IEEE 单精度值,由 SST-1 转成这套内部表示。这些小数位保留了光栅化器处理像素中心之间顶点的精度。
原版 ASIC 的流水线切分被重构以适应 FPGA 的时钟目标。zSST 的 FBI 像素通路被划分为六级流水,从准备深度值、alpha 测试,一路走到混合与帧缓冲写入。1999 年开源的 Glide 源码与 SST-1 规范,为软件如何配置像素管线指明了道路。规范提供了行为目标,具体电路实现则交给了开发者的工程直觉。
四路交织与现代妥协
原版 SST-1 将工作分给 FBI(帧缓冲接口)与 TREX(纹理映射单元)。两颗芯片在 50 MHz 下各自独享一条配有四颗 EDO RAM 的 64-bit 内存通路。这套四路交织设计让各个 bank 可以读取独立地址。系统按「列奇偶 × 行奇偶」分配 bank,确保任意 2×2 窗口恰好包含四种组合各一次。系统借此并行获取双线性过滤所需的四个无冲突邻接纹素。定制存储的物理隔离天然屏蔽了资源争用,两边合计 800 MB/s 的理论带宽被安排得井井有条。
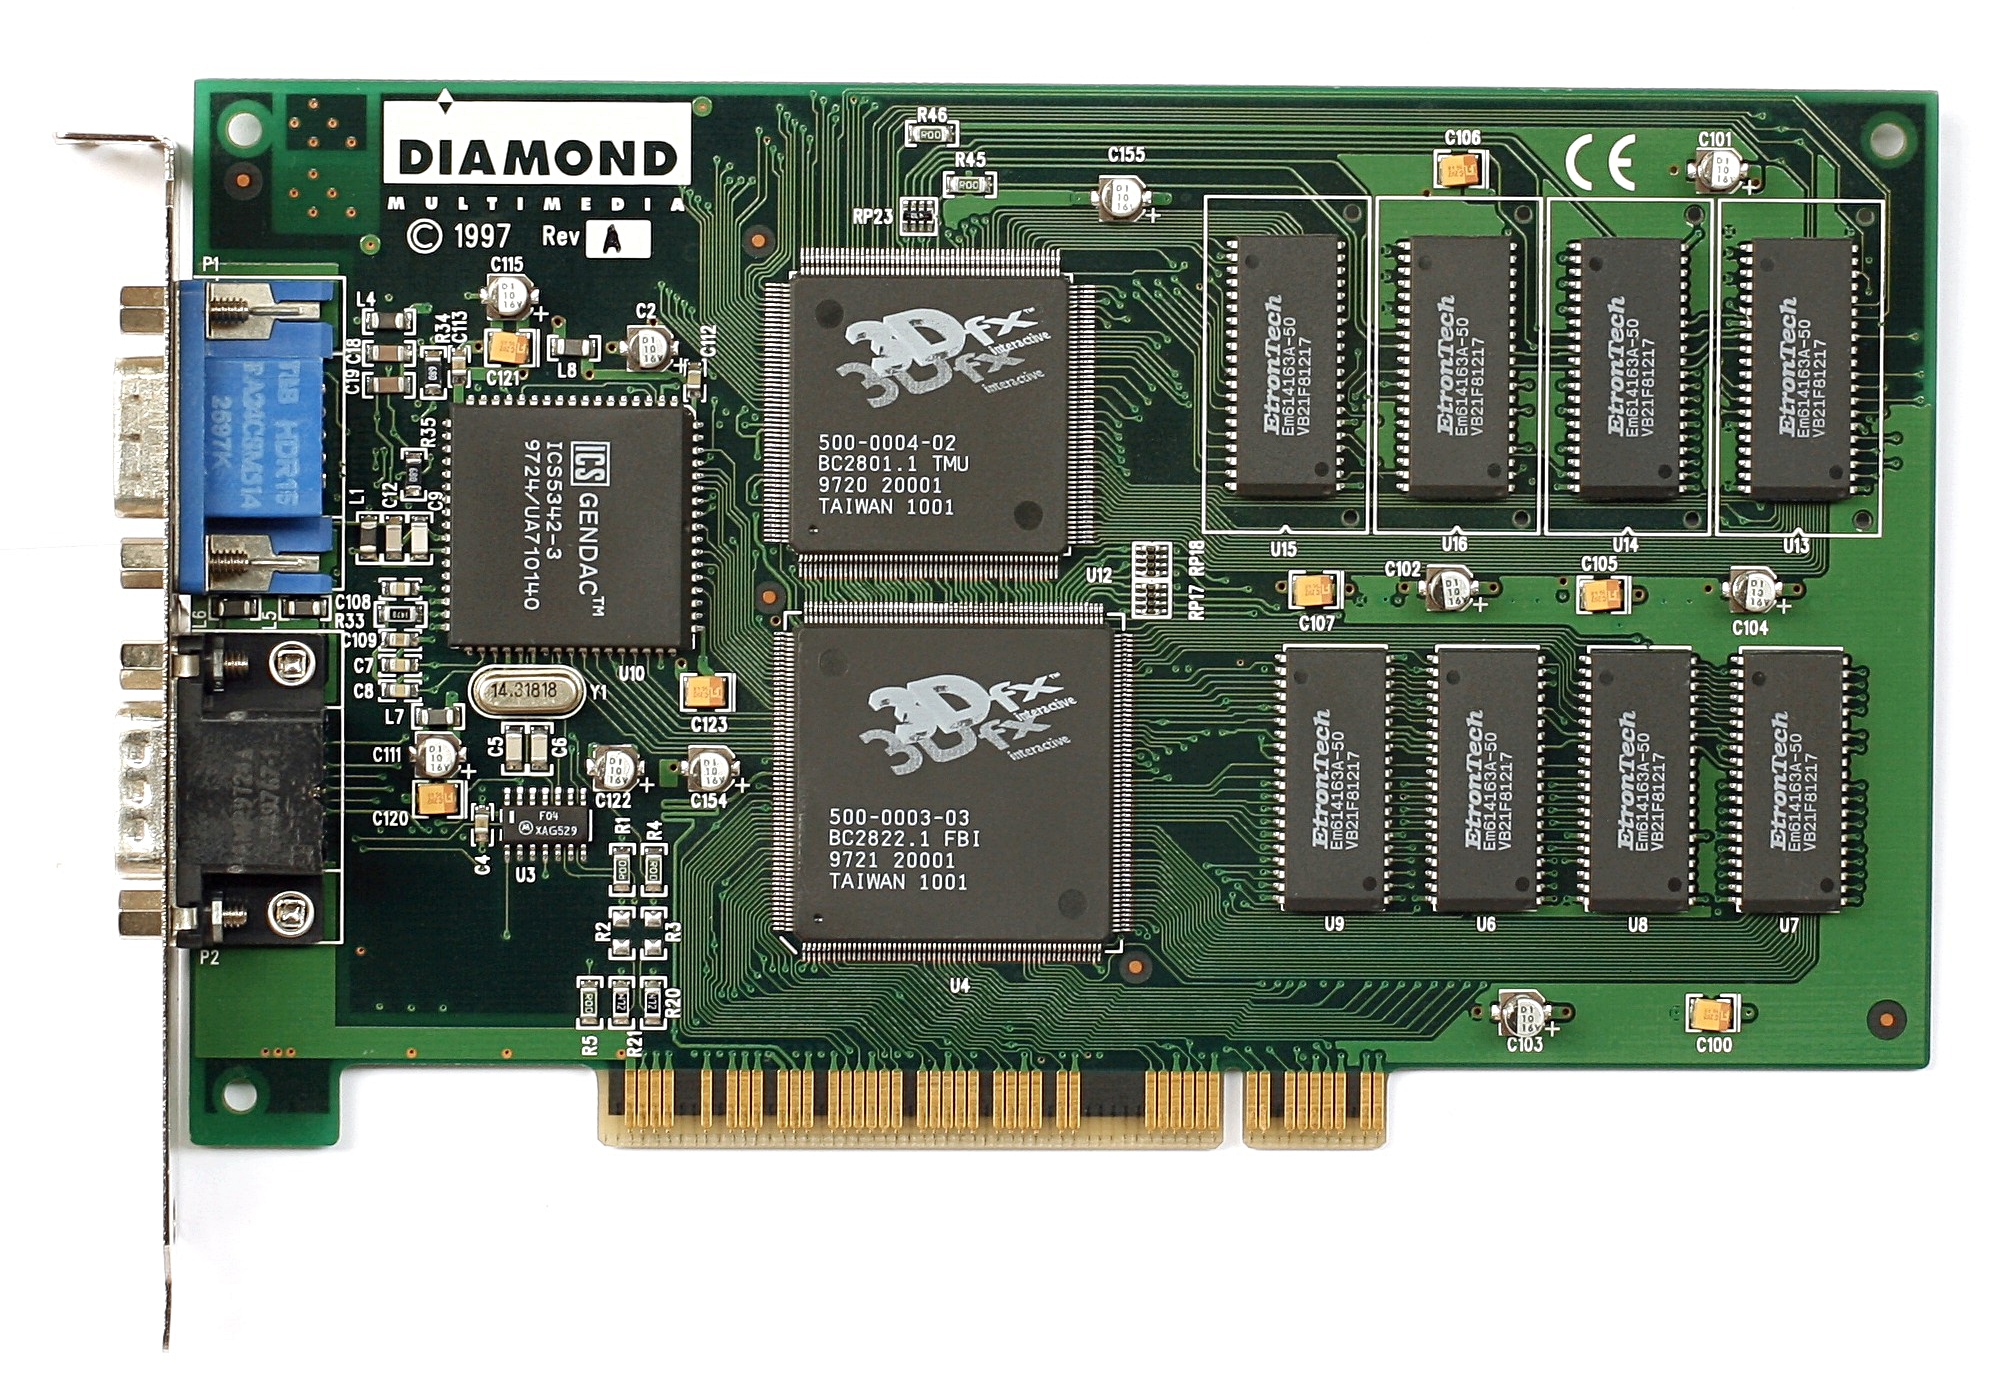 图:Diamond Monster 3D 实物板,上方 3dfx 芯片是 TMU,下方是 FBI,各自右侧四颗 EDO RAM。来源:Konstantin Lanzet 摄影、Pittigrilli 裁剪、Wikimedia Commons、GFDL 1.2+
将这套管线搬到 KV260 上,zSST 面对的是 128-bit 端口下高达 1.6 GB/s 的理论带宽。然而 64 字节单次读取的实际吞吐只有 189 MiB/s。首读常常需要等待 28 个时钟周期,偶尔还会遭遇更漫长的延迟。等每一次小额读取完成再发下一次请求,硬件的大部分时间都会空转。单条宽带的峰值数字,掩盖不了单次响应的迟缓。
为了让流水线跑起来,zSST 引入了 8 KiB 纹理缓存、重排缓冲(ROB)和重放队列。它最多保留 8 个在飞的 cache-line 抓取,将等待数据的采样停入队列,再用 64 项的 ROB 收集结果按原序释放。帧缓冲侧也使用了独立的 4 KiB 读缓存与写合并器。混合或深度测试需要获取尚未写回 DDR 的值时,系统通过 forwarding 直接供给。把固定管线塞进 SoC 里,开发者必须借用乱序执行的思路去填补 DDR 的时序黑洞。
78.5 MPix/s 测出新短板
在渲染器独立仿真测试中,100 MHz 的 zSST 对带纹理三角形跑出了 78.5 MPix/s 的吞吐。开启深度与混合后,吞吐量为 72.8 MPix/s。Voodoo 1 在 50 MHz 下的对应公布估算值分别为 43 与 37 MPix/s。作者明确指出这两组数据的基准不同。原厂数值包含了雾化和 Gouraud 着色。当前数字只划定了大致的填充率区间。
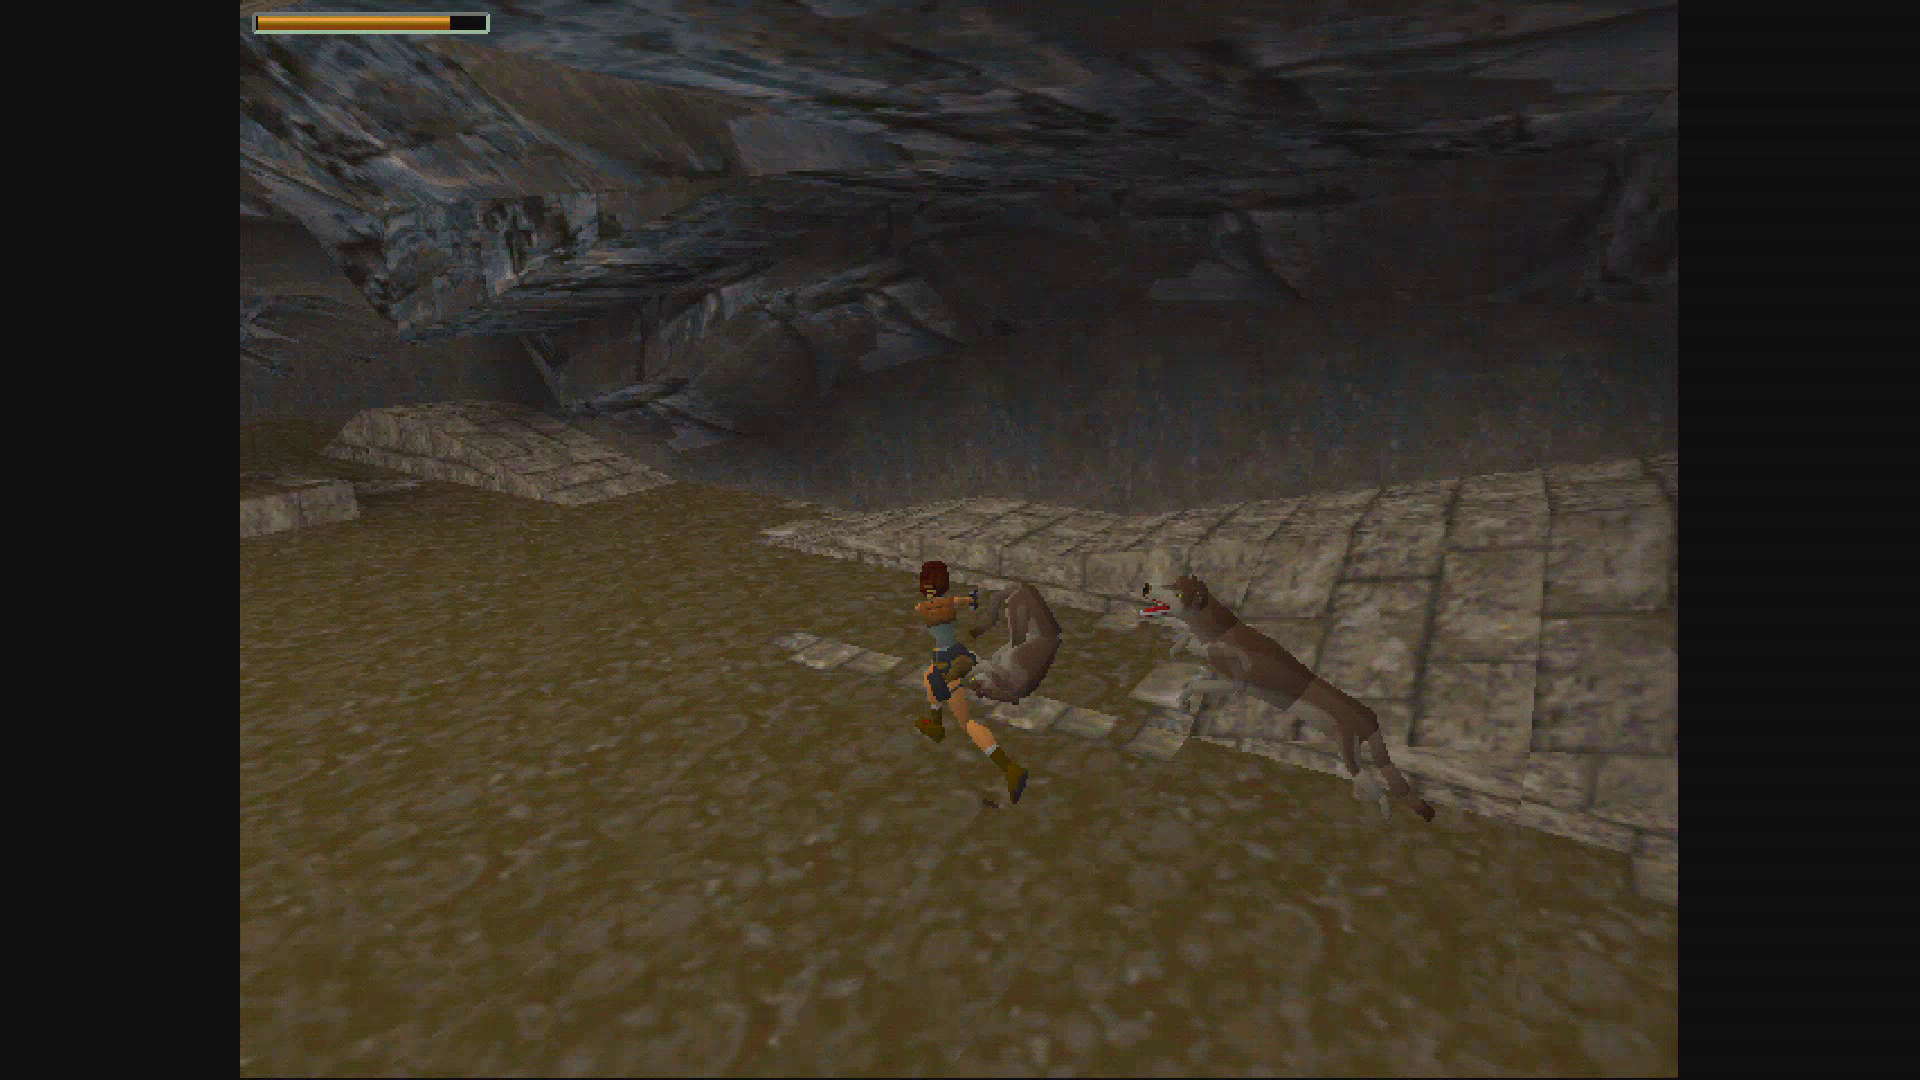 图:完整 FPGA PC 上的《古墓丽影》。来源:Small Things Retro / nand2mario
纸面的高填充率没有直接兑现为高帧率。在《古墓丽影》实测中,单关卡产生 237 次显示缓冲交换,大约每秒只有 12 次交换。SST-1 并没有硬件几何引擎。宿主 CPU 承担了所有几何变换、顶点光照和裁剪工作。非 Voodoo 游戏在 100 MHz 的 z486 XL 上表现稳定,最高细节 Doom 跑到了 38.5 FPS。图形硬件速度提上来后,木桶的短板立刻转移到了前端的几何处理与内存总线竞争上。
极限优化转向新载体
项目公布后,社区对底层 GPU 内部实现的讨论热度显著升高。针对硬件载体,支持 KV260 的开发者认为 10-15 年前的 DE10-Nano 已成性能瓶颈且溢价严重。另一些人指出在极限受限的板子上榨取性能本身也是一种乐趣。
把 Voodoo 和处理器硬塞进旧开发板的极限优化可能没有太大工程收益。但当 zSST 用缓存与队列在现代 DDR 架构上重新拼出旧管线时,原版硬件的局限性被另一种时序限制精确地验证了。固定功能管线被搬进共享总线的 SoC,像素填充算力依然不是决定性因素。内存架构的延迟与 CPU 几何调度才是永恒的边界。
参考链接:
- zSST - A 3dfx Voodoo Graphics in FPGA
- Hacker News 讨论