10万卡集群两周提速3倍
2026 年 9 月 17 日,智谱 Z.ai 公开了一组颇具冲击力的基建数据:在 10 万张以上国产 AI 加速器构成的集群上,他们从零建成了完整的生产级推理服务。GLM-5.3-Flash 的全部生产推理如今都跑在这套系统上。端到端服务性能在两周内提升约 3 倍,硬件利用效率与每 token 成本达到了与主流 NVIDIA GPU 相当的水平。
这种规模的部署面临着生态不成熟、显存容量与带宽相对有限的物理硬约束。新系统不仅要支持新模型架构,还要支撑高达 1M token 的上下文窗口和多模态请求。面对 kernel 支持不完整、该有文档的地方大多靠猜的残局,常规的人工工程推进节奏注定无法匹配前沿模型的迭代速度。
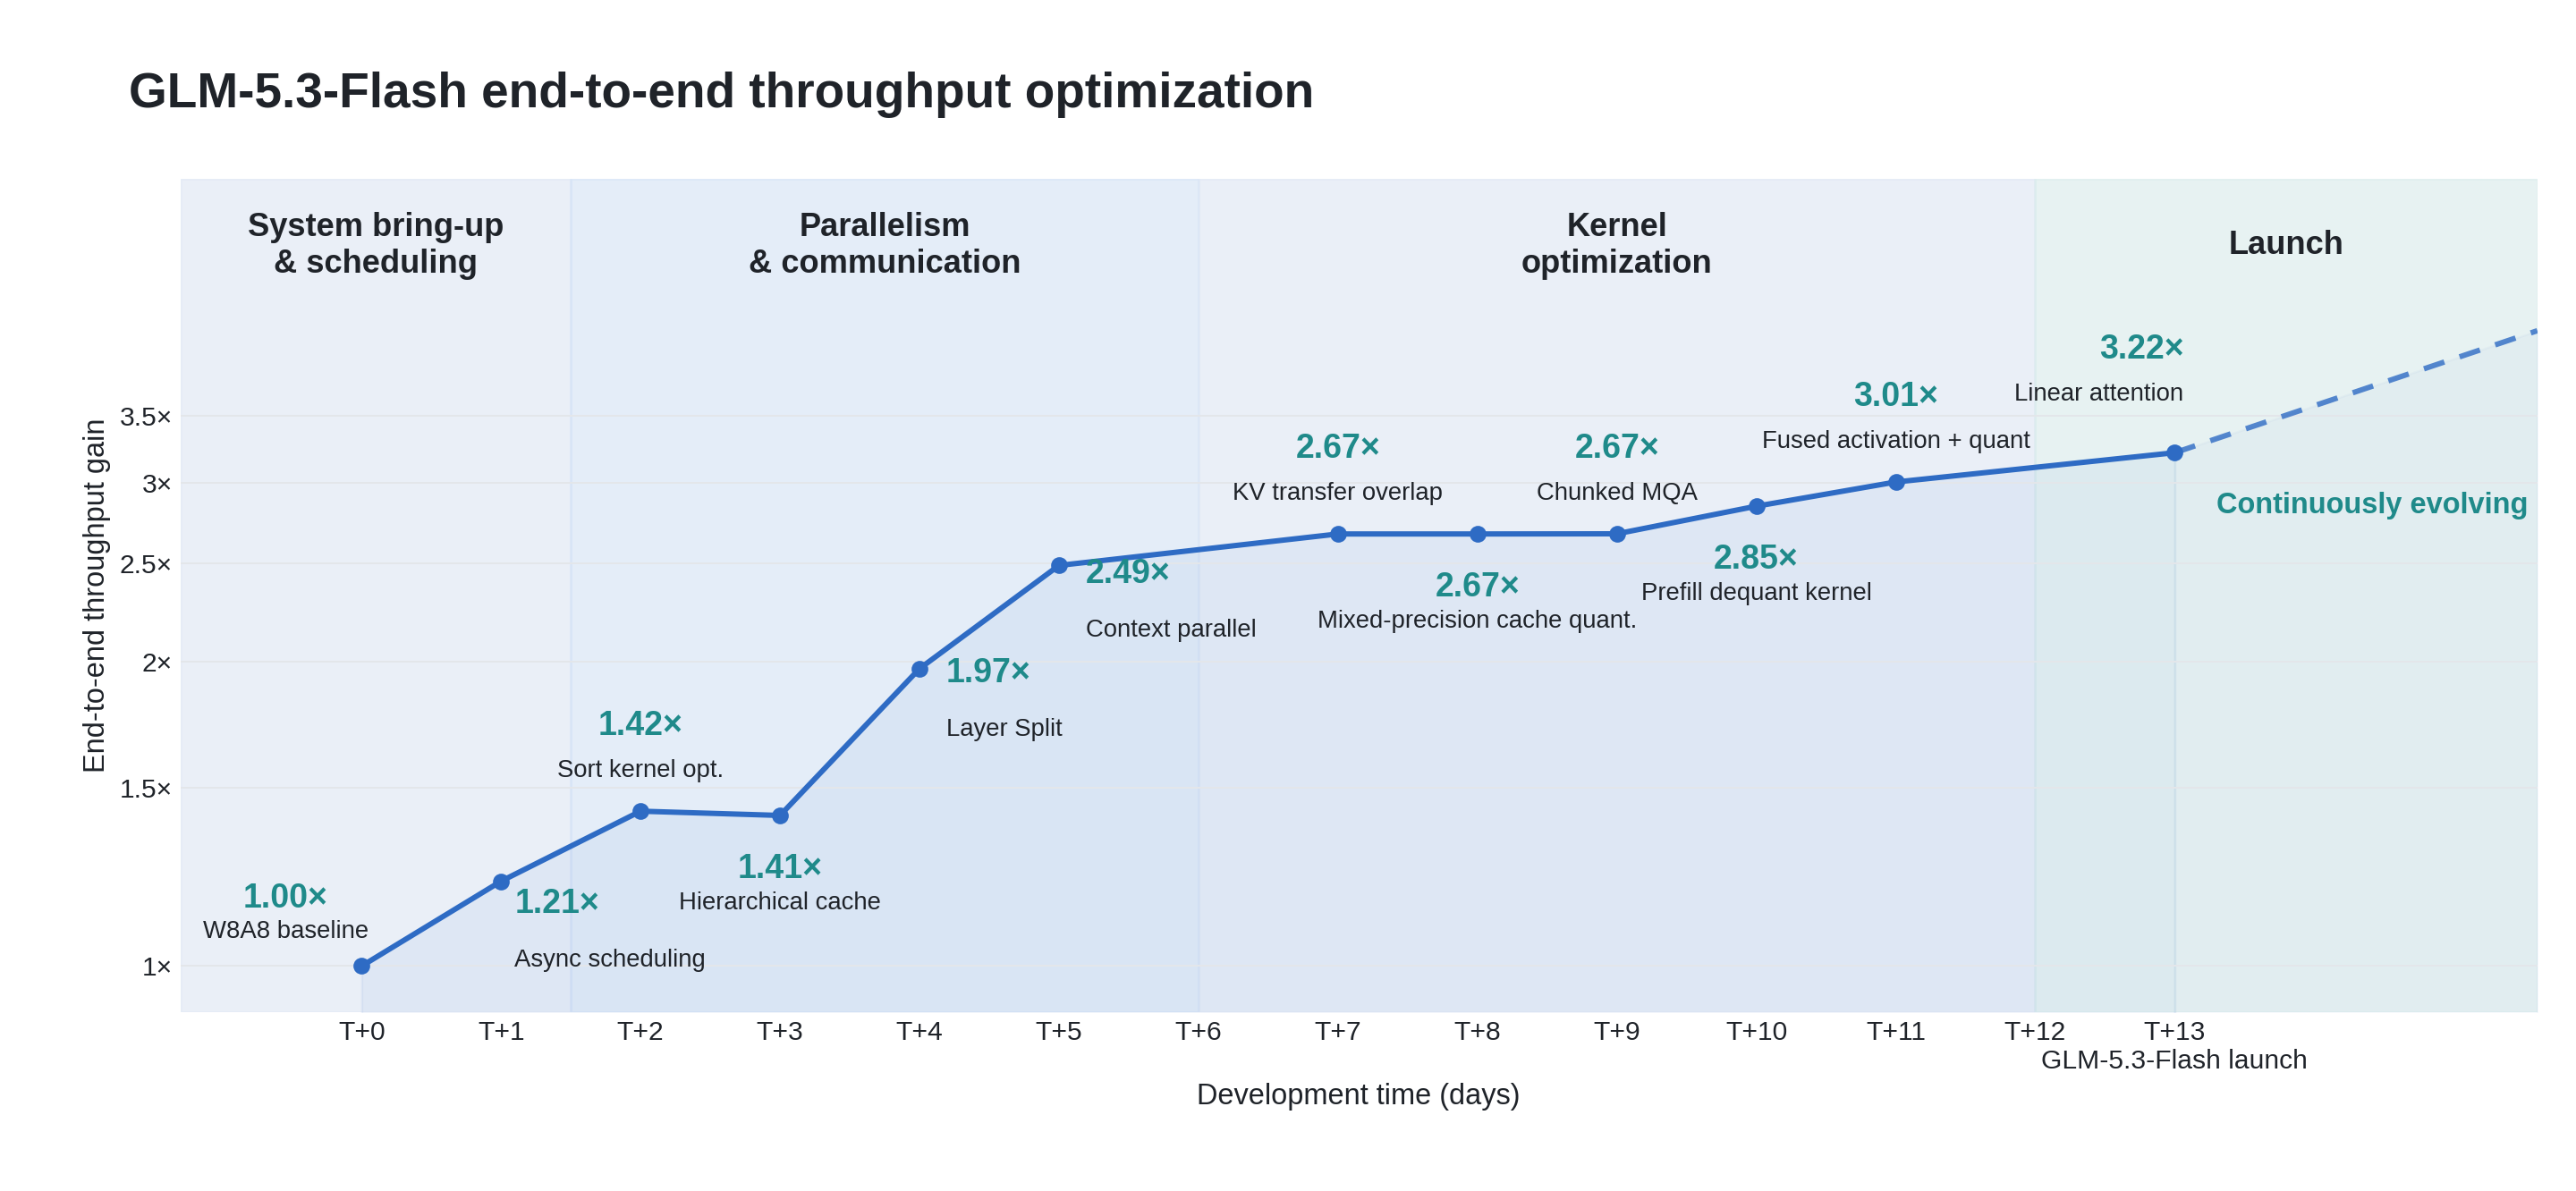 图:GLM-5.3-Flash 从首次跑通到生产上线的端到端吞吐演化曲线。来源:Z.ai 官方博客
破局者是 GLM-5.3 驱动的 Infra Agent,它在不到两周时间内跑通了从初始模型适配到具备生产就绪状态的全流程。GLM-5.3-Flash 随后以匿名模型名 Ox-Alpha 在 OpenCode 与 OpenRouter 上接受真实流量测试,上线六天处理超过 62 万亿 token,一跃成为两个平台上使用量最高的模型。AI 在算力迁移和底层优化上的参与度,已经实质性地接管了生产级系统的核心调优工作。
建立可归因反馈回路,把端到端指标拆碎
让 agent 在系统工程里真正干活的关键,并不是其模型代码写得有多完美。光靠「数值精度测试失败」或「输出吞吐下降 20%」这类稀疏的端到端反馈,agent 根本无法定位是哪一层的逻辑出了问题。端到端指标只能粗略地提示结果的恶化,无法解释具体的失败机理。
智谱给出了一套可复用的工程配方:把 correctness tests、runtime logs、execution traces 等颗粒度细碎的信号,统一纳入 agent 的日常迭代工作流。他们将这套机制总结为「稠密反馈」,其核心特征是足够局部、获取成本低且支持客观验证。每次改动都能精确绑定到具体的引擎启动参数、代码改动或线程上,内核测试能回答的问题,就不需要每次都上全服务部署进行端到端压测。
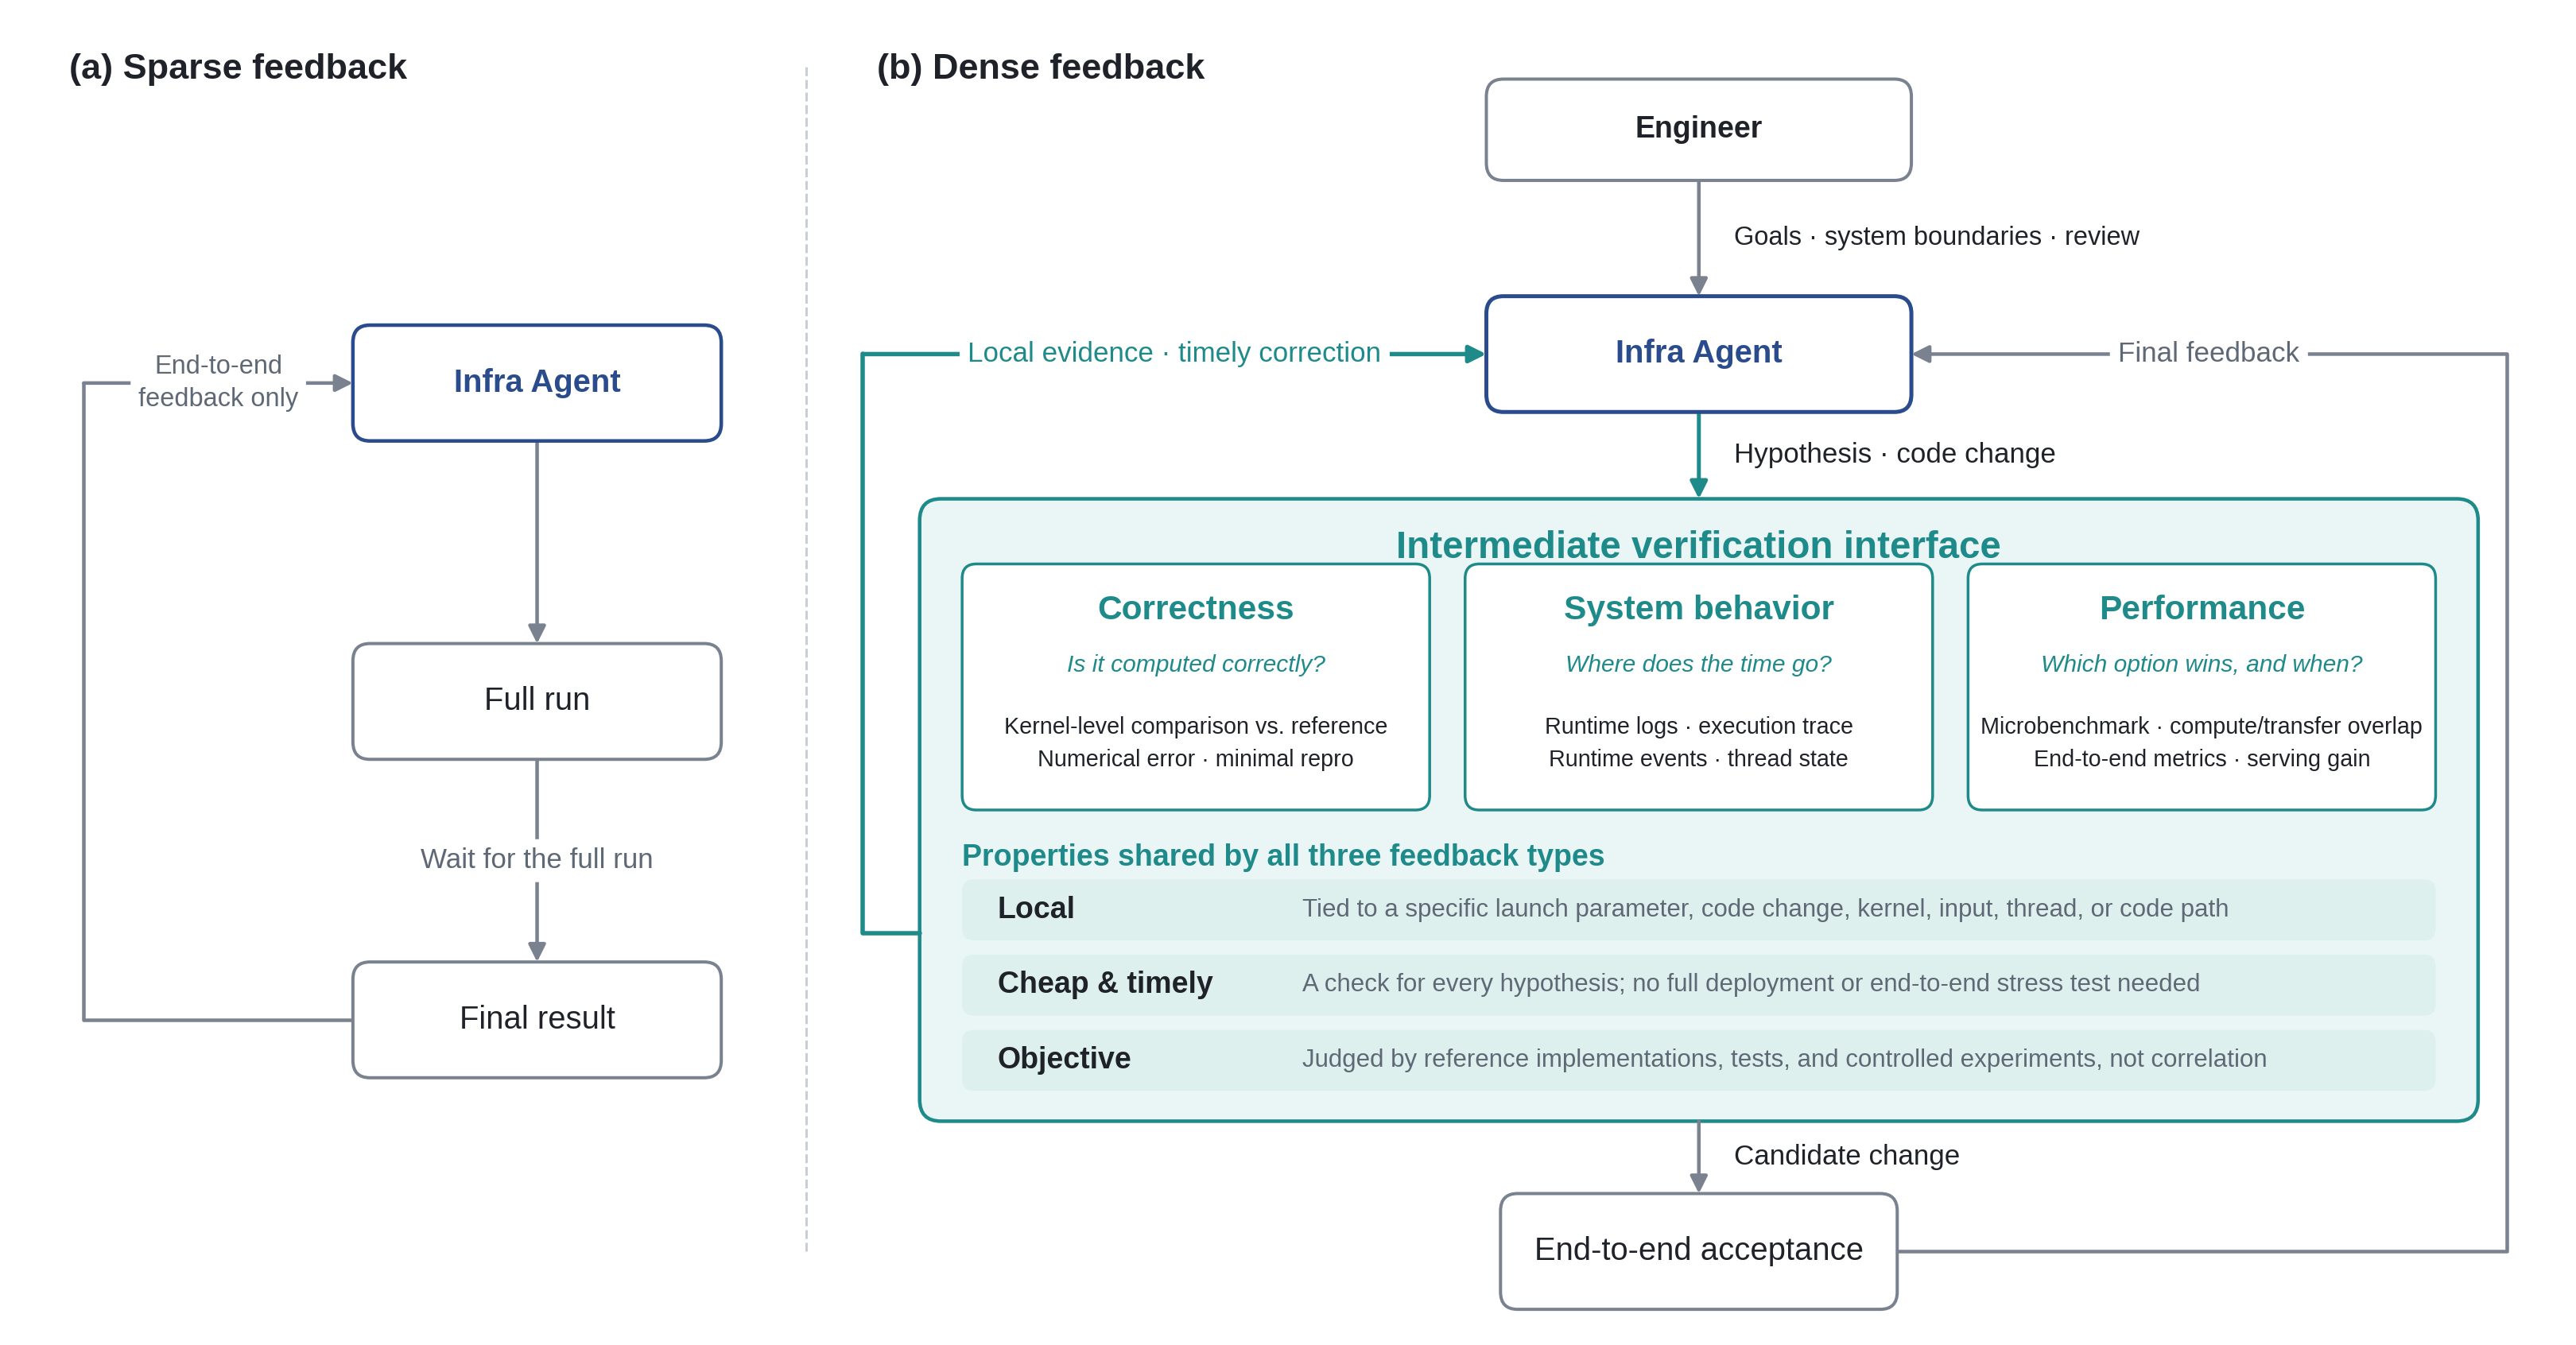 图:围绕稠密反馈搭建的 Infra Agent 优化回路。来源:Z.ai 官方博客
这三种维度的反馈分别精准解答了不同的工程疑点。正确性反馈回答「算得对不对」,系统行为反馈回答「时间花在哪里」,性能反馈回答「哪种做法更好、在什么条件下更好」。只有当系统能以极低成本持续回答这三个问题时,大模型才能从盲目的代码生成器,转变为能稳定推进工程进展的架构师。
算得对还要算得快:三次TF32解决精度灾难
稠密反馈的威力在具体的系统问题排查中显露无疑。在 KDA kernel 的验证过程中,agent 发现 Context Parallelism 路径存在微妙的数值精度问题。原实现中 tl.dot 在处理 FP32 输入时默认使用 TF32 计算,这种精度偏差在长上下文处理中会导致严重的变换合并与状态更新误差累积。
修复方案摒弃了复杂的重构,直接给两个运算显式设置 input_precision="tf32x3",用三次 TF32 Tensor Core 运算换取更高的数值精度。这个小巧且致命的修复随后被迅速合入了 Flash Linear Attention 上游。在具备客观校验环境的条件下,agent 已经能熟练处理底层 kernel 的精度顽疾。
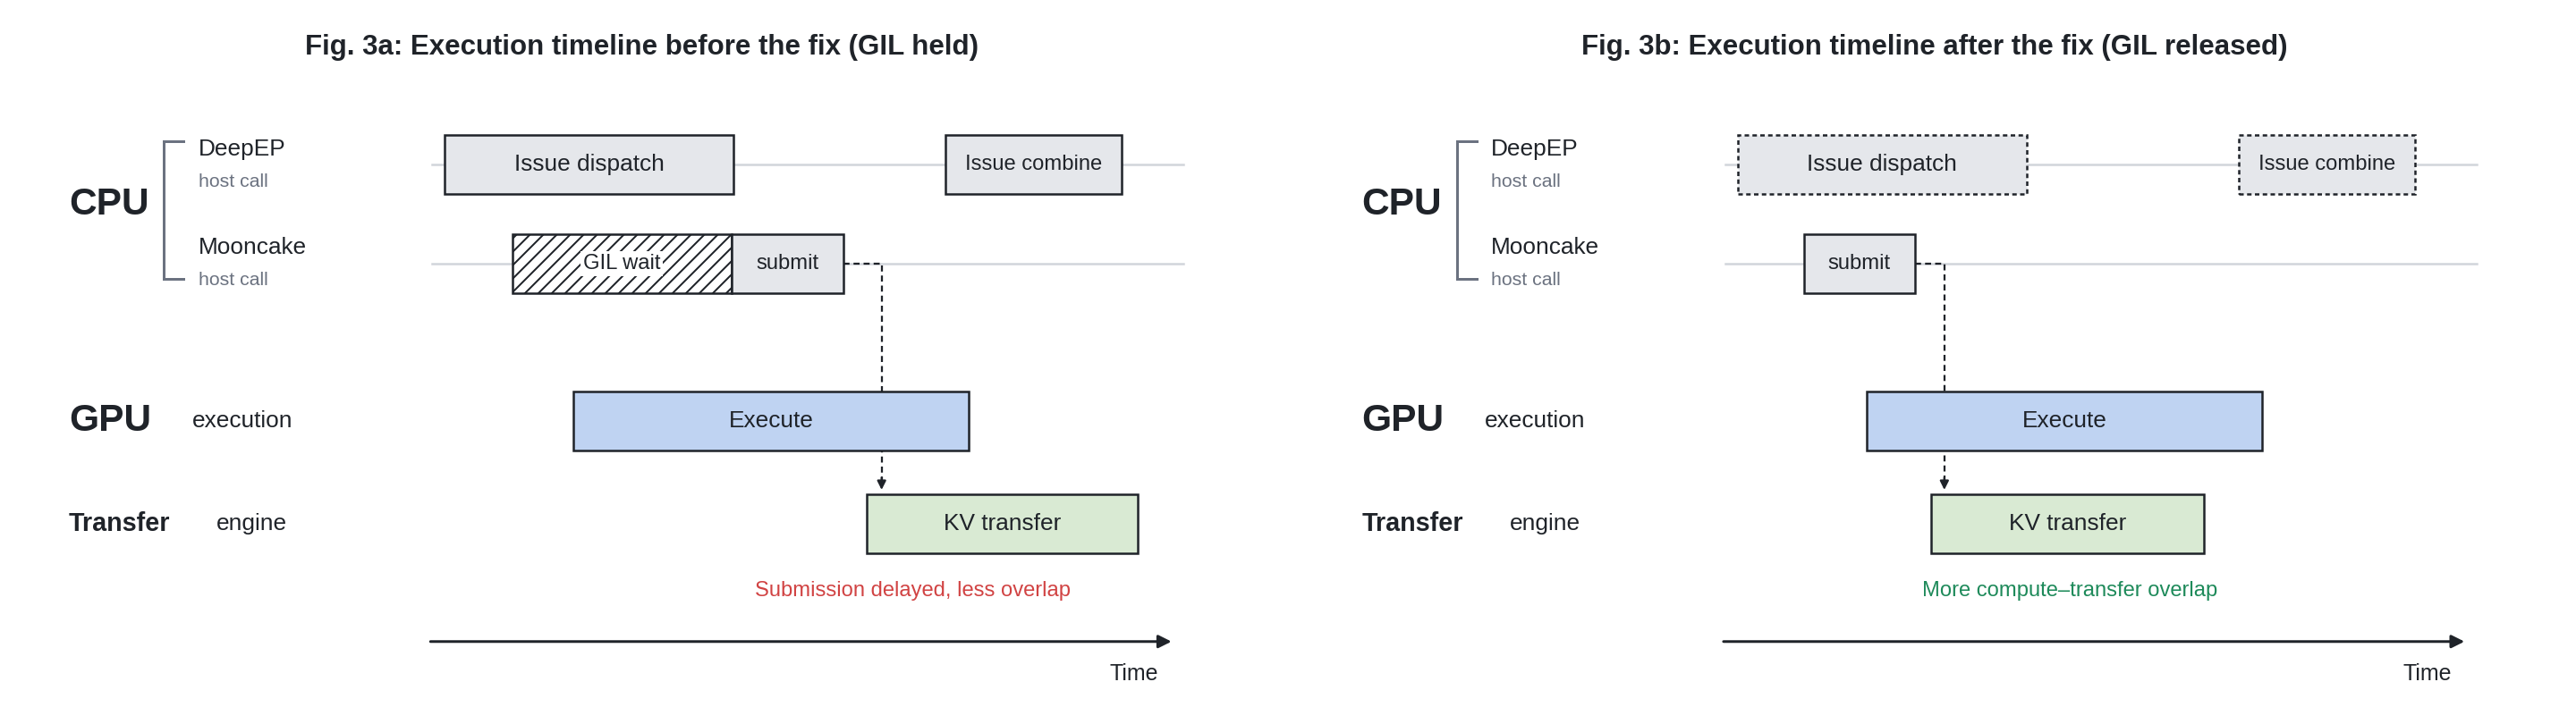 图:KV Transfer 并发瓶颈的发现与修复。来源:Z.ai 官方博客
在系统行为的优化上,工程师设定了 Prefill + KV Transfer 与纯 Prefill 性能差距不超过 5% 的严格验收标准。Agent 顺着 KV Transfer 时间线排查发现,DeepEP v1.2.1 的 intranode_dispatch 等调用没有显式释放 Python GIL,导致 CPU 在等待 GPU 返回时阻塞了其他线程的 KV Transfer。修复这个 C++ 与 Python 边界的并发问题后,性能差距从 20% 以上骤降至 1% 以内。哪怕是资深工程师面对这种深埋的阻塞,也需要耗费大量时间排查 trace,而 agent 通过确定的验收路径实现了自动化归因。
凝练优化骨架,牺牲并行度换取1.71倍加速
在解决基础的正确性和并发问题后,agent 进入了性能优化的更深层。它系统性地从 SGLang、Flash Linear Attention、DeepGEMM 等手写 kernel 中提取优化技巧,沉淀为带有明确适用条件、变换方法和验证证据的「optimization skeletons」。这为 agent 建立了一个可执行、可检验的工程规则集。
在优化代表性 KDA Decode kernel 时,agent 的决策过程展示了冷酷的算力权衡。它首先引入 ReplaySSM 以算力换取内存,即便这一步操作导致初始阶段执行时间有所上升。随后收到「计算是主要瓶颈」的确定性反馈,它果断对沿 V 维度分块导致的冗余计算动刀,把这些块强制合并进单个 thread block。
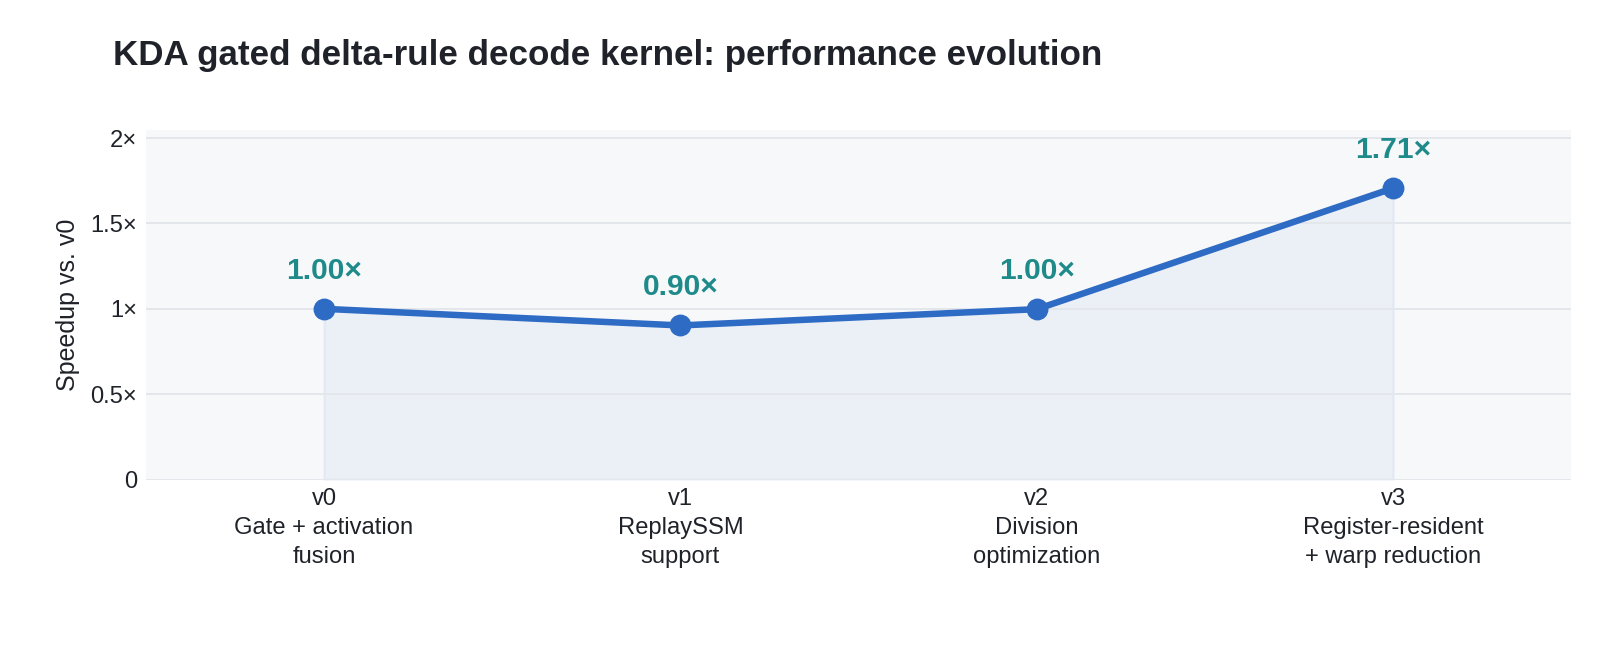 图:代表性 KDA Decode kernel 从基线到生产版本的性能演化。来源:Z.ai 官方博客
通过将共享中间结果保留在寄存器中,并使用一次 warp-level reduction 替换逐块计算,agent 以牺牲部分并行度为代价消除了四次重复的 FP32 归一化与门控计算。这一系列操作最终获得了相对 v2 版本 1.71 倍的加速。机器掌握了在算力、内存和并行度之间做精细权衡的工程直觉,并且这种直觉被成功量化写进了生产环境的代码中。
工程师退守目标定义,递归演进引发社区激辩
在这套自动化的新基建中,人类工程师的物理角色正在发生不可逆的退守。工程师的核心职责已经被明确收敛为三项:定义优化目标与系统约束,搭建能提供稠密反馈的测试运行环境,以及评审涉及异步并发与生产风险的关键架构改动。执行细节和海量试错的脏活,被完整移交给了机器。
尽管智谱在文中明确表示当前尚未达到递归自我改进(RSI),选择目标和评估风险仍然是人类的责任,但这种工程趋势已经在技术社区引发了猛烈的路线分歧。在 Hacker News 上,有开发者激烈地批评原文对进展的描述,认为其中涉及 RSI 前景的段落是不切实际的幻想。而另一派则强势反问,面对两周提速三倍的客观改进数据,为什么探讨 RSI 的临近会被视作疯话。
与技术路线争议平行的,是市场侧对算力成本的敏感捕捉。部分开发者指出 API 订阅费用的近期上涨,最低档和中间档分别达到约 20 美元和 80 美元每月,推测这种迅猛扩张背后可能撞上了严苛的算力扩展墙。但无论是将 RSI 视为工程必然还是营销话术,10 万卡集群被自动化工具接管的数据就摆在桌面上。当稠密反馈回路建成,系统在物理极限前的演进速度,不再受限于人类工程师的疲劳周期。
参考链接:
- Z.ai 官方博客
- Hacker News 讨论