2026 年 9 月 17 日 19 点 03 分,小米 mimo.xiaomi.com/rl 页面上的总消耗金额跳到了 1,447,530 美元。从 9 月 16 日 04:00 UTC 开始,小米 MiMo 团队把两套模型的强化学习训练流水线直接挂在了公网,页面只有一句「We are streaming our RL big runs. The mimo-v2.6 series is coming soon」,并在页脚写上了「Open is what we value.」。大厂放弃传统的新闻稿,把机密级别的训练指标实时公开,是一种粗暴的技术肌肉展示。
144 万美元算力账单直通公网
高昂的账单在前端页面以每秒可见的速度跳动。根据页面记录,mimo-v2.6-pro 版本从 9 月 15 日 10:32 UTC 启动。目前该版本已经跑到 step 14,历时 2 天 0 分 32 秒。它烧掉了 997,750 美元,消耗 30.2B tokens 并训练了 351k 样本。并行的 mimo-v2.6-flash 版本从同一天 15:16 UTC 启动。跑到 step 18 时耗时 1 天 19 小时 48 分,总共耗资 450,197 美元。该阶段共消耗 43.1B tokens 与 452k 样本。前端面板不仅挂载了基础信息,还把训练批次容量明确标注为 1,568 乘以 16 seqs。
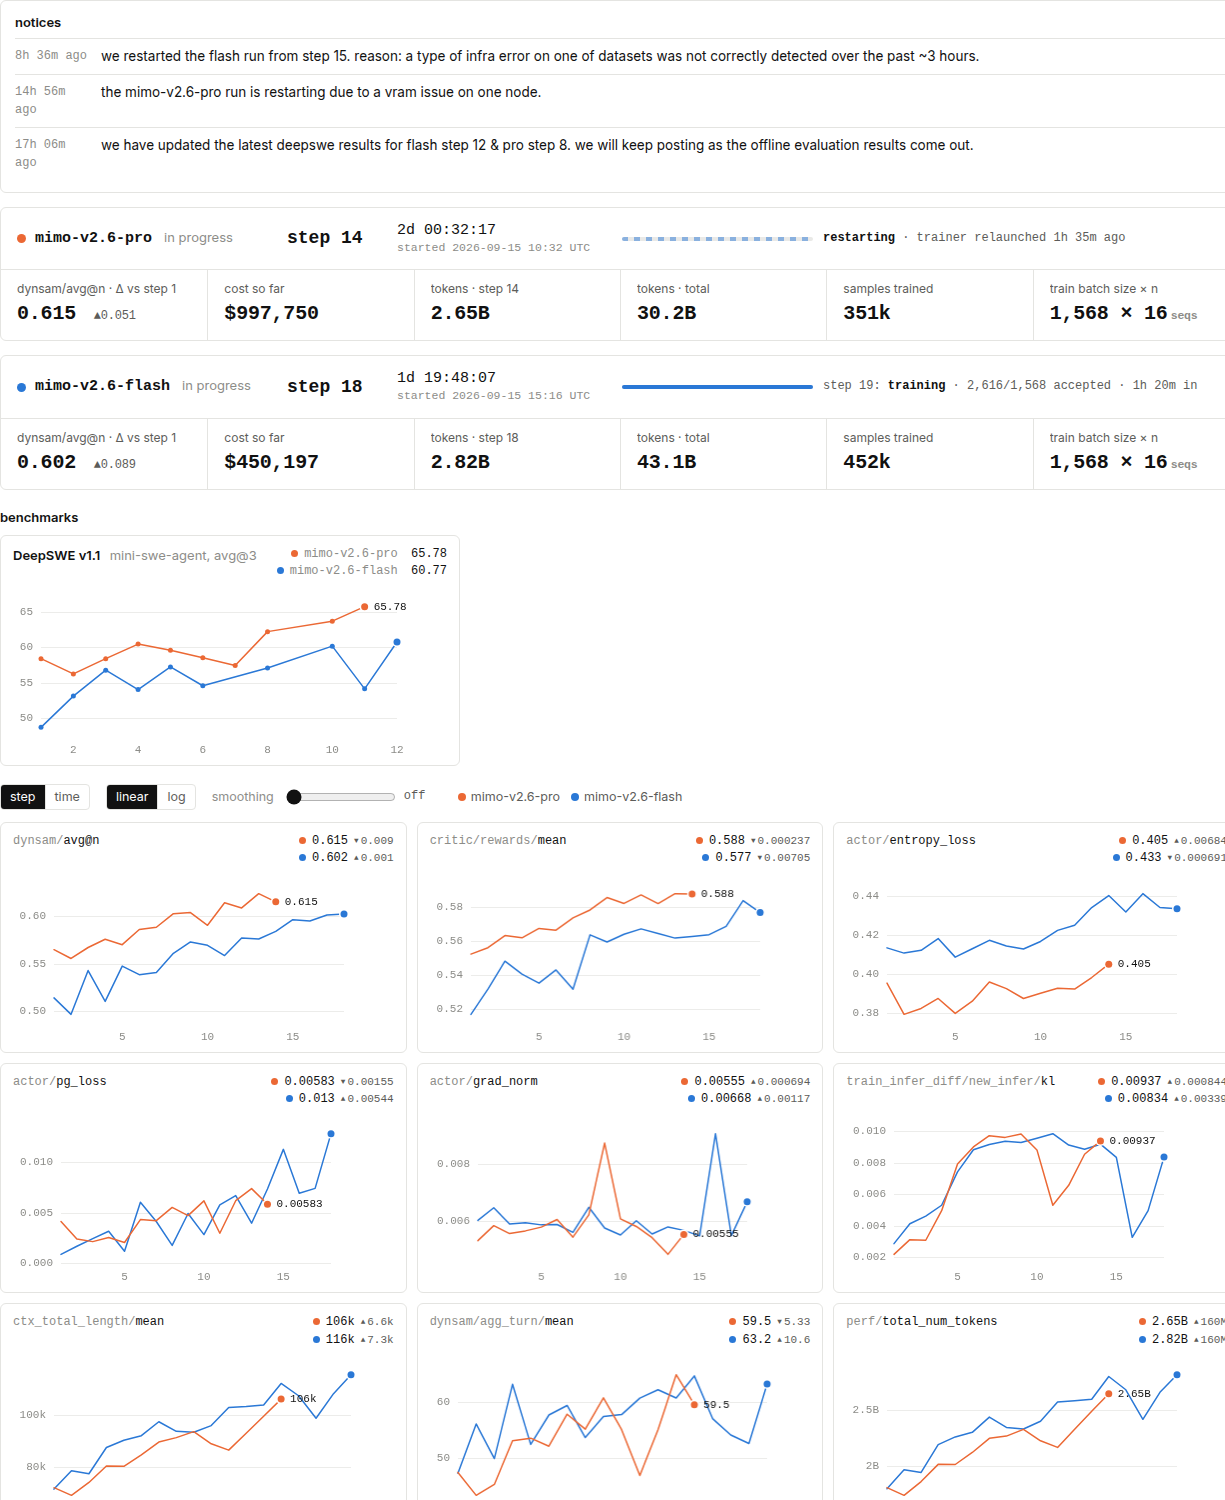 图:notices 故障公告、两条 run 的 step/成本/token 数,以及 DeepSWE 曲线与 dynsam、critic/rewards 等实时曲线。来源:mimo.xiaomi.com/rl
Hacker News 的技术社区迅速把这笔账算到了硬件维度。用户 ttul 按当时 120 万美元的总金额折算,指出训练成本高达每秒 5 美元,相当于每天烧掉 43.2 万美元,这笔钱足够在 Modal 平台上长期租用 3000 个 B300 节点。用户 ss n2000 也在一条 122 条回复的讨论串中追问背后的硬件资源分配和模型算力利用率(MFU)。动辄百万美元的首日成本撕破了算力便宜的错觉,终端模型进入后期阶段后,门票价格依然高不可攀。
社区对这种罕见做法的反馈非常统一,开发者 nikcub 将其评价为在高度保密和竞争激烈的 AI 行业中展现了标志性的透明度。这种把计费表作为产品预热的方式,远比任何技术白皮书都有说服力。展示实打实的账单,就在告诉整个开发者生态,团队拥有能烧穿百万美金的稳定现金流和充沛的集群支撑。
从 19 分跃升至 65 分仅用 14 个步长
烧掉百万美金换来的是能力指标的陡峭拉升。开发者 ricardobeat 在社区放出了残酷的对照组数据:上一代 Mimo-v2.5-Pro 在 DeepSWE 1.1 的 mini-swe-agent avg@3 评测中只拿到 19% 的分数。而如今面板上的 mimo-v2.6-pro 仅仅跑到 step 14,DeepSWE 分数就已经飙升到了 65.78,同期的 flash 版本也拿到了 60.77。跨代际的能力跃迁在几十个小时内被压缩到了区区十几个 step 里,这是后期反馈机制对推理上限暴力拉升的典型结果。
在这条陡峭的曲线上,各项细分指标都在同频共振。面板数据显示,两条线的 dynsam/avg@n 采样得分都在稳步增长,pro 提升 0.051 达到 0.615,flash 提升 0.089 达到 0.602。持续围观的 Cookingboy 抓取到了关键节点的切片,记录到 pro 版本在 step 10 时就已经越过了 63.7% 的大关。按步长呈现的性能阶梯,把参数缩放的黑盒变成了肉眼可见的物理规律。
不过要触碰第一梯队的天花板,这段路依然拥挤。目前的 DeepSWE v1.1 榜单头部被 gpt-6-astra、gemini-3.8-flash 和 claude-opus-5 以 74% 的成绩锁死,开源界的 Fable 拿到 70%,国内的 kimi-k3 和 glm-5.3 也在 69%,glm-5.3-flash 则卡在 63%。mimo-v2.6-pro 当前的 65.78 与行业主流阵列身位重叠。在前沿模型底层认知趋同的今天,用特定的样本集进行海量试错,已经成为厂商刷榜的标准化流水线。
1.39% 基础设施错误吃掉 3 小时算力
看板并没有掩饰训练系统在庞大负载下的脆弱。在 notices 公告板上,时间戳为 8 小时 35 分钟前的日志记录了一次严重的宕机事件:由于一类数据集的基础设施错误在约 3 小时内没被正确检出,团队被迫将 flash 版本从 step 15 整个推倒重跑。在另一边,14 小时 55 分钟前的公告显示 pro 版本也因为某节点的显存问题触发了全网重启,状态栏直接挂着「restarting · trainer relaunched 1h 34m ago」。
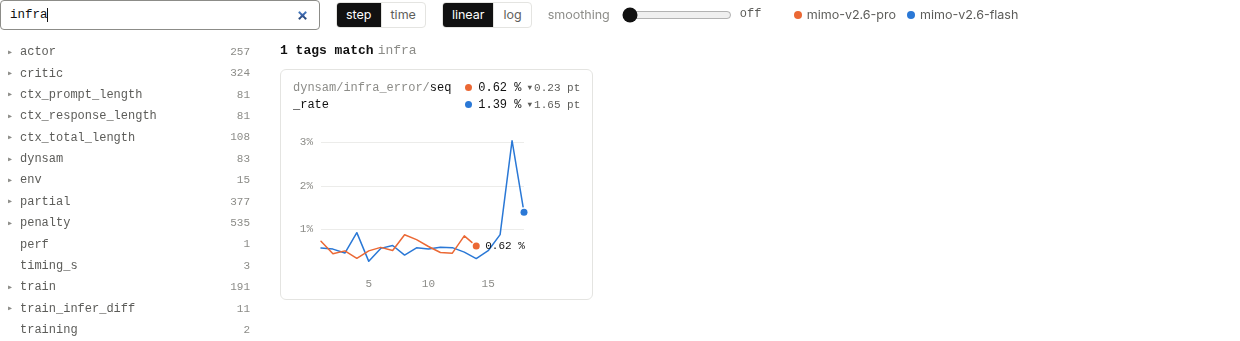 图:指标树里搜索 infra 命中的 dynsam/infra_error/seq_rate 曲线,flash 曲线在末尾有一次约 3% 的尖峰。来源:mimo.xiaomi.com/rl
隐藏在这些事故背后的是具体的红线指标。在指标树 2069 个 tag 中精确检索 infra,可以看到 dynsam/infra_error/seq_rate 曲线,pro 版本目前维持在 0.62% 并在下降了 0.23pt,而 flash 版本虽然下降 1.65pt 仍处于 1.39% 的高位,并在该节点末尾出现了一次约 3% 的错误尖峰。个位数甚至小数点的错误率在万卡互联的环境里会被无限放大,一次轻微的网络抖动就能引发整个批次的废算。
这种颗粒度极细的标签监控是排查崩溃的唯一手段。大盘左侧的导航列出了令人头皮发麻的指标树:actor 节点 257 项、critic 节点 324 项,各类 penalty 占了 535 项。针对 ctx_prompt_length 和 ctx_response_length 也各有 81 项打点,连 ctx_total_length 都有 108 项。此外还有 env 15 项、perf 1 项、timing_s 3 项和 training 2 项。没有上千个高频信号组成的探针网,工程师面对显存泄漏的黑屏就如同在夜间盲飞。
2656 个接受样本击穿原始批次上限
在动态采样器流水线日志中,记录了节点过载的真实形态。前端最新滚动的日志显示:「accepted 2,656/1,568 · judged 2,505 · pass 0.593 (n=10,393) · remaining 185 +881 partial +321 rewarding · prewarm 286」。面板中 flash step 19 的状态栏也记录了在 1 小时 20 分钟时达成「2,616/1,568 accepted」。实际接受的样本数远大于 1,568 的基准批次,系统被迫采用了过采样机制来填补高质量数据的缺口。
为了从海量噪声中榨取这几千个有效样本,前端推断集群承受了数十倍的工作量。日志里的 n=10,393 说明奖励模型对一万多个候选答案进行了打分,但通过率仅为 0.593。剩余队列里更是堆积着 185 个常规任务,881 个 partial 片段以及 321 个 rewarding 任务。在防范奖励作弊的博弈中,算力的主战场已经从单纯的梯度下降,向并行生成与筛选偏移。
处理那些不完整或特殊的代码片段,拉扯出了独立且复杂的评估分支。性能面板里的 train 分支有 191 项指标,但针对 partial 任务多达 377 项,还有专门监测训练和推断差异的 train_infer_diff 11 项,以及 dynsam 本身的 83 项。代码生成的试错往往需要在中间环节及时打断或者给出中间分,这种补偿机制直接抬升了推理管道的搭建成本。
插入主干评测集引爆路线争论
17 小时 5 分钟前的一条公告,点燃了开源社区最敏感的神经。团队宣布更新了 flash 和 pro 版本的最新 DeepSWE 结果,并承诺会随离线评测持续滚动,这种将核心 benchmark 榜单直接嵌入训练生命周期的行为,在 HN 上引发了关于数据集污染的大规模争论。用户 liuliu 和 jampekka 针对在训练间隙跑评测是否等于透题展开交锋。jampekka 认为将其用作早停的危害远不及直接灌入训练集,但这必定会引导出一条特化打榜的歪路。
在实战维度的风评,同样呈现出两极分化的态势。支持者 joelwallis 透露在日常工作里使用 2.5 代的体验极佳,甚至在智能质量上已经能够比肩 Anthropic 的模型,且成本令人难以置信的低。而在 OpenRouter 的免费生态里,ricardobeat 也证实 Mimo v2.5 Pro Ultraspeed beta 曾经飙到 1000 tok/s。但反对者 walrus01 认为 2.5 版本在面对基础任务时非常迟钝,与 qwen 3.8-flash-next 存在代差,速度再快也无法掩盖常识性错误的缺陷。
不论是打榜的捷径还是能力的质变,小米将这一切连同内部的故障面板全盘推给了公网。这种做法直接撕开了模型厂商长期以来的测试海报黑幕。当 2.6 系列把算力的消耗曲线和工程报错毫无保留地展示给所有人,前沿竞争的规则已经从 PPT 宣发变成了工程纪实的直播。
参考链接:
- We are streaming our RL big runs
- HN: Xiaomi streams mimo-v2.6 RL big runs on dashboard