11328个小篆挤占87%更新配额
Unicode 18.0 的更新日志中有一组刺眼数字。本次新增字符中包含 11328 个小篆字符。它占据了全部新增字符约 87% 的名额。相比之下,广受关注的 Emoji 仅增加了 9 个。
标准委员会把绝大多数编码空间留给两千年前的死文字。这在现代软件工程界极少见。小篆曾由秦始皇推行,完成过中国历史上第一次统一文字。两千年后,它在现代计算机统一字符集中拿到了最大的一块版图。
维护者的工作目标已经变了。他们不仅满足现代互联网高频交流需求。他们更把 Unicode 当成全部人类表意符号的档案馆。
数字化古籍跳出私有字库陷阱
处理小篆等古汉字曾是开发者的一场灾难。过去想要在网页中展示一段篆书文献,通常面临两种妥协。一种是把文字切片存成图片。另一种是依赖特定机构发放的私有编码字体文件(PUA)。
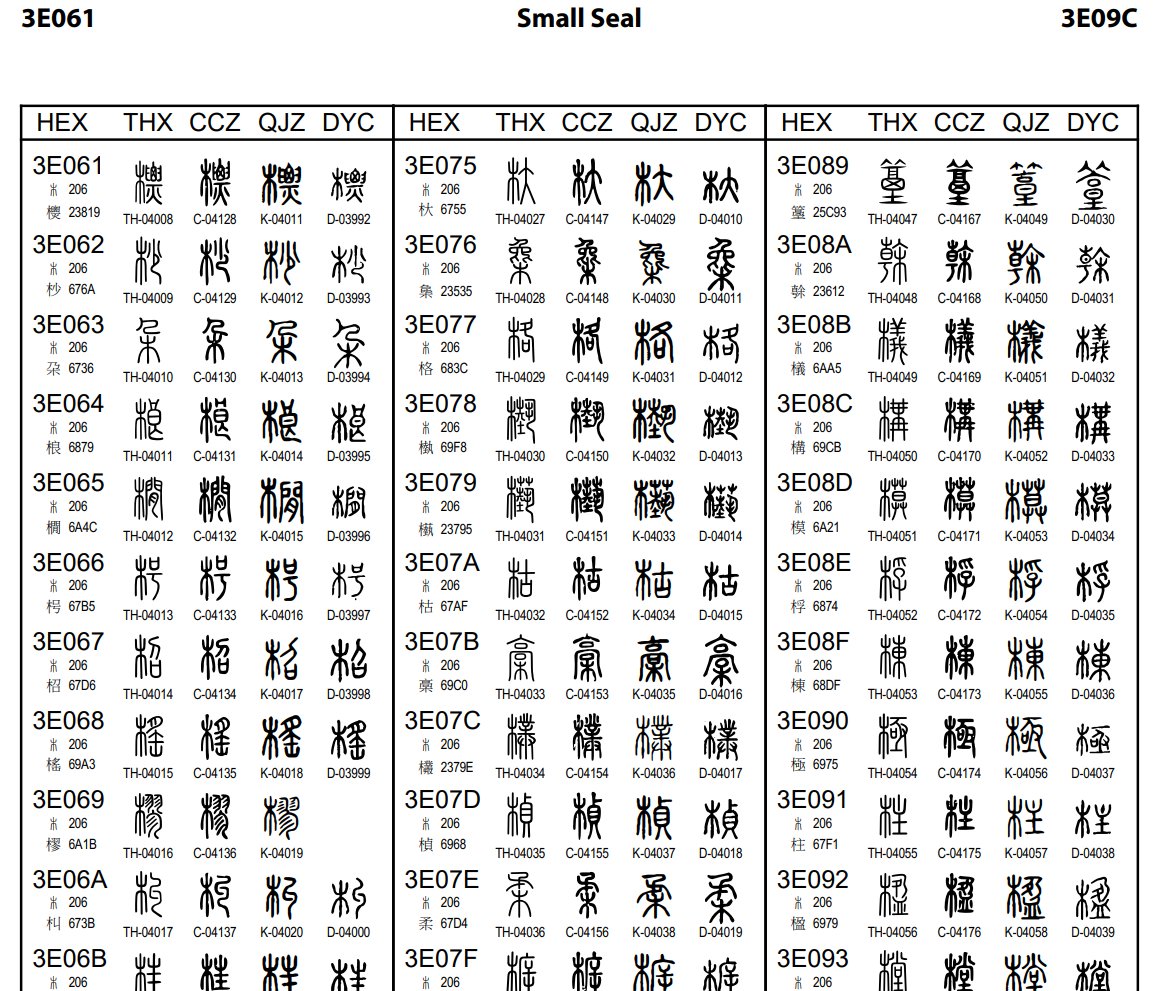 图:Unicode 18.0 官方展示的新增小篆字符示例。来源:Unicode Consortium
这两种方案都切断了文字的核心价值。图片无法被搜索引擎抓取,也挡住了屏幕阅读器。私有字库一旦脱离特定软件环境,就会变成一堆乱码方块。
1.1 万个小篆正式纳入 Unicode 标准平面。跨平台检索古籍从特权变成了操作系统的基础能力。只要设备系统升级并提供基础字体支持,小篆就能在不同应用的剪贴板里无损复制。
万字扩容挑战移动端内存边界
大规模收录复杂古文字在工程界存在争议。首当其冲的挑战是字体文件体积膨胀。中日韩统一表意文字(CJK)一直是系统字库中的容量巨怪。如果在默认系统字体中全量打包这上万个复杂矢量字形,文件体积将暴增几兆字节。
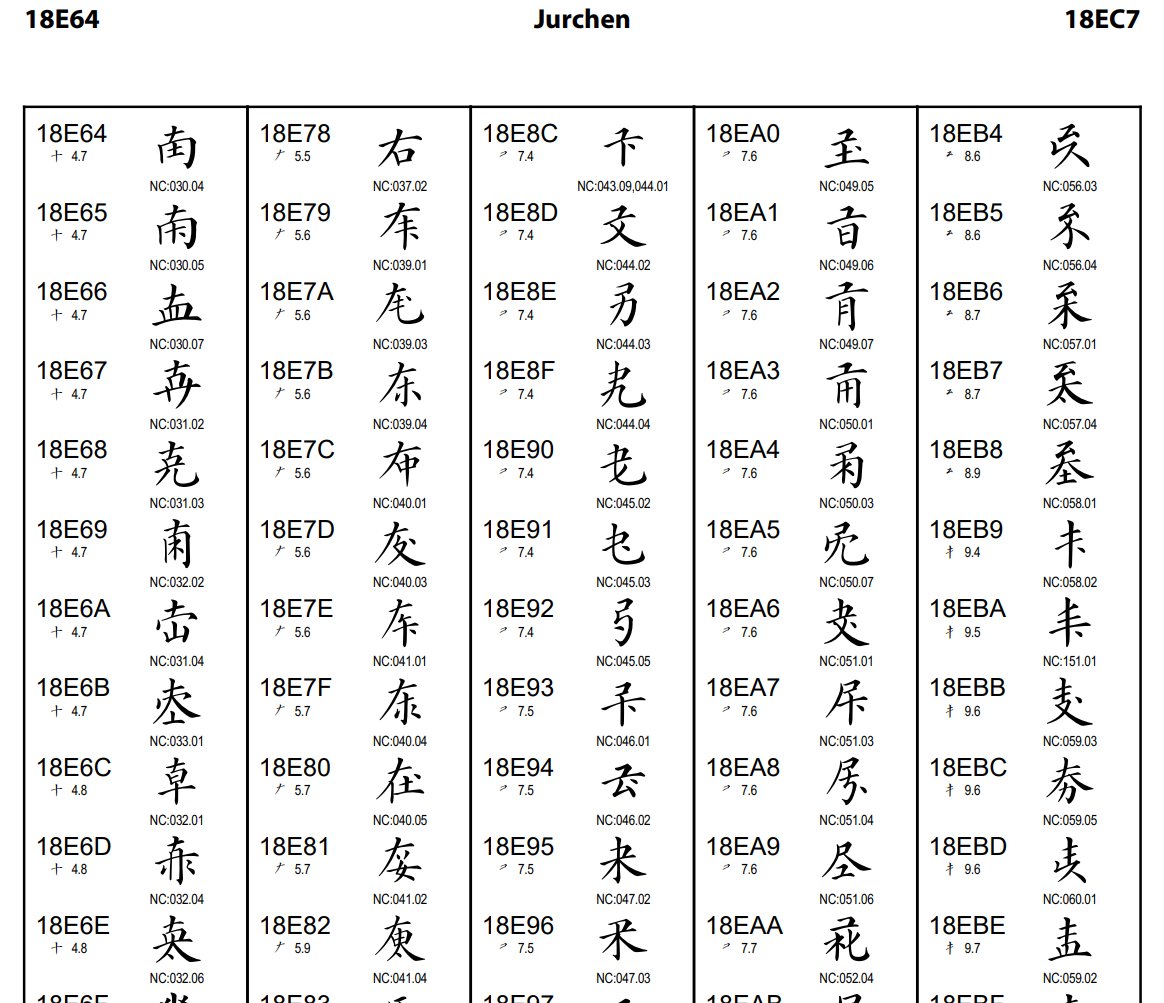 图:Unicode 编码渲染机制面临庞大字符集的处理压力。来源:Unicode Consortium
移动端操作系统和嵌入式设备存储空间寸土寸金。全量内置极低频字符的做法并不经济。部分开发者呼吁剥离这些不常用古文字,改用云端按需加载来缓解本地压力。
从数字人文的长期存储视角看,字符编码比闭源渲染引擎和云服务更抗老化。云服务可能在十年后断联。写进国际标准的 Unicode 码位会伴随计算机科学历史永久存在。
女真字与楔形文字补全多语种拼图
Unicode 18.0 同样收录了女真字数字和原始楔形文字数字等罕见符号。此外还增加了马尔代夫鲁菲亚等三个现代货币符号。
Unicode 的编码推进策略在兼顾历史碎片与当代使用场景。女真字和楔形文字入库补全了机器理解人类文明全貌的拼图。大型语言模型现在会吞噬所有可获取的文本进行预训练。统一字符编码为模型解析多语种历史文献提供了标准输入格式。
缺乏底层 Unicode 支持时,古籍相关的机器学习任务必须跨过繁杂的数据清洗门槛。现在,这些障碍被标准协议直接扫平了。
标准协议固化数字基础设施
从秦代李斯的行政指令到今天全球软件工程师的代码提交,统一文字的手段不同,但结果一致。技术标准的胜利在于它能把复杂事物固化为基础设施。
给一万多个古汉字分配确定码位看似枯燥。这实则是为它们发放了进入现代信息工业骨架的通行证。开发者不再需要为小篆排版折腾外挂字库。历史数据能在不同数据库间直接精确匹配。古文字真正活在了数字时代。标准协议本身就是保护文化遗产最坚固的保险箱。
参考链接:
- Announcing The Unicode Standard, Version 18.0
- Unicode 18.0 发布:收录 11328 个篆书,约占新增字符 87%