一份 32,455 个单词的英语词表,决定其前缀该用 a 还是 an 的逻辑,最后落脚在一段拦截了 129 个例外单词的手写判断代码中。Red Blob Games 在开发自动文本生成时遇到了这个看似基础的冠词选择问题。直觉规律看首字母是否为元音,这种处理会让系统直接向用户输出 an unicorn。
读音脱节截断了正则匹配
决定冠词选择的标准只看读音首音素。unicorn 字母 u 开头,读音首音素辅音 /j/,由此产出 a unicorn。hour 字母 h 开头,首音素却是元音 /aʊ/,结果导向 an hour。英语单词的发音与拼写在历史演变中出现了物理上的剥离。
为了找到代码逻辑的边界,Amit Patel 拖入了一份带发音标注的 CMU 英语词典。他排除了 3,133 个专有名词、8,574 个含标点的词条以及大量发音存在区域差异的词汇。清理后剩余 32,455 个干净词表样本。当输入集足够清晰时,特例的分布比整体规律更具工程指导价值。
在这三万多词汇里,只有 129 个词不符合首字母判断的常规逻辑。占比仅为 0.4% 的个案,直接否决了简单的首字母匹配方案。程序化文本生成场景下,规则引擎的成败全部押在这些微小的例外集合上。
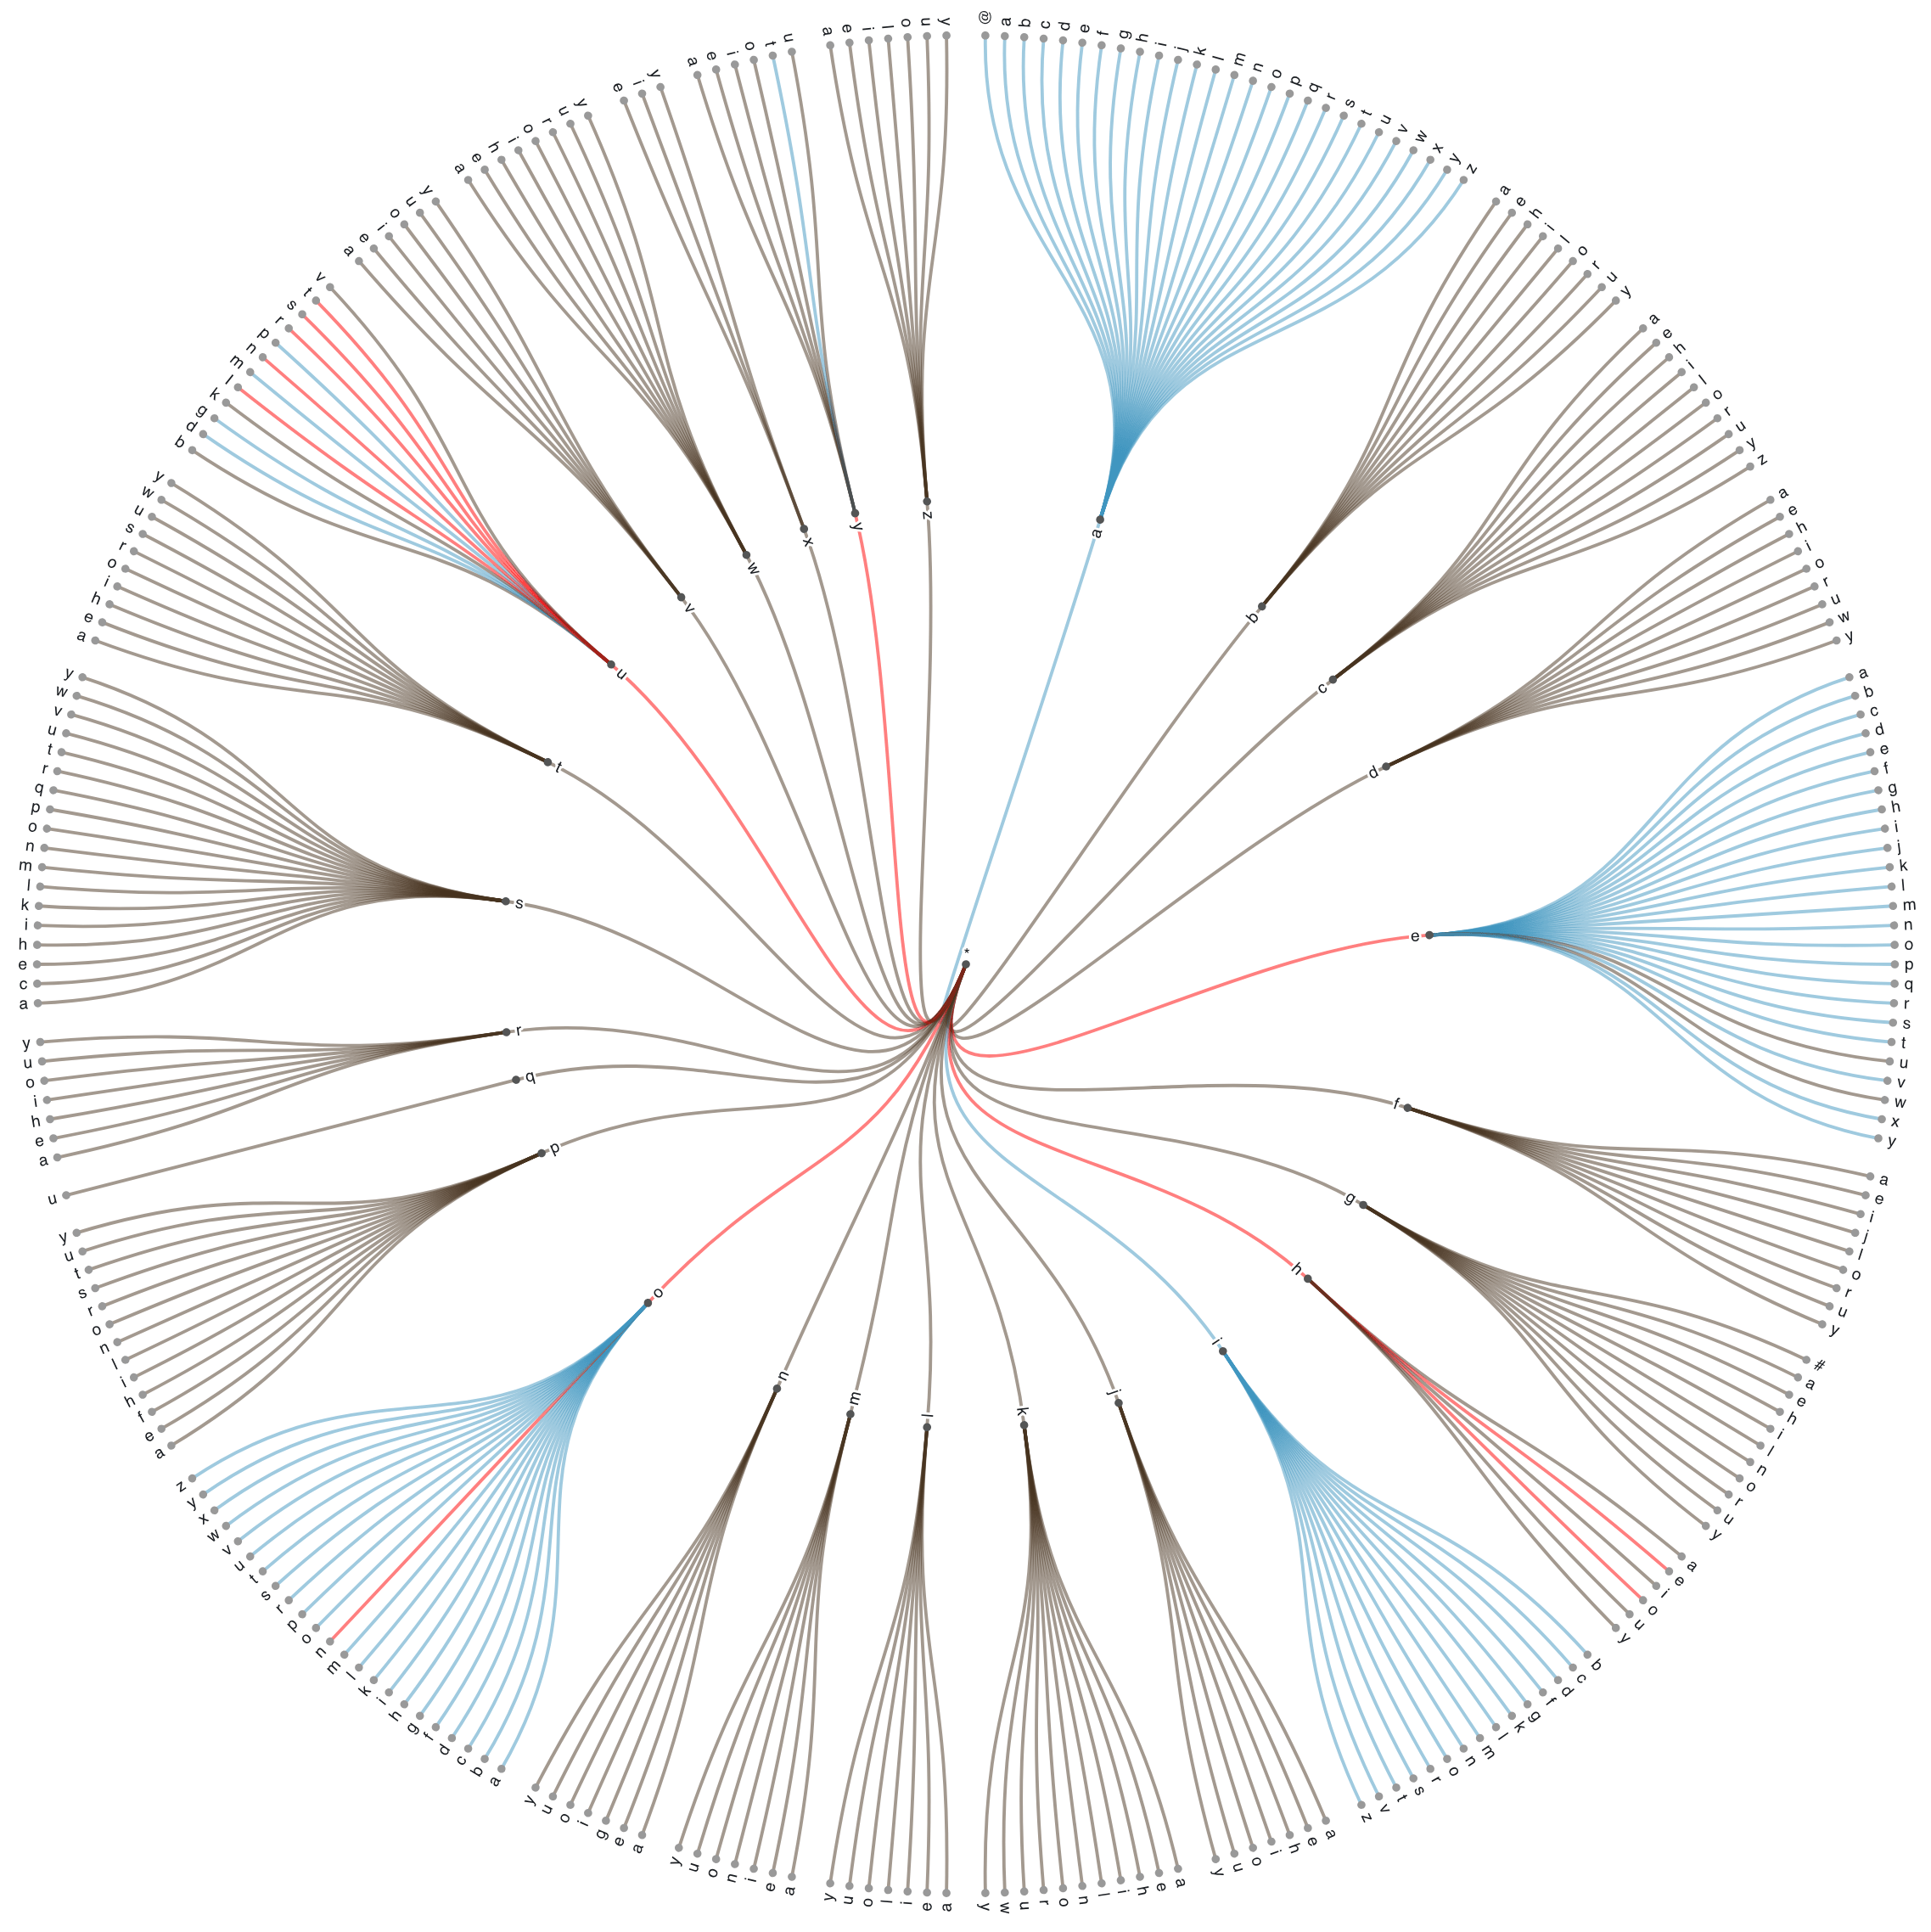 图:前两个字母是否足以决定冠词选择(黑=恒为辅音音素,蓝=恒为元音音素,红=两者皆有)。来源:Red Blob Games
算法受挫退回硬编码判定
确认了 129 个例外后,作者先试了一条更聪明的路:把前缀判断收敛成一棵最小决策树,按他的说法这近似于 DFA 最小化。这条路没走通,于是退回手写规则表。
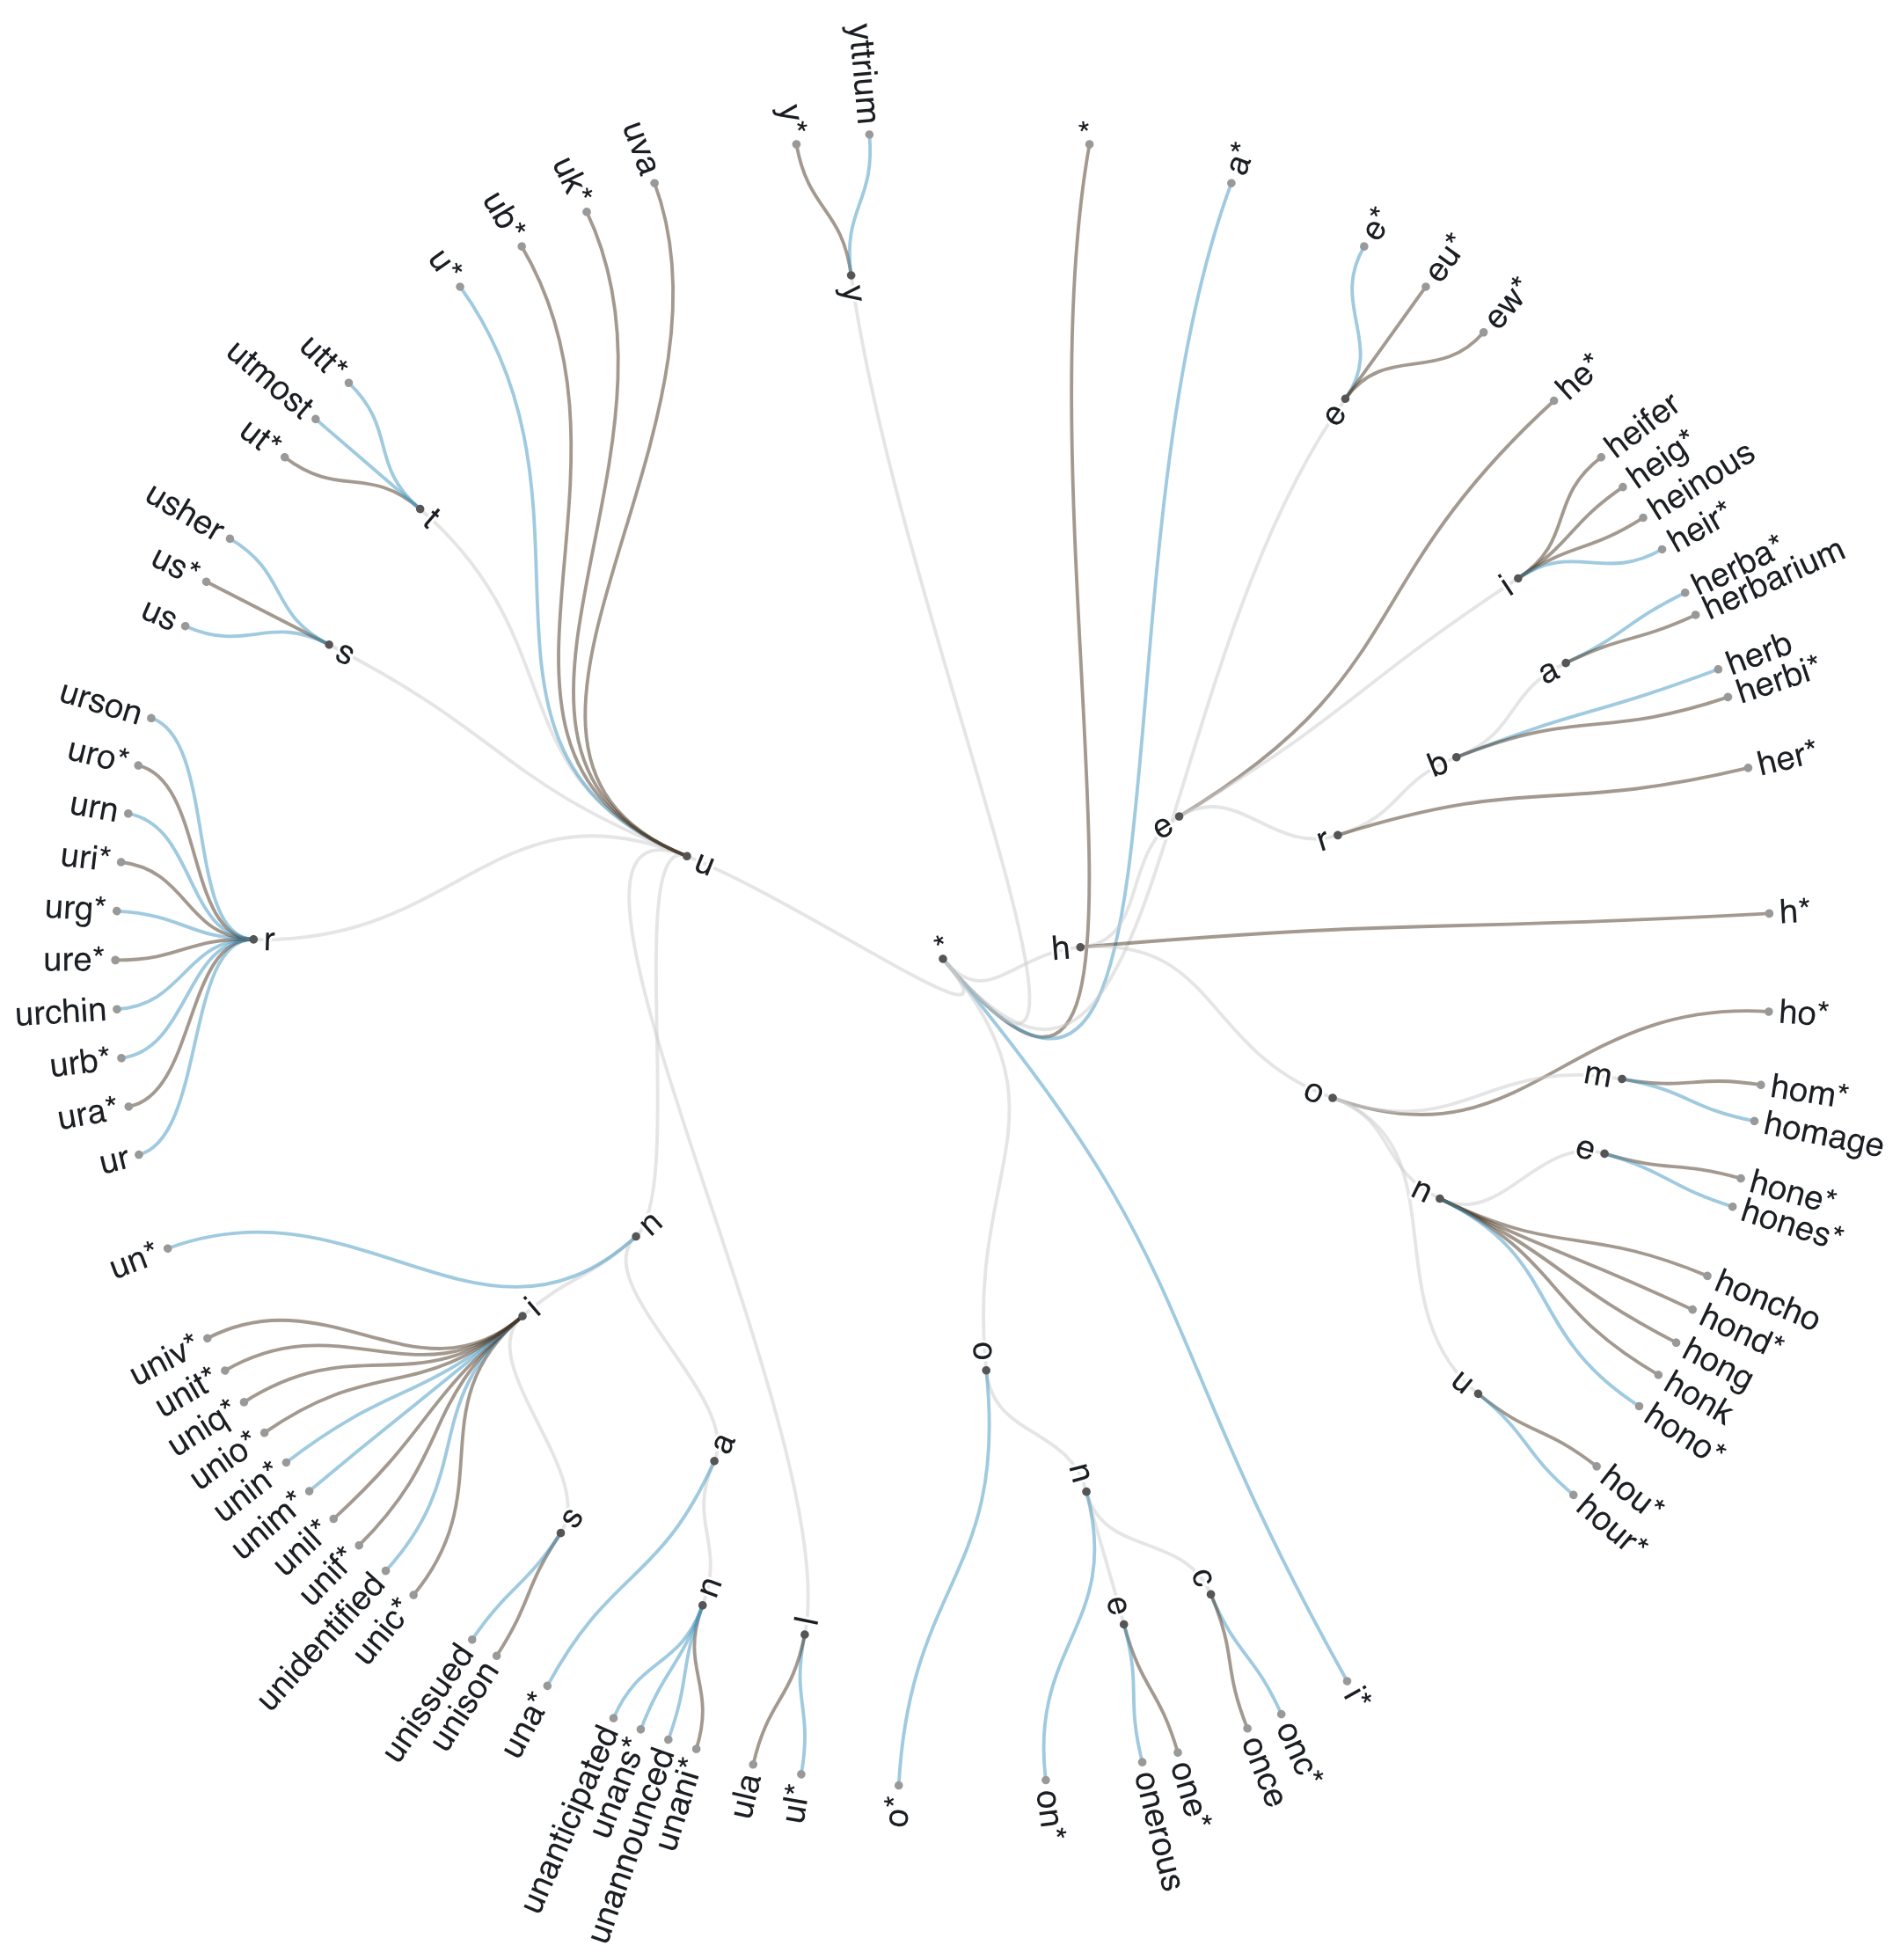 图:需要向后看多少个字母才能做出准确判断。来源:Red Blob Games
由于异常分布集中在特定的前缀组合上,人工归纳的效率压过了算法生成。他最终通过人工观察提取了 22 个判断分支。eu 与 ew 开头的词强制返回辅音,heir、hour、ytt 强制返回元音。**工程判断的本质要求开发者首先确认例外能否被穷举。**能穷举就手写枚举,无法穷举才需要加载外部发音词典。
def a_or_an(word):
    # 截取判断前缀的核心逻辑
    if word.startswith(('eu', 'ew')):
        return 'a'
    if word.startswith(('heir', 'herb', 'hour', 'ytt')):
        if not word.startswith(('herbiv', 'herbarium', 'herbicide')):
            return 'an'
    # ... 其余判断分支 ...
    if word[0] in 'aeiou':
        return 'an'
    return 'a'
没有引入外部词典依赖,抛弃了复杂的决策树算法。一个函数体内包含 22 个前缀判断,构成了系统的完整判定线。把 0.4% 的异常数据硬编码进代码里,直接切断了不必要的外部服务状态维护。
历史残留固化进代码块
异常前缀的分布保留了英语发展史中的重新括号化现象。古英语里的 a napron 因为长期连读被听成 an apron,剥离出了今天的 apron。相反,an ewt 变异成了 a newt 留下了 newt。在 Hacker News 的技术讨论区里,这篇依靠代码回溯语言规律的文章拉出了三百多条跟帖。
有人引用《剑桥英语语法》点出英语其实不存在不定复数冠词。some 在语法中充当存在量词,它能填入 there are some vendors 句式,却接不住 they are some vendors 中的定位作用。发音变迁造成的例外和复数冠词的缺失,最终都以硬性条件的形式转嫁进了代码库里。
丢弃型代码屏蔽可维护性
作者在复盘博客中特意提到,这段规则全凭手工分析编写。放在今天,这种枯燥明确的数据处理可以抛给大语言模型代工。一次性代码不需要留存后续的可维护性,只要能一次性通过所有用例测试,节约的时间可以投入到更核心的产品逻辑验证中。
代码只要拦截那 129 个特例,冠词分配链路就算收敛。把异常控制在几行硬编码里,让整个系统规避了外挂词典引擎的沉重负担。能在已知边界内穷尽的例外,暴力枚举永远是故障率最低的防线。当规则库足够确切时,0.4% 的噪音无法拖慢主链路的执行效率。
参考链接:
- English a vs. an
- Hacker News Item 49769944