每天听取你工作烦恼和代码片段的 AI 助手,正悄悄从你的浏览记录里抽取商业转化价值。2026 年 9 月,一名安全研究者在自己的 Android 手机上复现了一条隐蔽的跟踪链路,揭开了 OpenAI 如何利用 1029 个外部域名上的广告像素,将你的私人账号和站外足迹牢牢对齐。这份用两种独立抓包方法交叉验证的技术实证,在 Hacker News 上迅速冲到了当日热度榜第二,引来将近三百条工程师的激辩。这套机制本身是十年前就存在的广告归因做法——通过第三方凭证和埋点脚本,把站外的商业转化归到用户档案上。Meta 和 Google 早就把这套代码跑得滚瓜烂熟。但令人不安的落差在于,它现在跑在一个有着极高隐私期待的对话产品上。
刻意配置 None 属性撕开同源防御
跟踪链路的第一步,发生在毫不起眼的 ChatGPT 客户端日常会话里。根据实测数据,大约每五次对话请求,客户端就会向 chatgpt.com 发出 16 个随机字节,换回一个仅存活 60 秒的 RS256 JWT。这个凭证的载荷里塞满了关键信息:签发方是 chatgpt-wadi,受众被设定为 bzr.openai.com,最核心的是它带上了用户的账号标识 sub 和一个 22 位的标识符 obi。
拿着这个寿命极短的令牌,客户端立刻跨站向 bzr.openai.com/v1/obi/sync 发起 POST 请求。服务器随之返回一枚有效期长达一年的关键状态:Set-Cookie: __obi=…。
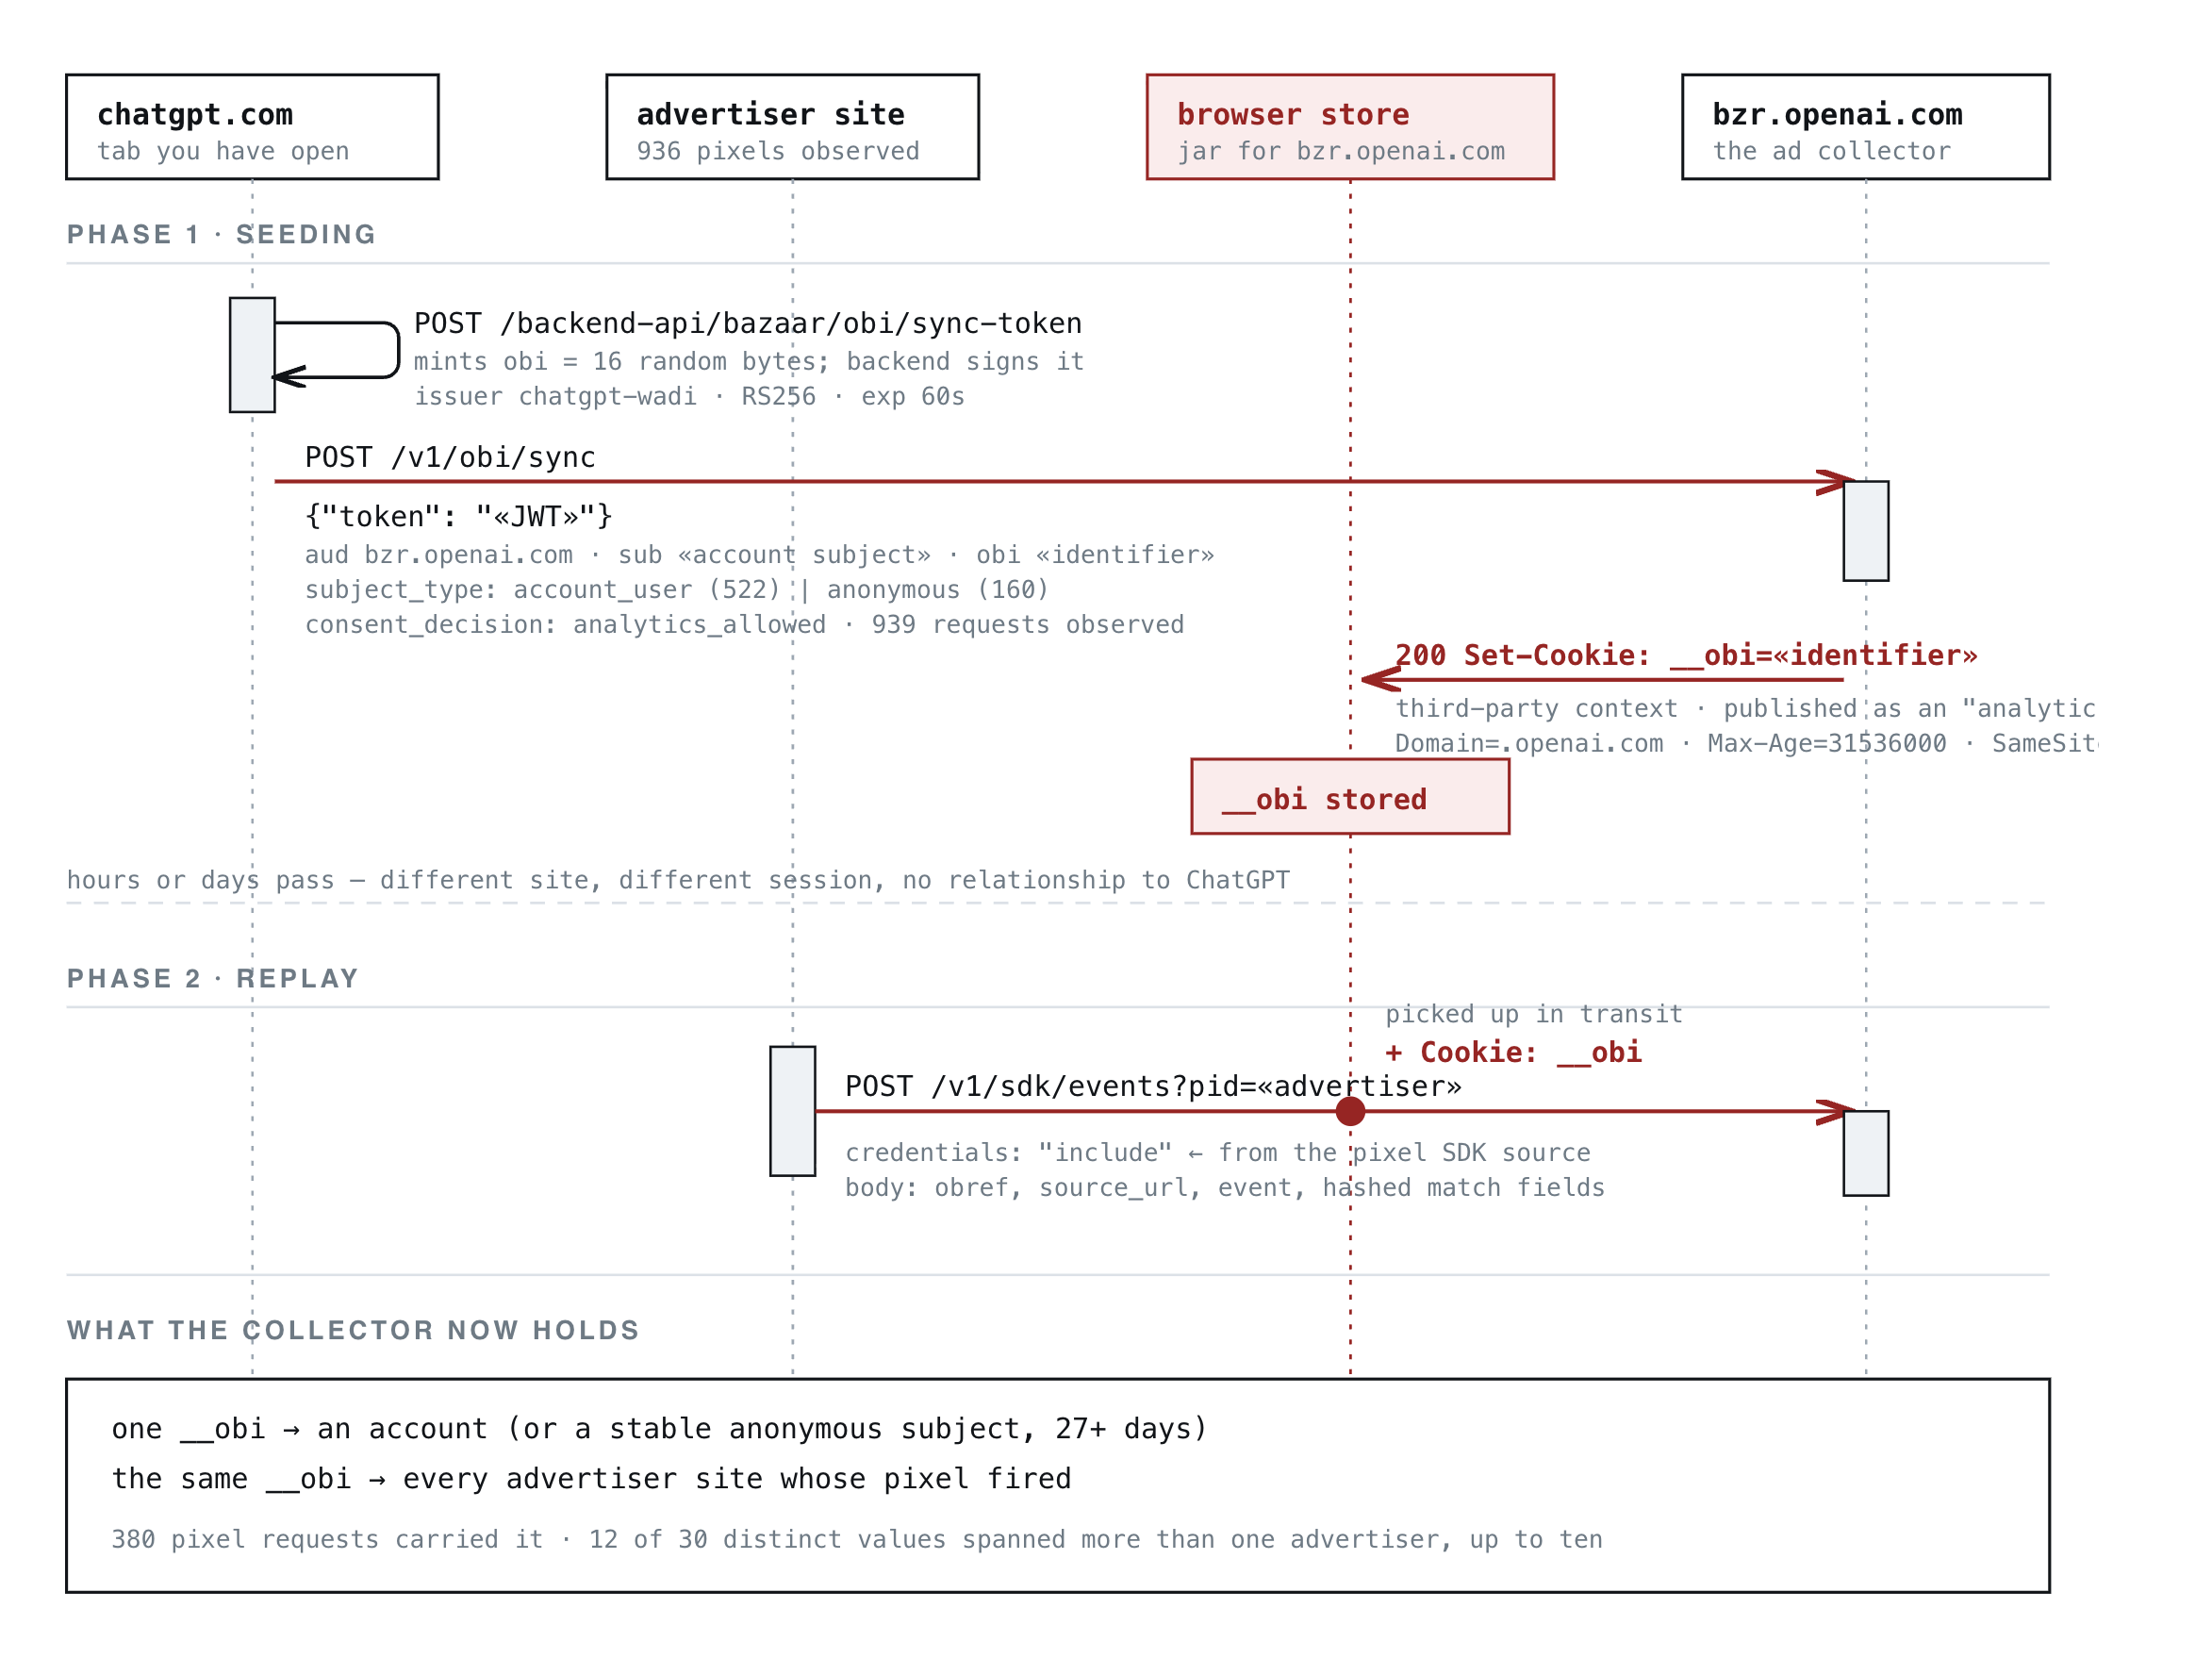 图:作者在手机上抓到的跨站请求截图。来源:Buchodi’s Threat Intel
这是一次精准的跨站防御穿透。在同一个广告主页面的测试中,oai-did 和 oaicom-stable-id 等常规凭证因为携带了 SameSite=Lax 属性,都被浏览器拦截了。会话级的状态同样因为域名不匹配而被挡在门外。唯独这枚名为 __obi 的长期凭证成功通行,因为它被明确设定了 SameSite=None 和 Secure 属性。
**研发团队清楚浏览器的拦截底线在哪里,并且专门为了跨站通信撕开了一个技术缺口。**即使是处于登出状态的游客,也会被分配一个存续至少 27 天的匿名标识。在 932 个解码令牌中,有 196 个属于这种匿名类别。只要设备接触过服务端,跟踪的信标就已经被埋下。
劫持数据总线刮取百次邮编明文
当用户访问安装了 OpenAI 转化像素的商业站点时,页面加载 bzrcdn.openai.com/sdk/oaiq.min.js 脚本的过程中,浏览器会自动带上那枚穿透防御的凭证。尽管官方 SDK 里预留了一条不带凭证的代码路径,但这在实际运行中阻止不了数据流出:凭证是附带在 <script src> 请求上由浏览器底层发出的,此时 OpenAI 的前端代码连一行都还没开始跑。
更具侵略性的是数据收集方式。分析长达数月的流量表明,在多达 936 个不同的广告主像素下,实际被收集的数据里,由广告主显式提供的数据只有 255 次,而 SDK 从页面结构里自行刮取的数据高达 685 次。这个体积小巧的脚本,不仅替换了页面原生的 window.dataLayer.push,还跨界读取 adobeDataLayer,甚至靠解析 gtm.js 脚本标签上的 l= 参数找出被开发者改过名的 GTM 数据层。官方直到 8 月 27 日的更新中,才把姓名和地理位置移出自动抓取范围。
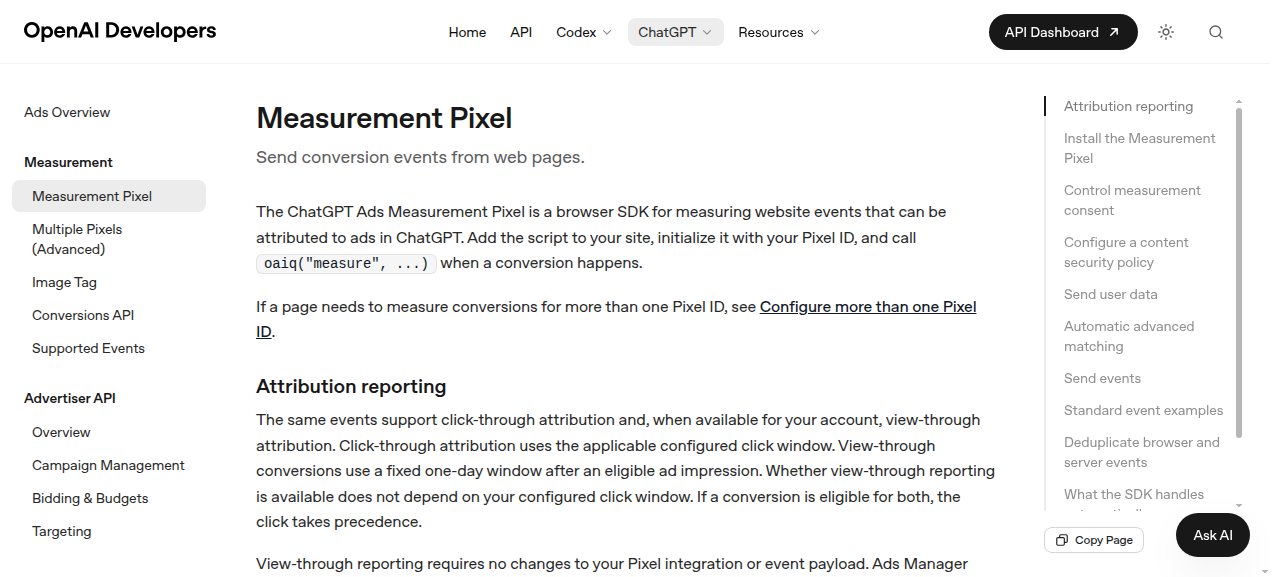 图:OpenAI 官方文档里广告主安装测量像素的说明页。来源:OpenAI Developers 文档
在这个刮取流程里,邮箱、电话和姓名被 SHA-256 哈希处理后上传,而国家、城市甚至邮编直接用明文传送。抓包记录显示,邮编是最常被刮取的表单字段,在 28 个站点上触发了 100 次。尽管官方的拒绝名单排除了密码、一次性验证码、社保号和病史等字段,但 URL 被完整保留了域名和路径。于是采集器的记录里,赫然出现了医疗状况、债务解决方案以及诉讼入口。当一段前端脚本开始主动扫描页面的隐藏字段和表单,它的目的就不再是提供基础工具,而是建立一张覆盖全网的用户侧写网络。
强行用产品分析包装商业收割
在 OpenAI 的协议控制面板里,官方把分析和营销拆分成了两个独立的同意项。这给了用户一种可以选择不被打扰的幻觉。但数据揭示了底层的工程实现逻辑:所有被解码出的 JWT 令牌都带有一个关键声明 consent_decision: analytics_allowed。那些明确拒绝营销、只允许产品分析的用户,依然收到了这枚用于跨站追踪的凭证。
官方的隐私政策把 __obi 堂而皇之地列在 Analytics 一类里,使其成为该类别下唯一一年期的条目。在实测观测中,同一个凭证被发往 12 个商业站点和 13 个不同像素 ID,涵盖了 Chewy、Wayfair、Coursera 等主流服务商。在 881 个配置明确的像素里,有 638 个甚至开启了自动匹配功能,其中包括观测到的每一个信贷与借贷类广告主。
研究者在 9 月 14 日向官方新闻和隐私信箱分别发信,质疑这套分类逻辑以及只同意分析的用户为何会被持续追踪。官方客服很快回复确认收到邮件并表示已在内部反映情况,但对信里的两个核心问题一字未回。这种回避本身就是一项清晰的工程决策:先用技术手段把数据流建立起来,合规压力留给后续的文本修饰。
拿着免费模式旧地图收割付费用户
在商业逻辑上,广告主根本看不到自己成为了这场数据收集的一环。这枚核心凭证属于他们前端脚本无法触达的外部域名。他们只是以为自己按照官方说明安装了一个转化统计组件,并不知道网站的访客正在被系统单向对齐到 ChatGPT 的身份数据库里。整个过程发生在浏览器底层发送 HTTP 请求的那一瞬间,广告主的服务器没法察觉。
这也引发了开发者社区里激烈的正反辩论。Hacker News 的评论区里,有开发者贴出了 MDN 的参考文档,证实了目前的浏览器拦截现状:Firefox、Brave 甚至苹果的 Safari 依靠内置的 ITP 机制直接拦截了所有第三方凭证,导致在整个 iOS 生态里任何浏览器都跑不通这条链路。但占据最大市场份额的 Chrome 和 Edge 却默认放行,让这条收集通道得以在 Android 和桌面端畅通无阻。工程师 Legend2440 认为没有必要大惊小怪,因为这正是 Facebook 和 Google 做了几十年的标准操作。甚至有用户质疑原博客本身像是 AI 生成的产物,直到被同行用实测抓包的结果打消了疑虑。
开发者 1saadcodes 直接指出了双方最大的分歧:Facebook 是免费提供服务,拿隐私换便利是摆在桌面上的阳谋;但 ChatGPT 是每个月都要收钱的产品。把用户的搜索历史、独立网站上的医疗方案查询以及债务轨迹,同他们在代码输入框里的身份强行缝合,打破了效率工具软件的信任底线。即使是研发出尖端 AI 模型的科技巨头,在面对成熟的流量变现诱惑时,依然把十年前的收割代码原封不动地搬到了新一代的生产环境里。
参考链接:
- ChatGPT now knows what you do on other websites via Ad Collector
- Hacker News 讨论 (item?id=49776729)