一份两页的架构迁移文档躺在团队的知识库里,格式工整,用词专业,甚至带有一个完美的总结段落。但在它发布的 48 小时内,没有一个工程师完整读完了它。直到系统在晚高峰发生死锁,大家才发现,文档里那句「采用了更稳健的并发控制机制」,掩盖了作者在两小时前放弃细粒度锁的妥协。那些真正重要的工程意图,被大语言模型重写成了一通毫无破绽的正确废话。
AI 正在让从不写作的人开始批量产出设计文档、PR 描述和会议纪要。这制造了严重的上下文不对称。作者拿着自己构建的系统、查阅过的日志和隐秘的业务约束去读机器输出。因为脑子里已经有了全景图,作者能扫一眼挑出重点,认为这段输出非常合格。
但当同一段文字发给同事,效果却截然相反。读者手里没有任何前提,只能被迫逐行硬读那些被稀释过的松散段落。AI 写作的代价并没有凭空消失,作者省下的那一小时思考成本,被生硬地按人数转嫁给了所有读者,而且没有人愿意为此买单。
98% 读者拒读润色版本
Cynthia Dunlop 收集了 668 份读者问卷,数据给出了一个反直觉的结论。98% 的技术读者宁愿阅读带有瑕疵的作者原话,也不想要经过 LLM 润色的版本。85% 的受访者对「疑似 AI 生成」的在意程度给出了满分 5 分。甚至有 78% 的读者一旦察觉 AI 痕迹就会立刻停止阅读。
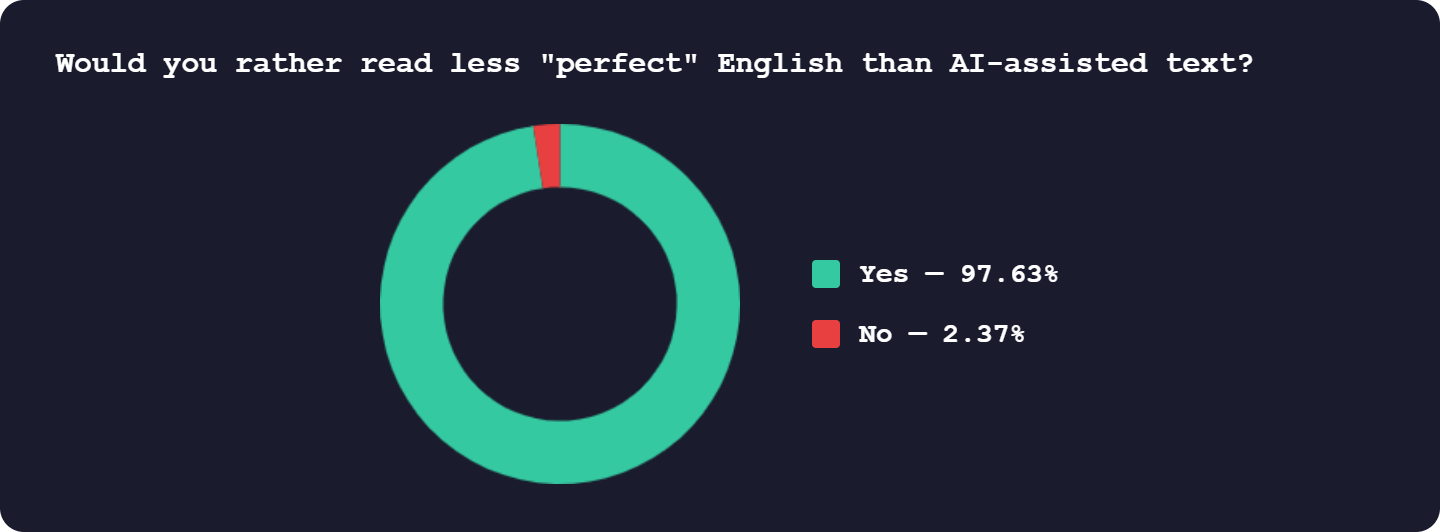 图:668 份问卷的最后一问,98% 的读者宁愿读作者自己写的原文。来源:Write that blog! 读者调查报告
这组数据剥离了我们对语言准确性的长期迷信。语法错误和非英语母语的表达并不会真正阻碍信息传递。读者在乎的是文字背后附带的真实工程意图。很多时候,读者宁可在一行粗糙的简陋注释里寻找作者对并发锁机制的思考。系统日志和架构图一旦被抹平为看似专业的客套话,技术交流就失去了本来的价值。
只有 23% 的人会因为作者是非英语母语者而放宽容忍度。另外 71% 的人一旦发现 AI 痕迹就会永久拉黑该作者。技术社区对信噪比的要求非常苛刻。任何稀释信息密度的行为都会受到严厉的信用惩罚。工程师每天要处理大量信息,他们需要的是能够直接用于问题排查的代码细节。文章如果充斥着生成的过渡句,读者就不得不耗费额外的精力去沙里淘金。
713 分与 293 条评论引爆共鸣
一篇在 Hacker News 拿下 713 分和 293 条评论的文章,将这种情绪具象化了。在软件工程里,写文档本质上是一个将高维业务状态压缩成低维文字的序列化过程。人类作者在压缩时,会潜意识地基于目标读者的背景知识进行裁剪和编排。用大语言模型替代人脑做反序列化,结果就是丢失了那些没有被显式写进提示词里的上下文边界。
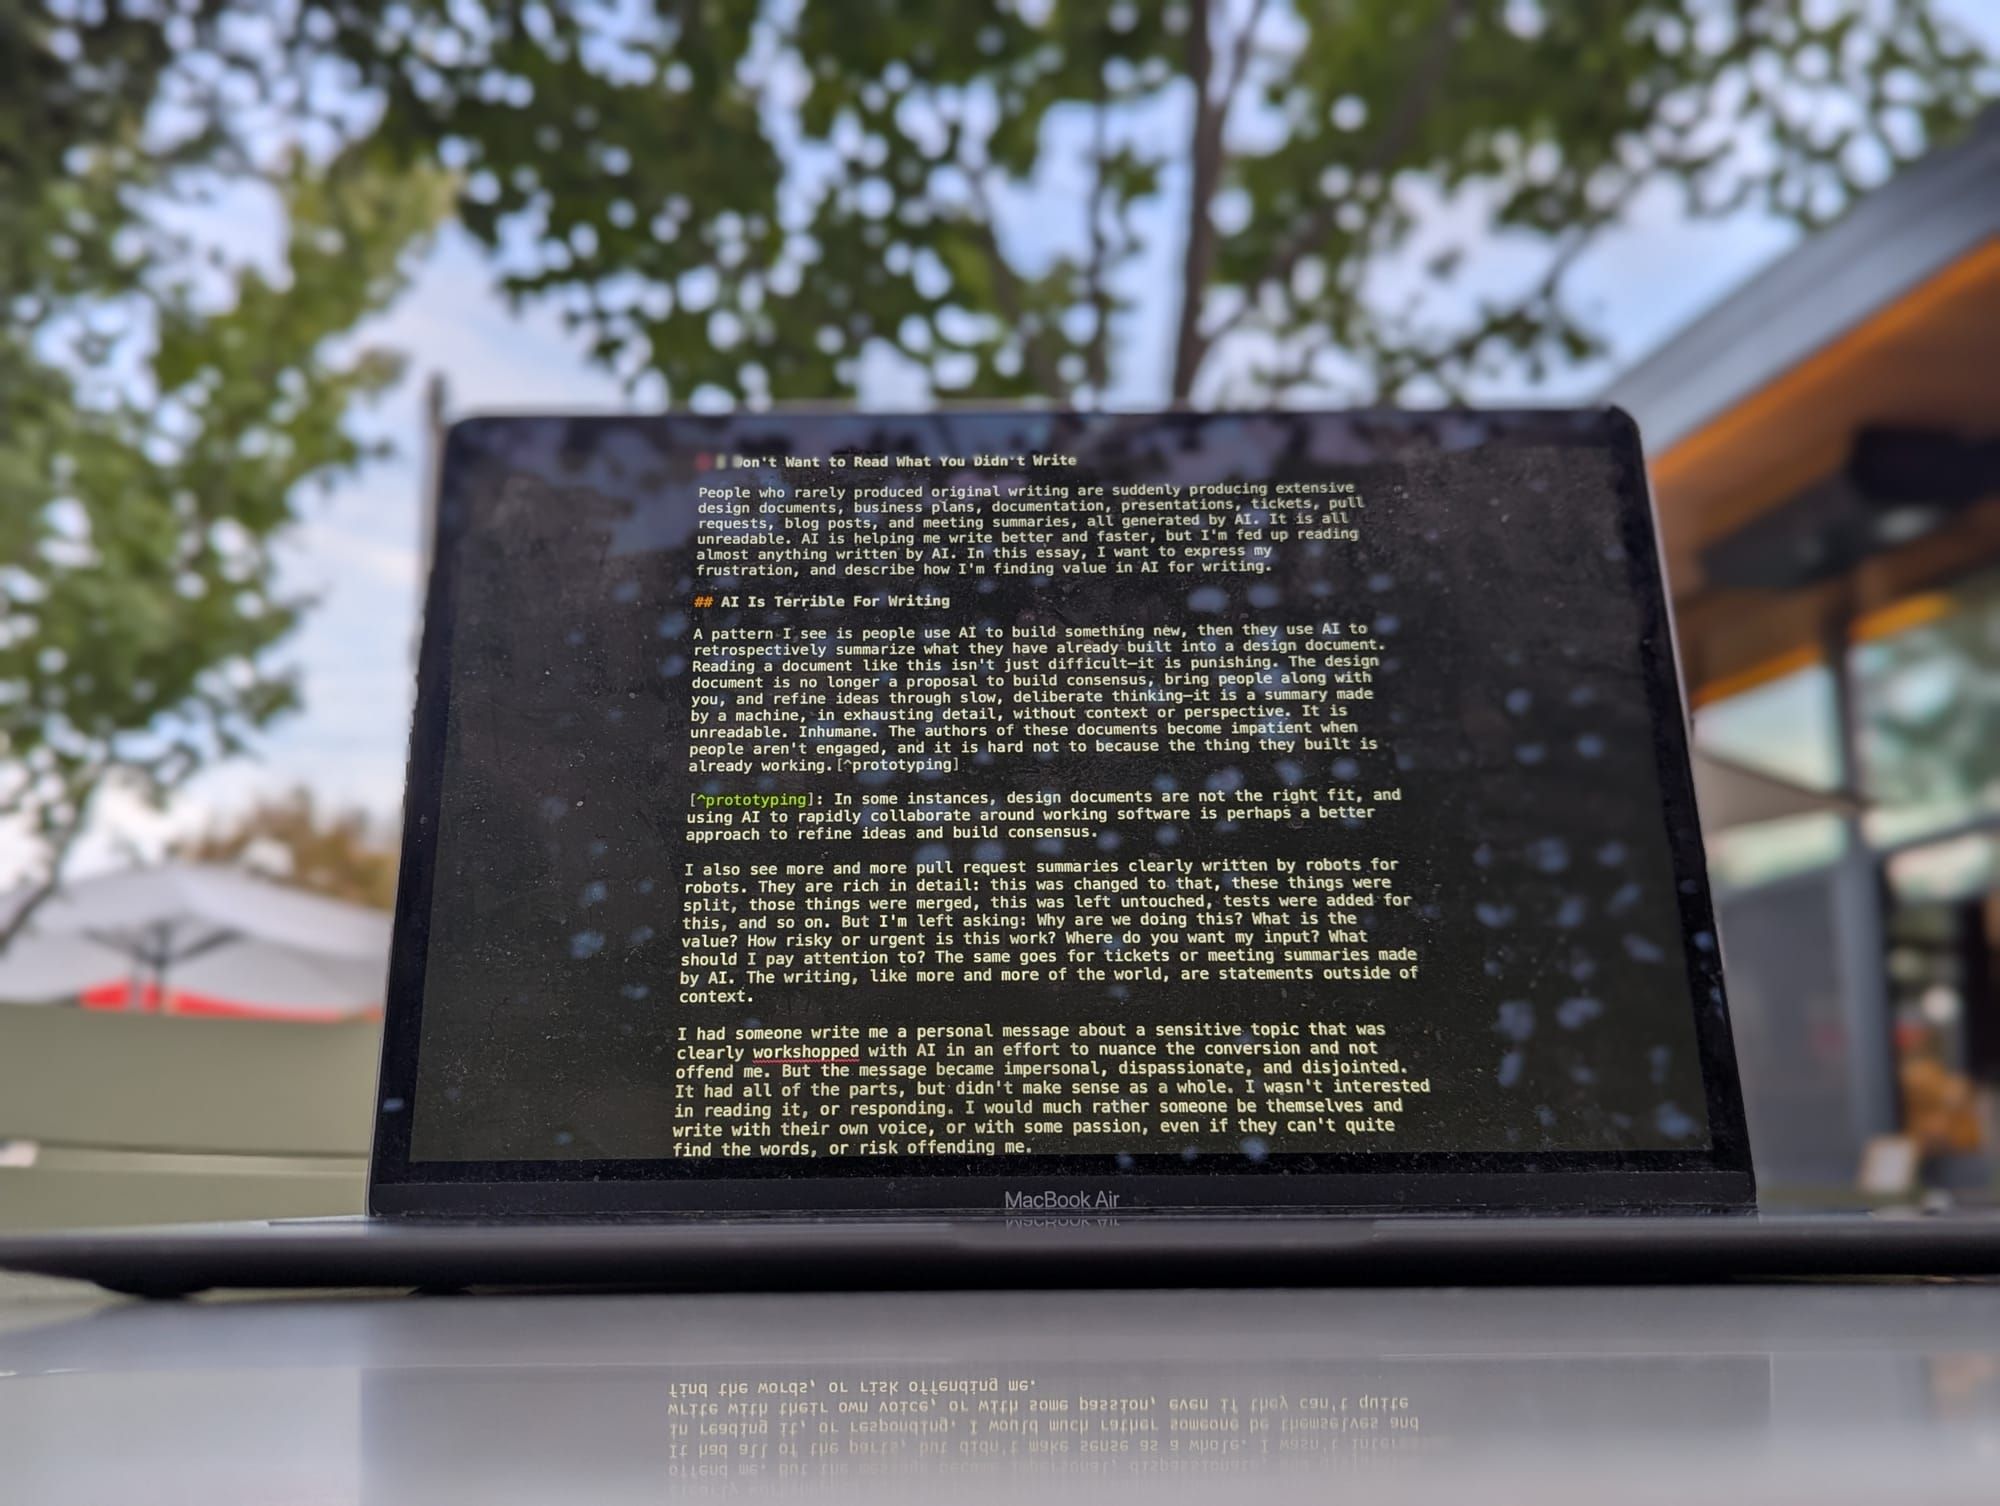 图:原文头图。来源:Colin Breck 博客
这就像是不带字典进行数据解压,呈现出的内容毫无重点。当技术决策的上下文被抹除,读者就无法理解代码重构的真正意图。他们看到了一堆经过华丽包装的词藻,却找不到解决系统瓶颈的线索。
审查逻辑比生成段落更有价值
语言模型并非在写作中毫无建树。一位学术作者分享了他与机器的真实分工。论文的每一行正文都是自己敲的。但他让程序承担了「用源码和日志核对段落」「补 BibTeX 引用」「用 TikZ 画图」和「挑拼写错误」的工作。作为审查工具,机器却找到了一个人工漏掉的致命错误。
这篇论文正文统一改用 L0、L1 和 L2 来描述 LSM 结构,而团队内部习惯将其称为 Gen1、Gen2 和 Gen3。阅读时大家需要在脑子里做一套映射。作者在某一段落里本该写 L2,却笔误写成了 L1。四位熟悉该系统的专家在人工评审时都没有发现这个逻辑硬伤,但模型找到了。
他尝试过反向操作,让模型直接从源码生成段落,结果发现没有一次是有价值的。生成的内容读起来难受且经常不准确,机器唯一的亮点仅仅在于生成摘要。
大模型的当前价值在于作为静态分析工具核对事实。它们可以用来代替人类校验庞杂的系统日志和源码细节。只要让程序对比文字与源码的一致性,它就能补齐人类在长文本核对中的疲劳短板。人类负责构建思考链,机器负责执行校验链,这才是更合理的工程分工。
缺乏心智模型作废了社会契约
Oxide 联合创始人 Bryan Cantrill 将大量用语言模型写作定性为作废读写双方的社会契约。读者不该被要求费力去理解一句作者自己都没费力写出来的话。为此,Oxide 规定所有公开文章必须经 Pangram 检测并判为人类撰写。这种强硬的规定反映了硅谷硬核工程师对机器写作泛滥的集体抵制。
Murat Demirbas 给出了一层技术维度的解释。AI 系统的写作质量已经停滞。因为和编程、数学不同,写作没有可验证的标准输出,也没有通过测试用例就可以证明正确性的捷径。由于没有具体读者的心智模型,神经网络只能无休止地优化下一个词的统计概率。它试图用最安全的措辞来匹配最大的样本库分布。没有对特定受众的预判,就不可能决定哪些细节需要展开,哪些前置知识可以省略。
缺乏心智模型的输出,注定是一堆概率上最安全的文字汤。系统需要的是带有明确业务焦点的工程判断,而不是四平八稳的陈词滥调。一个工具试图去取悦每一个可能的读者时,它也就失去了服务于任何具体技术场景的能力。
摘要泛滥放大了信息衰减
技术社区的长篇讨论还揭示了一个次生灾害,也就是引用链接的衰落。大量长评论指出,过去科技记者和博客经常不链原始论文。他们只给出摘要,导致结论常被扭曲。科学家发现某一特定条件下的实验结果,会被简化为普适性定理。
现在,机器摘要功能将这种断章取义的旧毛病工业化了。读者不再需要点开原始链接。语言模型直接把经过二次压缩的知识喂给受众,进一步截断了追溯信息源头的路径。技术讨论的基础在于源码和原始论文的交叉验证。
当整个行业都习惯于投喂几十页的文件并只读三段总结,获取信息的效率确实提高了,但信息的保真度也在大幅下降。作者拿着自己构建的系统去读机器输出,一眼就能挑出重点。但这并不代表同一段文字发给同事也能获得同样的清晰度。AI 代写剥夺了写作过程中最重要的逻辑梳理环节,而省下的思考成本被原封不动地按人数转嫁给了每一位读者。
参考链接:
- I Don’t Want to Read What You Didn’t Write
- Hacker News 讨论