2026 年 9 月 23 日,Google 发布 Gemini 3.8 Flash TTS 模型,把传统预置的 30 个音色库直接拉升至无限大。同一时间在 Hacker News 上,开发者正讨论如何用 1.7B 的开源模型在几小时内低成本克隆出以假乱真的个人分身。当开源网络把核心音质的还原度拉平到底线时,语音合成赛道的游戏规则变了:竞争的重心从单纯的音频生成质量,转移到了对声音资产的规模化调度权上。
 图:Gemini Audio 及 3.8 Flash TTS 模型家族能力矩阵。来源:Google Blog
30秒样本对抗1.7B微调模型,克隆泛滥重构竞争焦点
本次发布的 3.8 Flash TTS 主打深度创作控制,与之配合的 3.8 Flash-Lite TTS 专攻高并发应用场景。在新架构下,开发者仅需提供 30 秒的样本音频,就能完成高精度的个人音色复刻。但闭源大厂在声音复现这个单一维度上,已经迎面撞上了开源社区的低成本方案。
| 维度 | Gemini 3.1 Flash TTS | Gemini 3.8 Flash TTS |
|---|---|---|
| 音色来源 | 30 个官方预设音色 | 自然语言从零生成,另附 2,000+ 预设 |
| 音色复刻 | 官方未列为卖点 | 30 秒样本,需口头同意验证 |
| 双人场景 | 官方未列为卖点 | 单次请求内双音色编排与自然轮替 |
| 长音频 | 官方未列为卖点 | 数小时连续输出,音色漂移最小化 |
| 溯源机制 | SynthID 水印 | SynthID 水印 + C2PA 凭证 |
在社区实践中,一位开发者利用 QwenTTS 1.7B 模型,通过简单清洗个人录音数据集并调整微调配方,单个下午就在消费级显卡上训练出了难以分辨真伪的克隆音色。硬件门槛的崩塌证明,完美复现人声的物理声学特征不再是前沿工程难题。
另一位开发者年初利用 Qwen3-TTS 提取名人公开视频片段,仅凭极少量的文本就成功生成了跨语种的德语动态播报。基础模型的语言泛化能力,让所有公开音频变成了唾手可得的数据矿场。当几十亿参数的小模型就能解决音质问题时,闭源厂商必须寻找生成质量之外的新锚点。
预设库拉升至无限数量,自然语言引擎接管音色生产
Gemini 3.8 打破了主流接口仅提供数十个固定音色的开发惯例,直接利用大语言模型的语义理解力重构了发音人库。开发者用自然语言描述角色身份、特定口音和声学特征,系统即可通过提示词管线实时渲染对应的声音资产。
除此之外,系统直接内置了两千多个开箱即用的工业级可用音色库。这些预设不再是笼统的分类,而是细化到了墨西哥西班牙语、魁北克法语、苏格兰英语等极具地域特征的变体。系统把微小的语言学变体硬编码为底层服务,直接填平了出海应用的本地化成本差。
即将上线的 Voice remixing 功能允许用户选定基础声音后,连续调节音色厚度、基频音高、语速节奏甚至口音强度。声音不再是固定的切片文件,而变成了受连续参数控制的动态函数。用多维参数空间来定义非玩家角色,游戏和影视开发对录音棚的依赖被切断。
剧本指示替代音频拼接,单向合成转为舞台调度系统
解决「谁在说话」的基础问题后,3.8 Flash TTS 的深度控制特性转向了「怎么说话」。开发者在输入文本时可以夹杂舞台动作指示,利用脚本线索引导模型实时调整语气强弱和长短停顿。原本死板的文本朗读引擎,变成了能听懂剧本提示的数字演员。
应对复杂的双人对话场景时,模型能在单个请求内维持两个独立音色进行频繁轮替,并保持长达数小时输出过程中的特征稳定性。对话双方的声音不会随着长时程生成发生相互污染,也不会在句幅交接处出现生硬截断。多轨交互合并为单次前向推理步骤,提示词输入框正式接管了音频工程师的操作台。
最直接的底层控制体现在非语言发声的脚本化操作上。模型 API 原生接受 <laughs>、<sigh> 等特殊文本标记,并支持 |mhm|、|yeah| 的倾听回应符穿插插入。把非语言发声变成可编程调用的组件模块,机器对话剥离了僵硬的机械感,获得了真正意义上的呼吸节奏。
综合评测打穿七十分上限,合作网络圈占产业终端
参数化控制架构带来了工程基准指标上的全线压制。在 Hume AI Voice Design 基准测试中,该模型拿下 71.4 分位列综合第一,口音建模子项同样获得 60.8 高分。结合 Voice Arena 盲测中跨越日语、阿拉伯语和葡萄牙语的第一梯队成绩,其多语种底层架构体现出了明显的分数优势。
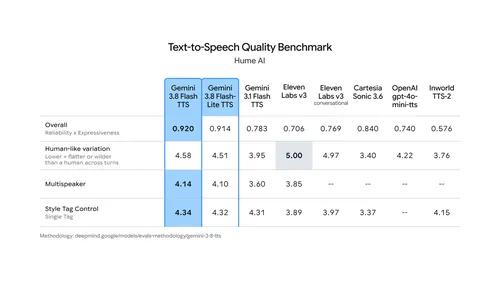 图:Hume AI Voice Design Benchmark 综合评分对比情况。来源:Google Blog
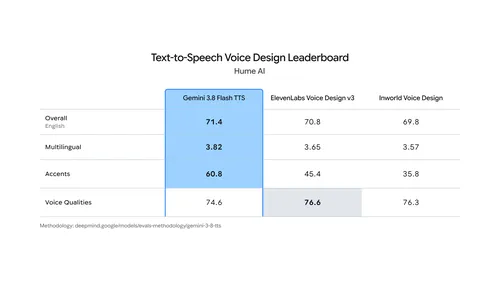 图:Voice Arena 多语种盲测成绩及表现概览。来源:Google Blog
与前代 3.1 Flash TTS 旧架构相比,新模型在长内容连贯性和双人剧本控制能力上的提升幅度,跳出了常规版本迭代的平缓斜率。跑分榜单的强力压制只是一层性能表象,真实工程杀伤力在于长时程复杂任务下输出结果的强确定性。
Google 正通过高密度的集成网络把这种确定性变成商业壁垒。新模型接入了 AI Studio 内置的双人剧本编辑器和 Google Vids 生产流,同时与 Agora、LiveKit、Figma、HeyGen 等基础设施和垂直行业伙伴绑定。庞大的合作网络把模型能力封装成生产线上的标准化插座。
同源验证嵌入合成管线,溯源体系迎击开源解法
面对高精度声音克隆滥用的潜在伦理风险,Gemini 3.8 采用了一套极尽严苛的硬合规流程。调用者必须提供一段包含特定口头同意声明的实时录音,且声学特征需与参考发音人进行严格匹配。这套验证机制在物理输入端抬高了恶意采样的操作成本。
同时,由该模型引擎生成的所有音频分片,都被强制嵌入 SynthID 隐写溯源水印,并在文件头挂载 C2PA 来源身份凭证。平台把合规操作从后期的人工法务审查,前置成了硬编码进模型推理管道的工程级阻断。
但外部社区对这套单点防御机制的长期有效性依然存疑。开源本地部署方案的极低操作门槛,意味着这些严密规则最终可能只会拦住愿意守法的企业用户。同时,Google 平台在消费者、专业创作者和云企业三端的可用性割裂痼疾依旧存在。松散的产品阵型让开发者在调用最新模型时面临复杂的账号权限阻碍,交付链路的内部摩擦仍在不断消耗着企业级大客户的集成信任。
Gemini 3.8 TTS 的核心价值,在于它把单向输出的静态音频切片变成了可多向干预的数字资产。开源模型用几十亿参数就能把声音还原到肉耳难辨,音质本身已经不再是可比的维度。把自然语言生成的音色库、细到一声叹气的提示词控制、嵌在推理管线里的合规追踪链条组合起来,才是闭源大厂面对开源方案时的真实解法。
参考链接:
- Gemini 3.8 Text-to-Speech
- Hacker News 关于 Gemini 3.8 TTS 的社区讨论