渲染一张普通分辨率的图片,需要消耗多少系统算力?在主流桌面显卡环境里,这不过是转瞬之间。开源项目 mTvare6/rayfuck 却给出了一组违背常识的性能读数。程序解算单个像素耗时极长,跑完一整帧静态画面的预估耗时,被直接拉长到 62.5 天。
项目的核心在于语言约束。作者手搓了一个完整的光线追踪渲染器,系统开发语言选定了只含有 8 条极简指令的 Brainfuck。编译出的底层可执行文件达到 23MB 的体积。比起最终输出的 0.9MB 静态图像,足足膨胀了数十倍。
产物体积的倒挂揭示了底层的运算逻辑。当一门语言拒绝提供任何硬件抽象时,最常规的算术也得用嵌套循环堆积起来。图灵完备只负责在理论边界上保证计算结果。底层语言提供的高级抽象机制,才是决定工程耗时与算力成本的核心防线。
寄存器清零逼出物理位移机制
现代编程生态的高效反馈,全部建立在丰厚的硬件资源之上。标准的 X86 处理器阵列预留了海量通用寄存器,它们专供业务变量随时停放。而在 Brainfuck 的代码沙盒里,所有现代控制流机制被剥夺,只剩下一条单向延伸的无限纸带。
沙盒环境里的每个纸带单元格,只被允许存放一个基础的无符号整数。原生指令集不提供任何跨越内存网格的间接跳转。开发者更无法调用快捷的赋值通道写入数据,工程师只能依靠尖括号指令控制指针在纸带上进行逐格挪动。
想要把某个业务变量传递到内存的另一处,系统动作必须退缩成纯粹的物理内存搬运。单格位移需要调用特定的 [->+<] 循环原语。这套逻辑单元不断将当前格子的数值清零,同时给相邻格子的数值累加。
原始变量如果需要保留复用,内存复制就演变成多格联动的 [->+>+<<] 展开指令。源格子的数据被强行拆解,同步分发给相邻的空闲格子。
这种强迫性的顺序扫描模式,把内存寻址的时间复杂度从 O(1) 击穿到了 O(N)。任何一次常规级别的函数调用,都会强制引发指针在纸带上的长途往返跋涉。
海量单调的自增与自减指令操作,构成了那坨高达 23MB 的编译产物。软件开发者用极度膨胀的空间存储容量,艰难换回了高级程序控制流的运行连续性。
定点数扩容挽救了渲染坐标轴
真实的光线追踪解算流程,高度绑定高精度浮点数字。光线与几何物体的相交判定,以及三维法向量的模长归一化处理,使得整套渲染流水线都在吞吐大量的连续小数。
失去底层浮点运算单元的支持后,光追引擎直接被打回到古典的定点数时代。渲染器起初尝试硬套常规的定点格式方案。高位存放整数而低位处理小数,它的解析精度极其有限,动态范围也被死死锁住。
虚拟三维场景需要构建大面积平整的地面,图形学常规做法是放置一个半径尺寸极大的基础球体。球体半径参数一旦被设定为 1000,基础定点格式的存储单元会当场触发运算溢出报错。
作者别无选择,只能重构底层图形数据结构。程序全面启用进阶的 Q16.16 长度格式。新方案占用多个连续的纸带格子存放单值,系统分辨率随之跃升至 1/2^16 的精密级别。坐标系的表示空间也被拓宽到 [-2^15, 2^15) 范围。
数据格式的升级动作阻止了物理碰撞引擎的崩溃。然而图形代码生成的每一个新变量单元,现在都必须带着对应的数据格子同步移动。这种机制使得原本缓慢的内存读写变得愈加沉重。
| 硬件缺失项 | 物理影响 | 替代机制与成本 |
|---|---|---|
| 浮点运算单元 | 小数精度与动态范围无法兼顾 | 采用 Q16.16 格式,单变量寻址与转移代价暴增 |
| 硬件乘除单元 | 单周期计算变成死循环堵塞 | 用内外层迭代模拟交叉相乘,单格极值触发 255 次连环减法 |
| 硬件随机数池 | 缺乏抗锯齿必需的内核随机熵 | 固定公式计算伪随机向量,牺牲算力占满单格状态空间 |
| 并发调度原语 | 多条光线无法开启交错并行渲染 | 单线程死磕 90000 个独立像素,帧耗时估算值拉长至 62.5 天 |
连环减法拖死平方根性能
剥离了硬件乘法器的支持体系后,算术逻辑操作退化成毫无保留的体力活。内存数值的相乘运算,被编译器强行拉平为多层深度嵌套的累积加法。
一个指针变量搬运到临时格子内,在接下来的运算期充当外层循环的节拍器。另一个因子变量则在每次外层迭代中,被反复拷贝投入内层去执行加法。基础定点数字模块交叉相乘,计算结果像碎片一样散落在纸带上的多处格子里。
程序在一轮轮耗时的数值累加之后,必须手动擦除纸带上的多余数据,借此手段剥离额外的放大因子。这套低效算术,将原本极短时间内能完成的操作分解成重重循环。
光线追踪模块里的空间求根公式,制造了更深层的性能真空区。通用的 Heron 开方算法需要频繁调用除法运算。备选的泰勒多项式展开方案虽然只依赖加减乘操作,但在特定数值的关键计算区间里拟合极差。
光追系统最后启用了复古的竖式长除法策略。控制指针从被除数内存的最高位段逐段往下扫描验证,系统在每一轮减法循环里反复减去除数,并将结果位顺次累加。
临时余数一旦触发变负警报,除法指针立刻回退一步,顺势切入相邻格子的数值处理。在最糟的运算周期里,单格数据最高会跑出 255 次连续减法。
算法结构的复古大倒退,死死守住了场景渲染的物理正确性。图像解码后的平方根运算差异值,被强行压制在 0.00001526 的误差限以内。人类肉眼看不见细微的偏差,但宿主机的海量计算资源被尽数埋葬。
词法解析任务丢给大语言模型
把高级 C 语言结构直接翻译成纯符号文本,显然超出了自然人的工程容忍极限。开发链路引入了中间表示语法(IR)来做缓冲隔离,这套中转语法包含 26 条核心宏指令。
系统借由一套中转脚本,把冗杂的 C 源代码转换成静态单赋值流(SSA)。在这套重构后的数据生命周期模型下,工作变量被固化,不再遭遇二次同名覆写。旧内存格子上的废弃数据不再干扰新生变量的寻址通道。
海量且纯粹是苦力的 C 语言转 SSA 解析任务,被顺手甩给了外部的大语言模型引擎。人类大脑只负责搭建清晰的数据流控制架构,AI 工具接管并补全了整张底层语法树的节点映射。自动化工具链填补了高级业务逻辑与最底层黑箱之间的缝隙。
缺乏系统时间调用的 Brainfuck 环境,甚至连最简单的随机数发生器都拿不到。超采样抗锯齿组件依赖连续的微弱扰动向量,程序只得启用一条极简的线性同余表达式来进行模拟。
特定参数配合边界模运算,刚好能在随机状态陷入死循环之前,彻底跑完单格所有可能的状态。这套纯理论生成的数学扰动值,足以支撑起单像素网格内的抗锯齿射线发散位移。
千层循环算出梵高扭曲感
离线渲染程序启动加载后,真实执行效率呈现出断崖式崩盘。在项目库留存的工作记录节点,整张 90000 像素的画布仅仅解算出 1229 个点。
随着追踪光线从开阔天空域打向地表的几何大球体,场景反弹光路的网格计算复杂度呈指数级上扬。原本 62.5 天的乐观跑帧预期,被复杂的球面多次漫反射算力需求强行往后拉伸。
在这仅有的 1229 个初算像素颗粒里,渲染图已经浮现出部分颜色异常的像素网格。定点运算机制自带了累积截断误差,它顺着光线反弹的历史路径被不断放大。
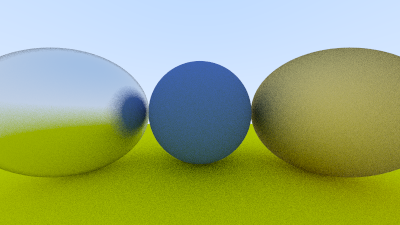 图:C 参考版本的渲染输出,色彩过渡自然。来源:epestr.com
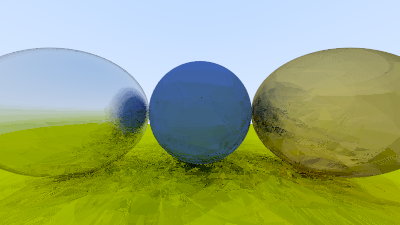 图:Brainfuck 版本的渲染输出,因精度误差呈现梵高式的扭曲质感。来源:epestr.com
Reddit 技术社区跟进了并发重构的可行性探讨。原始作者受到启发,回滚代码重构了底层的 JIT 解释器引擎。新版架构强行拉升了基础符号指令的管线吞吐效率。
当整张演示图片艰难跑完终点,超长除法操作在反弹光路中遗失了大量细碎小数。模型的高光区与阴影结合带,反而呈现出类似梵高油画特性的波浪扭曲形变。底层代码级的精度磨损,意外刻画了最终出图质感的粗犷笔触。
所有高级编程语言封装完毕的那些基础语法抽象,本质上是现代开发者生命时间的保护屏障。当一台计算终端连硬件除法单元都拒绝开放时,开发者必须主动剥离对高阶算法的全局掌控。
开发者只能放下对场景特效的执念,转身投入纸带移位的繁琐缠斗之中。代码生态的基础设施越是薄弱,研发人员填补编译黑洞的心智损耗就越恐怖。图灵完备理论确保所有的逻辑电路终有一解,但没有任何肉身能抵得住那漫长岁月。
参考链接:
- Writing a Ray Tracer in Brainfuck
- HN 讨论串