2026 年 9 月 24 日,Claude Opus 5.5 发布刚刚两天半,livenerf 项目悄无声息地上线了一套死板协议。好几个月来,社区总有人发帖指控 Anthropic 在偷工减料,说新模型发布几天后就会被偷偷「调弱」。量化压缩、同名模型暗中替换、砍掉推理强度,或者是改了内部路由网关,各种猜测满天飞。大家每天各执一词,有的拿着聊天截图说是实锤,有的斥责对方是幸存者偏差。
争议变成工程命题,从锁死 78 道题开始
livenerf 没有参与口水战,它启动了一组连续 30 天的测试序列。每天定点跑同一套题,把前 10 天的数据直接压成基线,后面的两个 10 天窗口拿来做对比。按照这套进度,最早在 10 月 24 日就能出第一个铁证结论。
要搞测试,肯定不能用海选大锅饭。原始题库足足有 2336 道题,全部来自 GPQA Diamond、MMLU-Pro、竞赛数学和最新的 AIME 2025–26 题集。Opus 5.5 首次答题就轻松拿下约 93% 的惊人正确率。
筛选发现,97% 的题要么模型一直对,要么永远错。恒对的题测不出下降,恒错的题测不出改善,两类都进不了面板,最后留下的 78 道时对时错的题构成正式题库。这些题正好落在模型能力的边缘,是唯一可能反映变化的区间。
截至 9 月 29 日,前 30 天里的 6 天测试已经全部跑完,每天 90 个样本打满,没有产生任何缺失数据。这种连续的密集采样,没有给所谓的网络波动留出丝毫借口。
划下 7.5 分检测线,接纳高方差区间波动
把这 78 道题剥离出来后,作者对选择偏差进行了重新测量。既然题目是因为时对时错被选中的,它们在真实测试里的通过率必定更接近抛硬币状态。果不其然,在新样本的测试中,通过率从初筛的 54.7% 径直升到了 62.0%。基于这个修正后的真实通过率去计算统计功效,后端的数学底座才真正立得住脚。
这套包含 78 道题的精简面板每天都会被完整跑一遍。在 10 天的窗口期内,它有能力测出 7.5 个百分点的准确率微小位移。完成这套日常监测的开销大约只占 Claude Max 周用量配额的 3.6%。成本压到这个量级,才可能连续跑满三十天而不中断。
认定模型变笨绝不是看一眼折线图就算数。判定的硬性规则被提前写进了预注册文件:分数下跌的趋势必须在两个 10 天窗口里,全部突破 99% 置信区间,且绝对降幅至少达到 3 分。这是为了直接砍掉单日服务器抽风带来的假阳性噪音。
判定机制还拉上了一个硬核对照臂。每天系统都会用同一个 harness 去跑一遍 claude-opus-5 的 GPQA 题。两边成绩如果在同一天发生同步波动,问题就必定出在外部测试框架或平台环境上。只要对照臂动了,Opus 5.5 就被判定为无罪。
变量全部死锁在空目录沙箱里
如今调用大模型 API 早就不是简单的函数输入输出了。现代大模型的采样参数形同虚设,底层的思考机制根本关不掉,单次请求的确定性不复存在。模型的内部行为没法固定,能做的就是把它外部的一切条件钉死。
测试时的提示词被强制冻结,连命令行工具 CLI 都被钉死在 2.1.280 版本。Claude Code 在后台经常自更新,一旦 harness 在看不见的地方升了级,分数波动的表现跟模型降智简直一模一样。作者拔掉了所有扩展工具、关停了 MCP、清除了 CLAUDE.md 文件,连带记忆功能也统统禁用,只在一片空白的固定目录里跑单轮问答。
代码题只让模型输出纯文本,判分放到外部沙箱里跑隐藏测试,不设 LLM 裁判。裁判自己也会漂移,一旦引入,就分不清分数变化来自模型还是来自判分。
为了证明这套流程不是自娱自乐,作者先做了正向对照,专门测了一把已知性能退化。把推理强度强行拉到低档,模型输出的 token 瞬间暴跌 62%,准确率跟着掉了 8.3 ± 4.5 分;设到中档时,token 掉了 26%,准确率掉了 4.2 ± 3.9 分。模型在后台偷工减料省算力,生成字符数的缩水必定比答案准确率的崩塌来得更早。
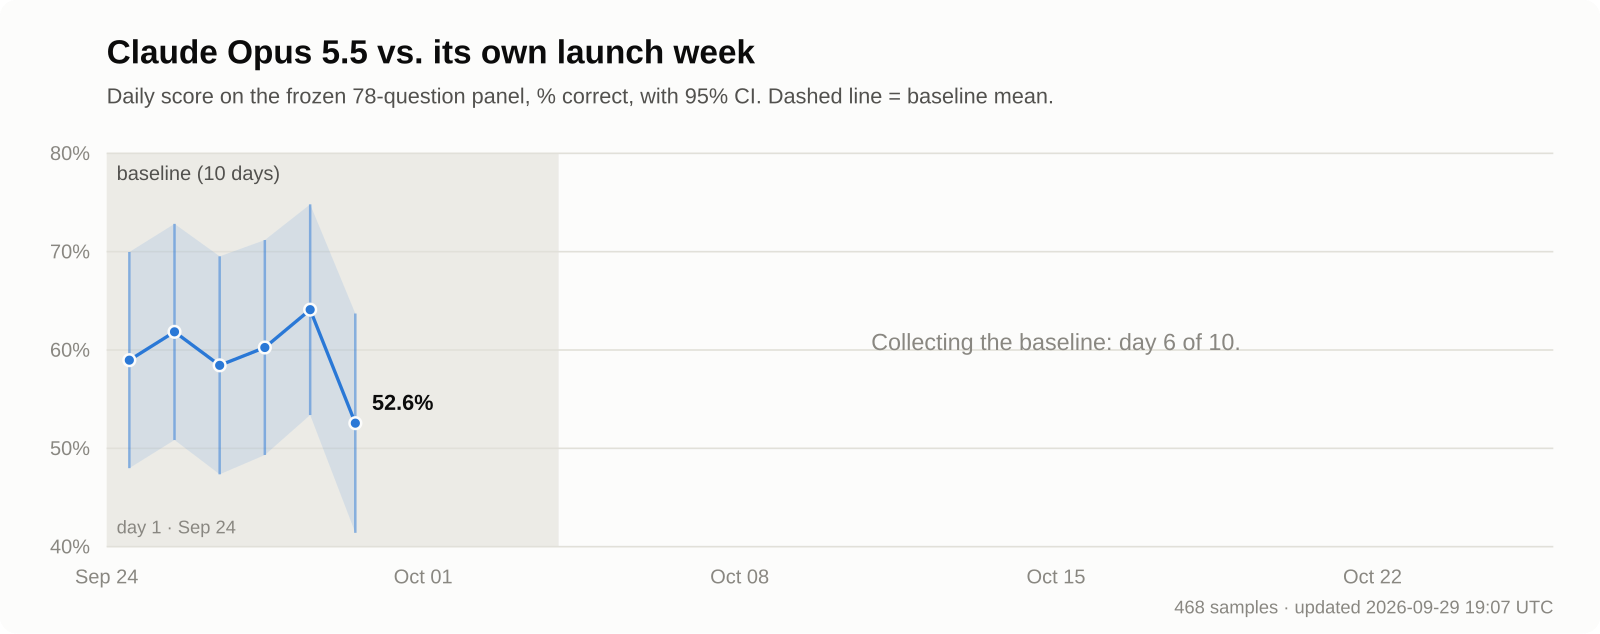 图:每日面板得分曲线与基线窗口均值。来源:livenerf 仓库
尺子能测推理降级,分不清同族模型互换
作者在实验报告里毫不避讳地指出了这套系统的物理极限。如果在未来的某一天,Anthropic 偷偷把线上的 Opus 5.5 替换成了老一代的 Opus 5,在 99% 的置信度限制下,这套机制根本分不清谁是谁。
真把 Opus 5 换上去跑,最终只测出了 −3.8 ± 6.3 分的误差,token 数量也只减少了 23%。高达 6.3 分的方差,把系统真正的能力退化死死掩盖住了。同族模型之间微小的代差,单日单次的样本量根本切不穿这层统计迷雾。
虽然在 10 天窗口期内,样本总量能攒到单日验证的 2.5 倍,但现阶段没有任何推导能证明这个数字足以把巨大的方差抹平。工具主动把自己的无能边界画清楚,比那些信誓旦旦声称能抓出一切猫腻的声明更具工程说服力。
在对那 78 道题进行只读审计时,作者发现题库本身就带着一堆烂摊子。有 8 道题的官方标准答案看起来就是错的,另外还有 30 道题的表述充斥着各种歧义。按照常规逻辑,这种脏数据肯定要在测试前全部清空。
但作者顶住了删题冲动,选择按兵不动。他只是在预注册清单里多加了一份敏感性分析,打算在出结果后,再剔除这些病题重新算一遍分数。宁可背着脏数据继续往前测,也绝不容许在执行期临时篡改规则,这直接保住了预注册协议在实验中的最高优先级。
统计标准搬运大厂论文,题库死锁防污染
在计算误差棒时,项目拒绝发明那些花里胡哨的民间公式,而是直接照搬了 Anthropic 自家研究员 Evan Miller 在 2024 年论文《Adding Error Bars to Evals》里的方法论,并严谨地套上了聚类标准误。统计口径直接沿用厂商自家研究员的论文,评测方不需要自创一套可能被质疑的标准。
整个测试系统的底层框架,直接搭建在英国 AI 安全研究所开源的 Inspect 上。这个项目在 GitHub 上悄悄拿到了 550 颗 star,完成了 39 次代码提交。虽然连个像样的开源许可证都没来得及贴,但底层的代码架构已经堆砌出了坚实的数据防御力。
仓库里所有的数据文件,全部被打上了 BIG-bench 风格的 canary GUID 标记。这种标记直接给数据上了锁,防止未来的模型在满世界爬取训练数据时,把测试日志当成语料生吞下去。
因为 GPQA 原作者的硬性要求,这批高质量测试题不能在外部重新公开发布。项目选择把所有的题目按照 sha256 算法做了哈希固定,只在测试机本地做隐蔽缓存。只要最终校验的哈希值没有漂移,测试用的就死死是那 78 道题,谁也无法在后台进行篡改。
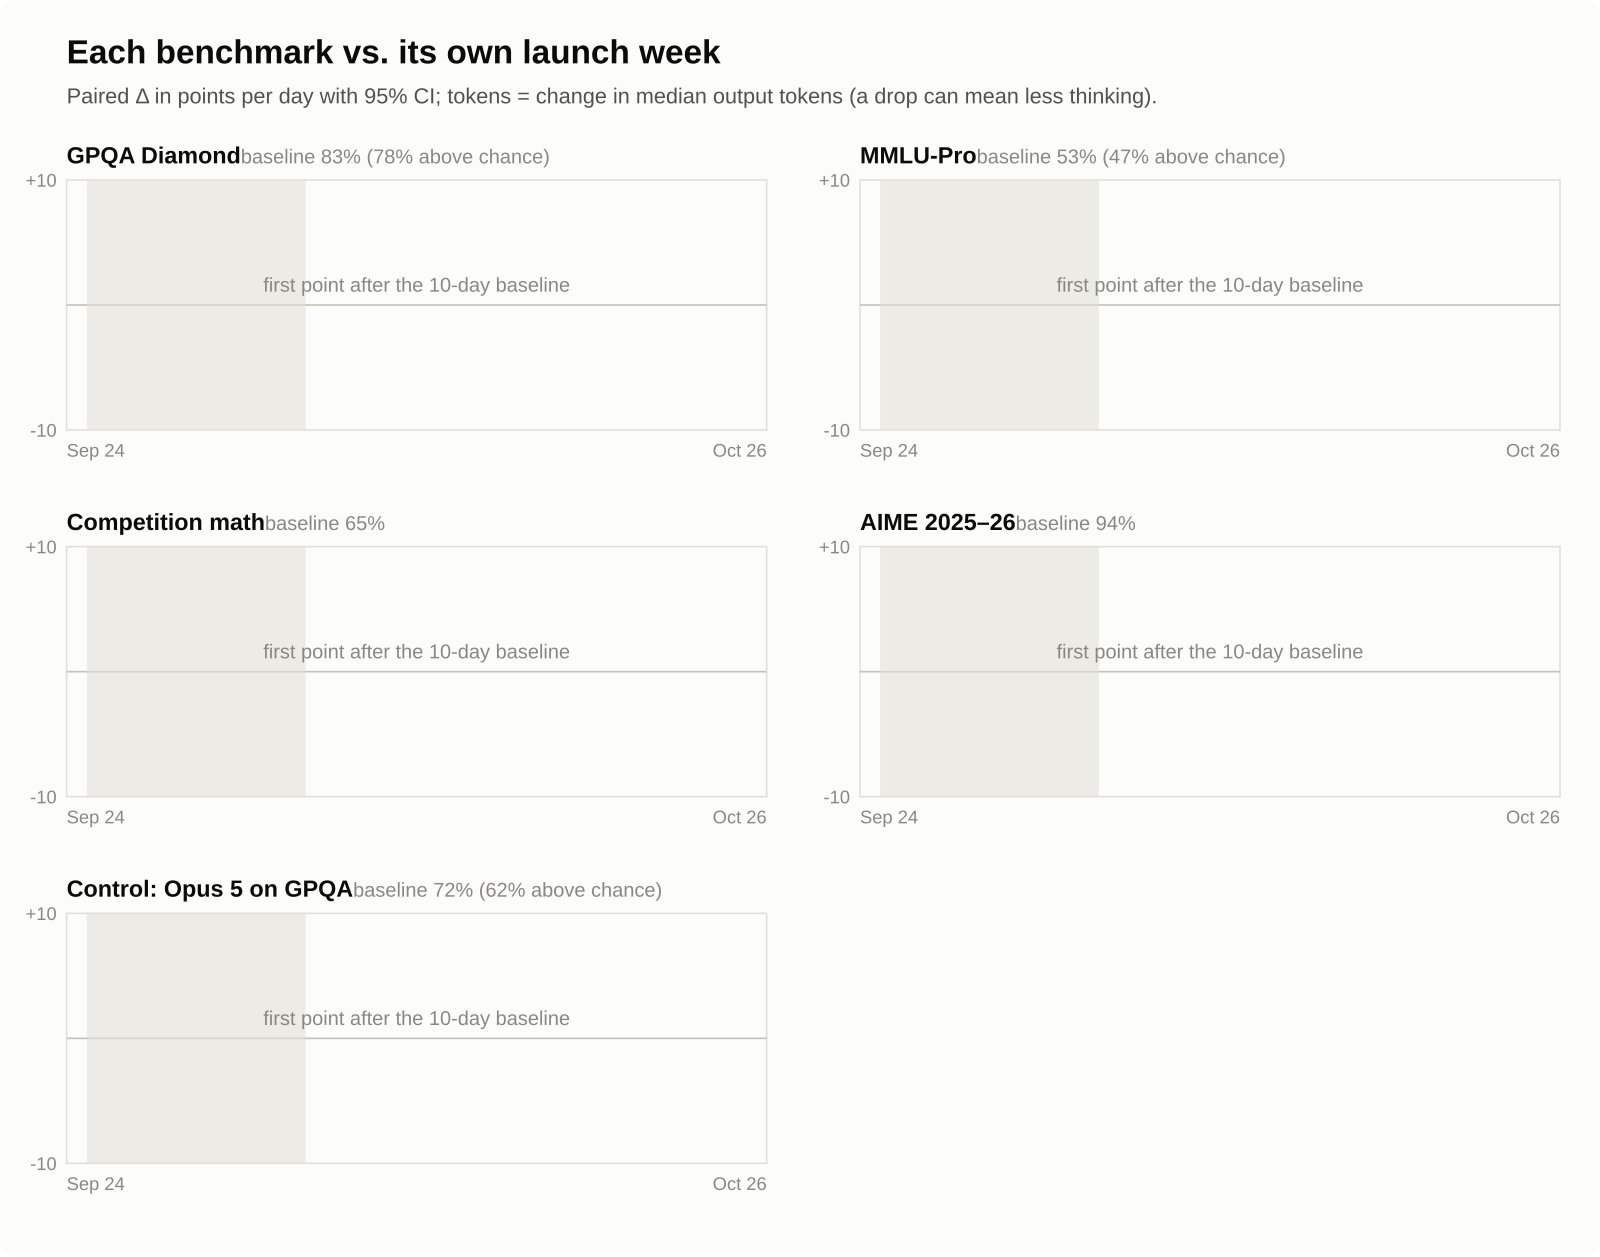 图:各 benchmark 家族与对照臂相对自身基线的位移,以及输出 token 变化。来源:livenerf 仓库
怀疑论与体验派分道扬镳
在 Hacker News 盖起的高楼里,怀疑派拿出了一套心理学解释。他们认为用户的感知性能等于实际性能除以心理期望值。随着时间推移和习惯养成,用户对大模型的期望值永远处于单调上升状态。哪怕后端机房里的权重文件一行没改,用户的体感也会不可避免地变差。
再加上新模型刚发布时的蜜月期滤镜,以及人类大脑在随机噪音里强行寻找规律的本能。无数个偶发错误叠加在一起,最终被放大成了系统性退化的铁证。
但实证派并不是空口无凭。作为同赛道测试工具,Nerf Bench 在模型发布当天定下基线,后续偏差超过 10% 就判定为发生了变化。它此前用同样的思路发现了 Opus 4.6 的退化,Anthropic 事后在博客里承认了这次变化。有先例在,外界的怀疑不会因为一次否认就消散。
相信派们也甩出了真金白银换来的经验。有重度开发者发现,美国工作日高峰时段的模型回复质量总是发生崩盘,只有靠改写调度脚本,强行错开美区工作时间,回复水平才能恢复正常。也有团队称把问题反馈给供应商侧之后,这类波动才停住。大家一致指出,这种体验的剧烈波动,在网页版的订阅制通道里远比冰冷的 API 通道常见得多。
还有一条被广泛认可的自我审视逻辑。当开发者刚开始调用新模型时,写提示词高度严谨;一旦双方建立了信任,上下文管理就开始变得松散随意。垃圾输入导致垃圾输出,坏会话自然就成倍增多,但这其实跟模型后端的变动毫无关系。
所有的体感争执,最终都演变成了公说公有理的罗生门。livenerf 扔出这 78 道题,并不是要在今天强行终结相信派或怀疑派的论战。大模型厂商把推理后端封装成不可见的黑盒。要证明盒子里的东西变了,只有拿出从第一天起就被锁死的冷酷基线,以及一套谁也无权篡改的执行规则。
参考链接:
- ninjahawk/livenerf
- Hacker News 讨论