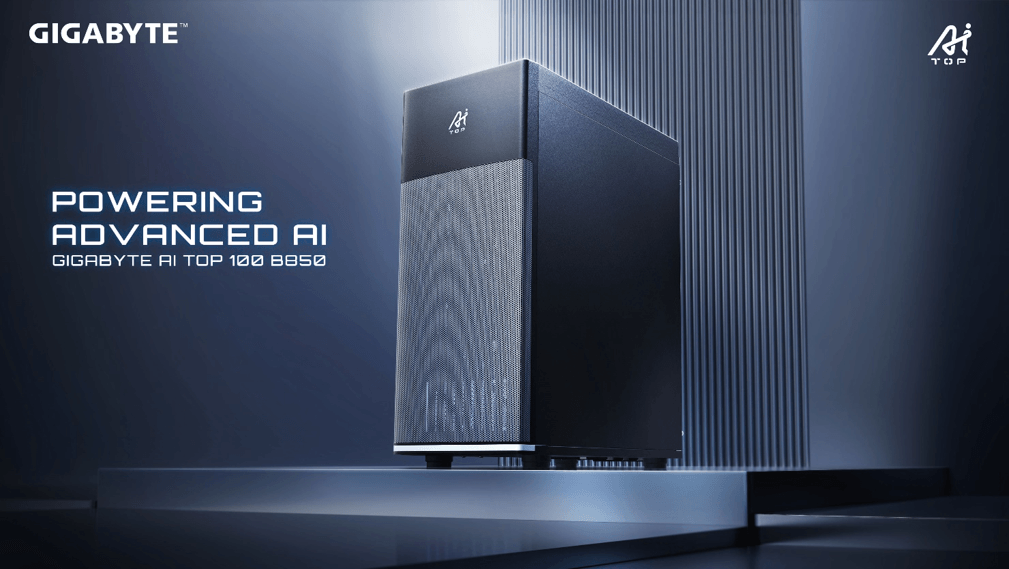
2026 年 10 月 1 日,技嘉正式将顶级消费级显卡塞进了量产工作站。新推出的 AI TOP 100 B850 台式整机上市。它把 NVIDIA GeForce RTX 5090 或双路 AMD Radeon AI PRO R9700 作为开箱即用的算力单元推向了市场。
以往的个人开发者只能自己买零件组装。现在,硬件厂商开始提供开箱即用的完整算力节点。复杂的软硬件调试被直接打包卖给了用户。
整合 5090 与 1600W 电源,算力节点开箱即用
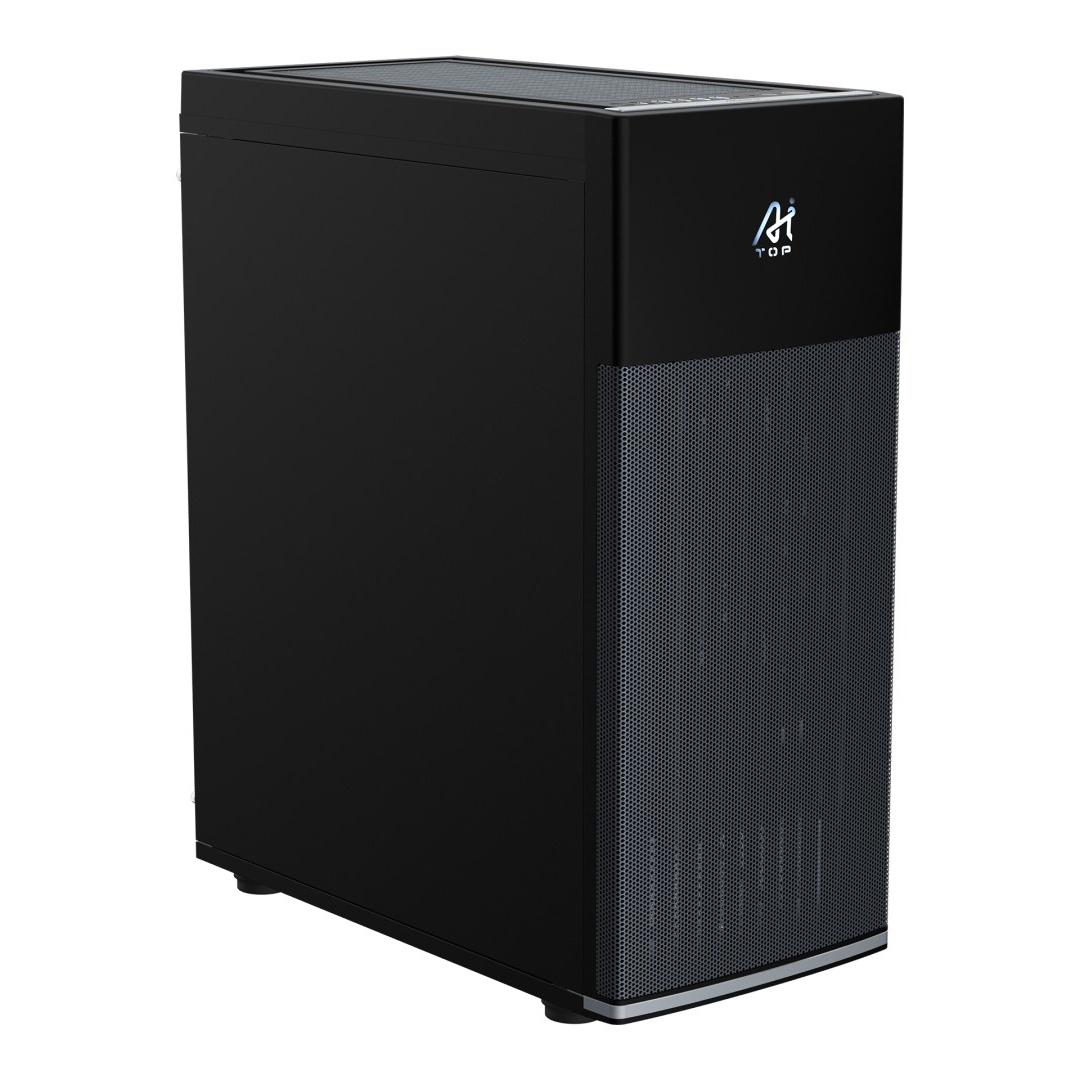
根据 TechPowerUp 披露的规格,AI TOP 100 B850 搭载了 AMD Ryzen 9 9950X 处理器。机器标配 128GB DDR5-5600 内存与 2TB SSD 存储。为了压住这些发热大户,整机配备了 240mm AIO 液冷系统和服务器级别的 1600W 80 PLUS 白金电源。
图:技嘉 AI TOP 100 B850 官方产品图。来源:GIGABYTE 官网
直接交付整套高规格硬件的定价策略非常直白。直接将 1600W 电源和 128GB 内存作为预装标配,技嘉这套方案替开发者承担了排雷主板兼容性、调试内存频率的时间成本。
单卡跑出 64.9 TPS 词元生成率
在核心指标上,AI TOP 100 B850 展现出了强大的本地吞吐能力。技嘉公布的数据显示,5090 单卡配置在运行 32B 参数大模型时,可以实现 64.9 TPS 的词元生成速率。如果选择 R9700 双卡版本,该系统甚至支持 235B 模型的推理和 110B 模型的微调。
图:AI TOP 软件界面监控数据展示。来源:GIGABYTE 官网
单卡 64.9 TPS 的速度追平甚至超越了许多云端 API 的响应延迟。本地设备能以这种速率输出内容。开发者在进行多轮对话测试和复杂 Prompt 调试时,无需再忍受网络波动带来的断连。
免交租金,把测试环境搬回本地
在技嘉的 AI TOP 生态链中,B850 被定位在中端,专门针对小型团队和个人开发者。它预装了 AI TOP Utility 软件。界面提供直观的数据集管理和模型微调工作流。
将训练和推理搬回本地的根本驱动力是成本结构。租用云端 H100 确实拥有更高的算力上限,但按小时计费的模式天然自带心理压力。买断制的 AI TOP 100 让算力脱离了云服务的流量计费表。开发者可以毫无顾忌地跑满 24 小时进行本地微调,数据也永远不会离开这台机器的硬盘。
挑战 1600W 供电与桌面散热极限
硬件堆料的背后是物理定律的硬性约束。技嘉试图将这台机器定义为办公桌上的 AI 中心。然而,1600W 的电源满载时足以让它成为桌面上的小型加热器。
双显卡并联加上顶级 CPU 的发热量,对机箱风道和环境温度提出了严苛要求。消费级架构在冲击企业级算力时,能耗比依然是难以跨越的物理屏障。桌面算力站的极限不仅在于你能塞进几张卡,还在于办公室的插座能不能承受长期的满载运行。
当 RTX 5090 被组装成开箱即用的整机摆上桌面,消费级硬件完成了一次身份转换。它的核心角色已经转变为个人开发者手里不用交租金的生产力基建。
参考链接:
- GIGABYTE AI TOP 100 B850: Hardware details and specifications