改一行 nginx.conf,执行 systemctl reload nginx,命令瞬间返回,页面照常打开——很多运维新手由此认定 reload 是”零感知”的。这个认知只对了一半:reload 靠的是旧 worker 和新 worker 之间的一次接力,存量连接确实不断,但接力过程有三个公认的失效场景。本文把 reload 的完整机制拆开讲清楚,顺带把 Nginx 的 6 个信号一次说全。
master 与 worker 分工,reload 才能成立
先看进程模型。一台跑着 Nginx 的服务器上,进程关系长这样:
ps -eo pid,ppid,user,cmd | grep nginx 1123 1 root nginx: master process /usr/sbin/nginx -g daemon on; master_process on;
1124 1123 www-data nginx: worker process
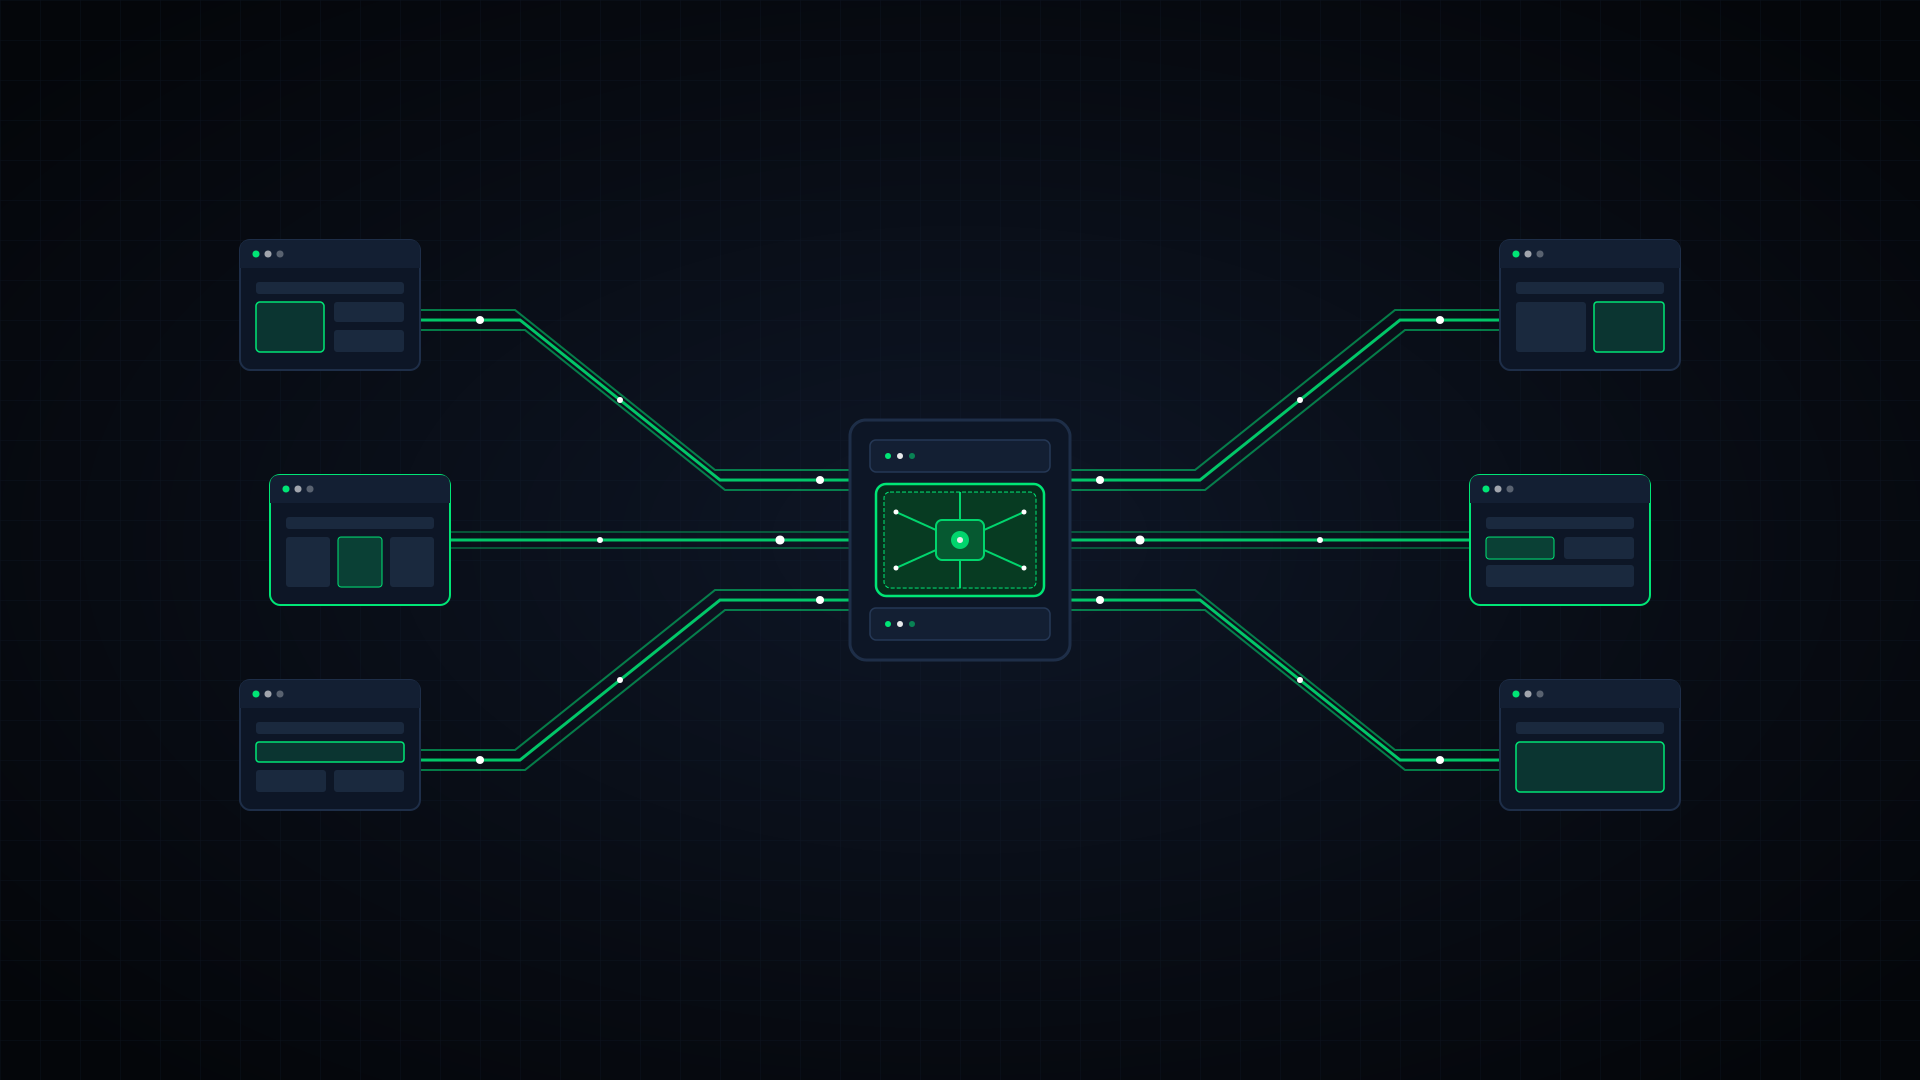
1125 1123 www-data nginx: worker processmaster 进程以 root 运行,不处理任何请求。它只干四件事:读配置、绑定 80/443 这类特权端口、管理 worker 的生命周期、响应信号。worker 以 www-data 身份运行,每个 worker 用事件循环同时处理上千个连接,Nginx 的性能就来自这里。
这个分工是 reload 能成立的根基:监听 socket 归 master 持有。旧 worker 退出、新 worker 启动,监听 socket 始终在 master 手里,内核队列里积压的连接一个都不会丢。
master 的进程号写在 pid 文件里,Ubuntu 打包默认是 /run/nginx.pid。后面所有信号操作都以它为目标。
6 个信号各管一件事
master 进程支持的信号一共 6 组,用途互不重叠:
| 信号 | 作用 | 典型命令 |
|---|---|---|
| TERM、INT | 立即退出,正在处理的请求被掐断 | nginx -s stop |
| QUIT | 优雅退出:处理完存量请求再走 | nginx -s quit |
| HUP | 重读配置,用新配置换掉旧 worker | nginx -s reload |
| USR1 | 重新打开日志文件,日志切割后用 | nginx -s reopen |
| USR2 | 平滑升级二进制(新 master 与旧 master 并存) | kill -USR2 <master_pid> |
| WINCH | 让 master 通知自己的 worker 优雅退出 | kill -WINCH <master_pid> |
worker 也响应 TERM、QUIT、USR1、WINCH,但正常运维不需要直接给 worker 发信号,操作都落在 master 上。
平时用的 systemctl reload nginx 内部执行的就是 nginx -s reload,它做的事是读 pid 文件、给 master 发 HUP。手动方式等价:
kill -HUP "$(cat /run/nginx.pid)"对信号语义不熟的读者,可以配合《Linux 信号详解:kill/TERM/HUP 各自该用在什么场景》一起看。
reload 内部走五步接力
给 master 发 HUP 之后,内部按固定顺序走五步,每一步失败都有对应行为:
- 校验配置。master 先解析
nginx.conf及其 include 的全部文件。语法或指令参数有错,直接终止这次 reload,旧配置原样生效。这是 reload 比 restart 安全的核心原因:配置错了服务不会挂。 - 尝试应用新配置。打开新配置里声明的日志文件、尝试绑定新出现的监听地址和端口。任何一步失败(比如端口被别的进程占了),同样回滚,继续用旧配置跑。
- 启动新 worker。新配置全部生效后,master 按新配置的
worker_processes数量拉起一批新 worker,监听 socket 直接传给它们——不需要重新 bind,所以没有端口空窗期。 - 通知旧 worker 退出。master 给旧 worker 发消息,要求它们优雅关闭。
- 旧 worker 收尾。旧 worker 关闭自己监听的 socket(从此不再接新连接),继续处理手里已建立的连接,全部处理完才退出进程。
ps 里能看到这个接力的中间态——旧 worker 的命令行会短暂变成 nginx: worker process is shutting down。流量大的服务器上这个状态可能持续几秒甚至更久,属于正常现象。
注意第 5 步的一个细节:旧 worker 会一直保留已建立的 keep-alive 连接,直到连接空闲超时。普通网页流量几秒内就消化完,所以体感上 reload 就是瞬间完成。
三个场景会让 reload 变成”事故”
配置语义错了,reload 照样成功
HUP 只校验语法。proxy_pass 指向一个已经下线的 upstream、root 写错路径、证书文件权限不对——这些语法全部合法,校验通过,新 worker 带着错误配置上线,线上立刻 502 或 404。所以 reload 前永远先跑:
nginx -t && systemctl reload nginxnginx -t 也只查语法和文件可达性,查不出业务逻辑错误,但它能拦住最常见的那批手滑。真 reload 出问题后,改回旧配置再 reload 一次就能恢复,回滚成本很低。
长连接拖住旧 worker 不退
WebSocket 这类长连接建立后可能几小时不活动结束,旧 worker 会一直带着这些连接活着。表现为:reload 之后 ps 里几个 is shutting down 的进程挂几十分钟不消失,systemctl 返回正常但进程数翻倍。
Nginx 从 1.11.11 起提供 worker_shutdown_timeout 指令,给旧 worker 的退出过程设一个硬上限,超时后强制断掉存量连接:
# http 块
worker_shutdown_timeout 30s;代价是超时时刻仍挂着的长连接被切断。配合《Nginx 反向代理 WebSocket:60 秒断连排查与修复》里的心跳保活配置,把断连窗口控制在业务可接受的范围内。
QUIC 连接 reload 后保不住
HTTP/3 的 QUIC 连接基于 UDP,reload 时旧 worker 的 QUIC 连接状态不会自动迁移到新 worker,客户端会重连。官方的解法是启用 quic_bpf 模块,让内核层面把 QUIC 包转发到新 worker,连接才得以保留。目前对绝大多数站点,QUIC 重连造成的体验损失很小,这条可以排在优化清单末尾。
顺带认识 USR1 和 USR2
理解了 HUP 的接力模型,另外两个信号就好懂了,它们复用同一套机制。
USR1 用于日志切割。logrotate 或自己写的切割脚本先把日志 mv 改名——旧 worker 还握着被改名文件的句柄,继续往里写。发 USR1 后,master 和所有 worker 关闭旧句柄、按配置里的新路径重新打开文件,旧文件立刻可以被压缩归档。这就是《logrotate 日志轮转:配置语法与自定义规则》里 postrotate 那段脚本的原理。
USR2 用于平滑升级二进制。替换二进制文件后发 USR2,master 把 pid 文件改名加 .oldbin 后缀,再用新二进制启动一套全新的 master + worker,新旧两套进程并存,共享监听 socket。确认新版本正常后给旧 master 发 QUIT 让它退场;新版有 bug,给旧 master 发 HUP 就能拉起旧版 worker 救场。这套流程让升级 Nginx 不停机,但操作步骤比 reload 多,建议先在测试机演练。
常见问题
reload 之后旧 worker 一直不退出,怎么办?
大概率是长连接拖住的。查 ps 确认进程状态是 is shutting down,配置 worker_shutdown_timeout 设上限;或者找到持有连接的客户端,让它断开重连。
reload 和 restart 到底选哪个? 改配置用 reload;Nginx 进程本身异常(worker 全部崩溃、master 挂死)才 restart。restart 会杀掉 master 重建,所有存量连接断开,还包括一次真实的端口释放和重绑。日常运维里 restart 出现的频率应该接近于零。
执行 nginx -s reload 报 “open() /run/nginx.pid failed”?
说明 pid 文件不存在或路径对不上,常见于手动编译安装和系统包混用:编译版默认 pid 路径是编译时指定的,与 systemd unit 里的不一致。用 ps 找到真实的 master pid,kill -HUP 直接发信号,再统一 pid 路径配置。
reload 成功但站点返回 502?
新配置里有语义错误,多半是 proxy_pass 指向的 upstream 不可达。恢复旧配置文件,再 reload 一次即可回滚,然后用 curl -v 直接探测后端地址定位问题。
结尾
reload 的机制本身不难:master 校验配置、换 worker、监听 socket 从不放手。真正要记住的是边界——语法校验拦不住语义错误,长连接会让旧 worker 拖尾,QUIC 连接默认不迁移。把 nginx -t 固化成 reload 前的固定动作,把 worker_shutdown_timeout 写进有长连接业务的配置,这两个习惯能让 reload 在绝大多数场景下真正做到无感。