2026 年 11 月 7 日,Geekbench 测试库收录了两款 AMD Zen 6 移动芯片工程样本,内部代号 Medusa Point。新芯片没有按常规扩充缓存,反而进行了反常剪裁。六核与八核版本采用非对称核心排布。三级缓存容量更被压缩至 4MB 与 8MB。先进制程晶体管密度大幅提升,核心缓存却出现缩水。
两款样本运行于联想测试机上,安装 Windows 11 专业版系统。平台信息标明芯片归属 Medusa Point 2/3 分支。此前流出的十核样本则属于 Medusa Point 1 系列。测试基准频率被压在 2.0GHz 上下。低频跑分没有反映满血性能,但硬件底层拓扑已清晰呈现。
移动平台堆砌通用大核与海量缓存的做法正在松动。面对掌机与便携本的严苛散热空间,芯片厂转入物理级定向减重路线。
4MB与8MB缓存打破代际常规
六核工程样本展现出罕见的内部拓扑。Geekbench 数据显示该芯片具备 12 线程。集群由 1 个高性能大核搭配 5 个能效核。二级缓存总量为 6MB,每颗核心独享 1MB。共享三级缓存容量仅为 4MB。
八核样本同样采取了削减缓存的策略。芯片配置 16 线程,拥有 2 个高性能大核加 6 个能效核。二级缓存总量达到 8MB。共享三级缓存同样定格在 8MB。二级与三级缓存维持一比一配比。过往三级缓存至少两倍于二级缓存的行业惯例被打破。
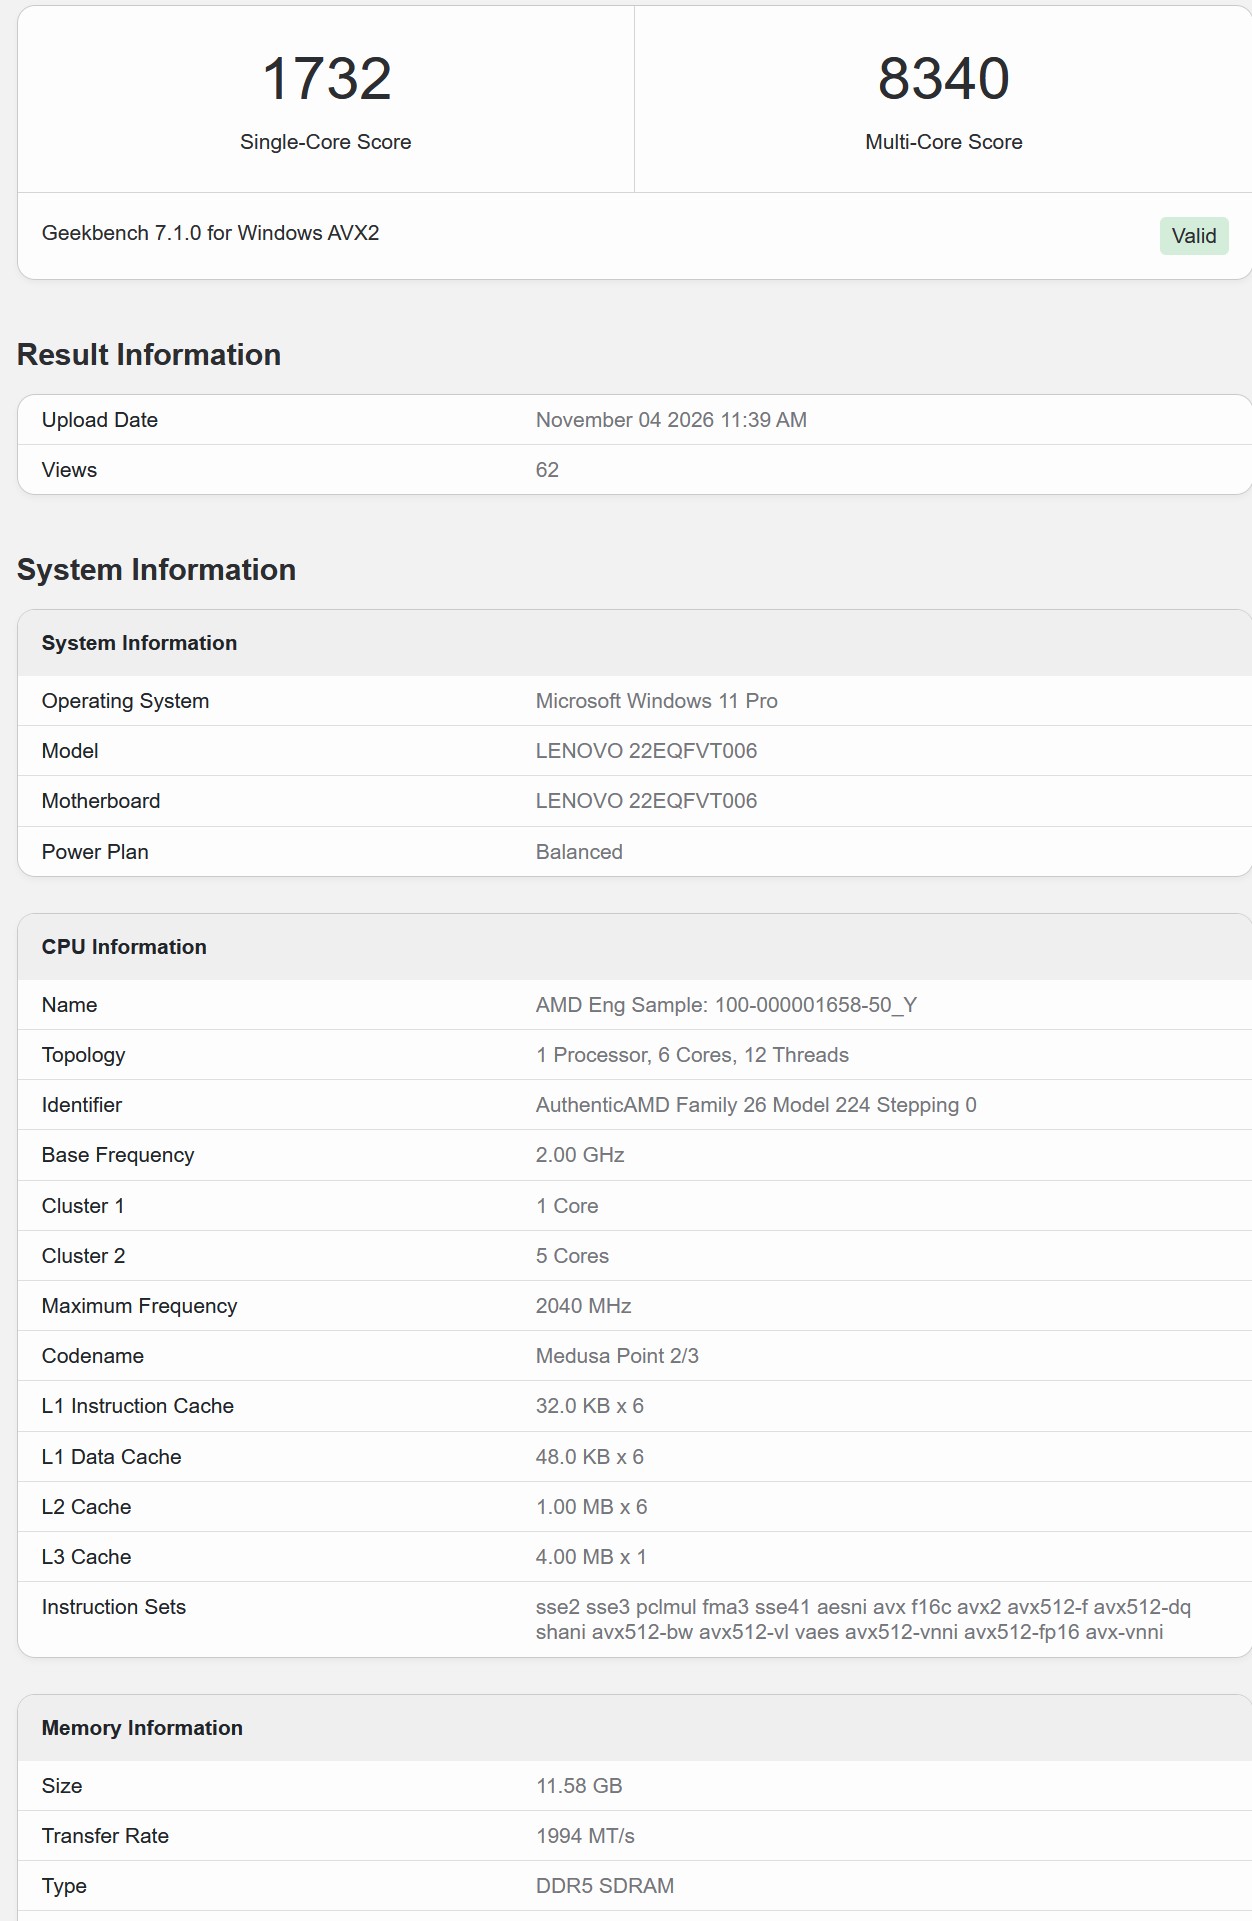 图:Geekbench 数据库曝光的 6 核 12 线程 Medusa Point 工程样本参数。来源:Geekbench
对比前几代产品更能看清变化幅度。Zen 4 架构的 Phoenix 与 Hawk Point 移动处理器,八核型号标配 16MB 三级缓存。Zen 5 架构的 Strix Point 移动平台,十二核型号更具备 24MB 三级缓存。Medusa Point 在中低端规格上直接将三级缓存腰斩。
缓存倒挂反映出层级调优逻辑。大缓存对重载多线程运算有帮助,但存储阵列通电带来持续的静态漏电。将三级缓存削减至 4MB 与 8MB,让芯片在轻负载时关闭无效漏电通道。
1+5与2+6异构重构轻负载功耗
除精简缓存外,两款芯片的核心集群同样打破常规。传统八核通常采用全大核或四加四对称异构。六核新芯片采用 1 个 Zen 6 大核配 5 个 Zen 6c 紧凑核。八核新芯片则采用 2 个 Zen 6 大核配 6 个 Zen 6c 紧凑核。
测试记录显示样本仍处于早期调试阶段。六核样本在 Geekbench 7 单核测试跑出 1732,多核跑出 8340。八核样本单核跑出 2889,多核成绩达到 15099。早前曝光的十核样本曾取得 3100 与 18313。各档位型号在性能释放上形成了分明梯队。
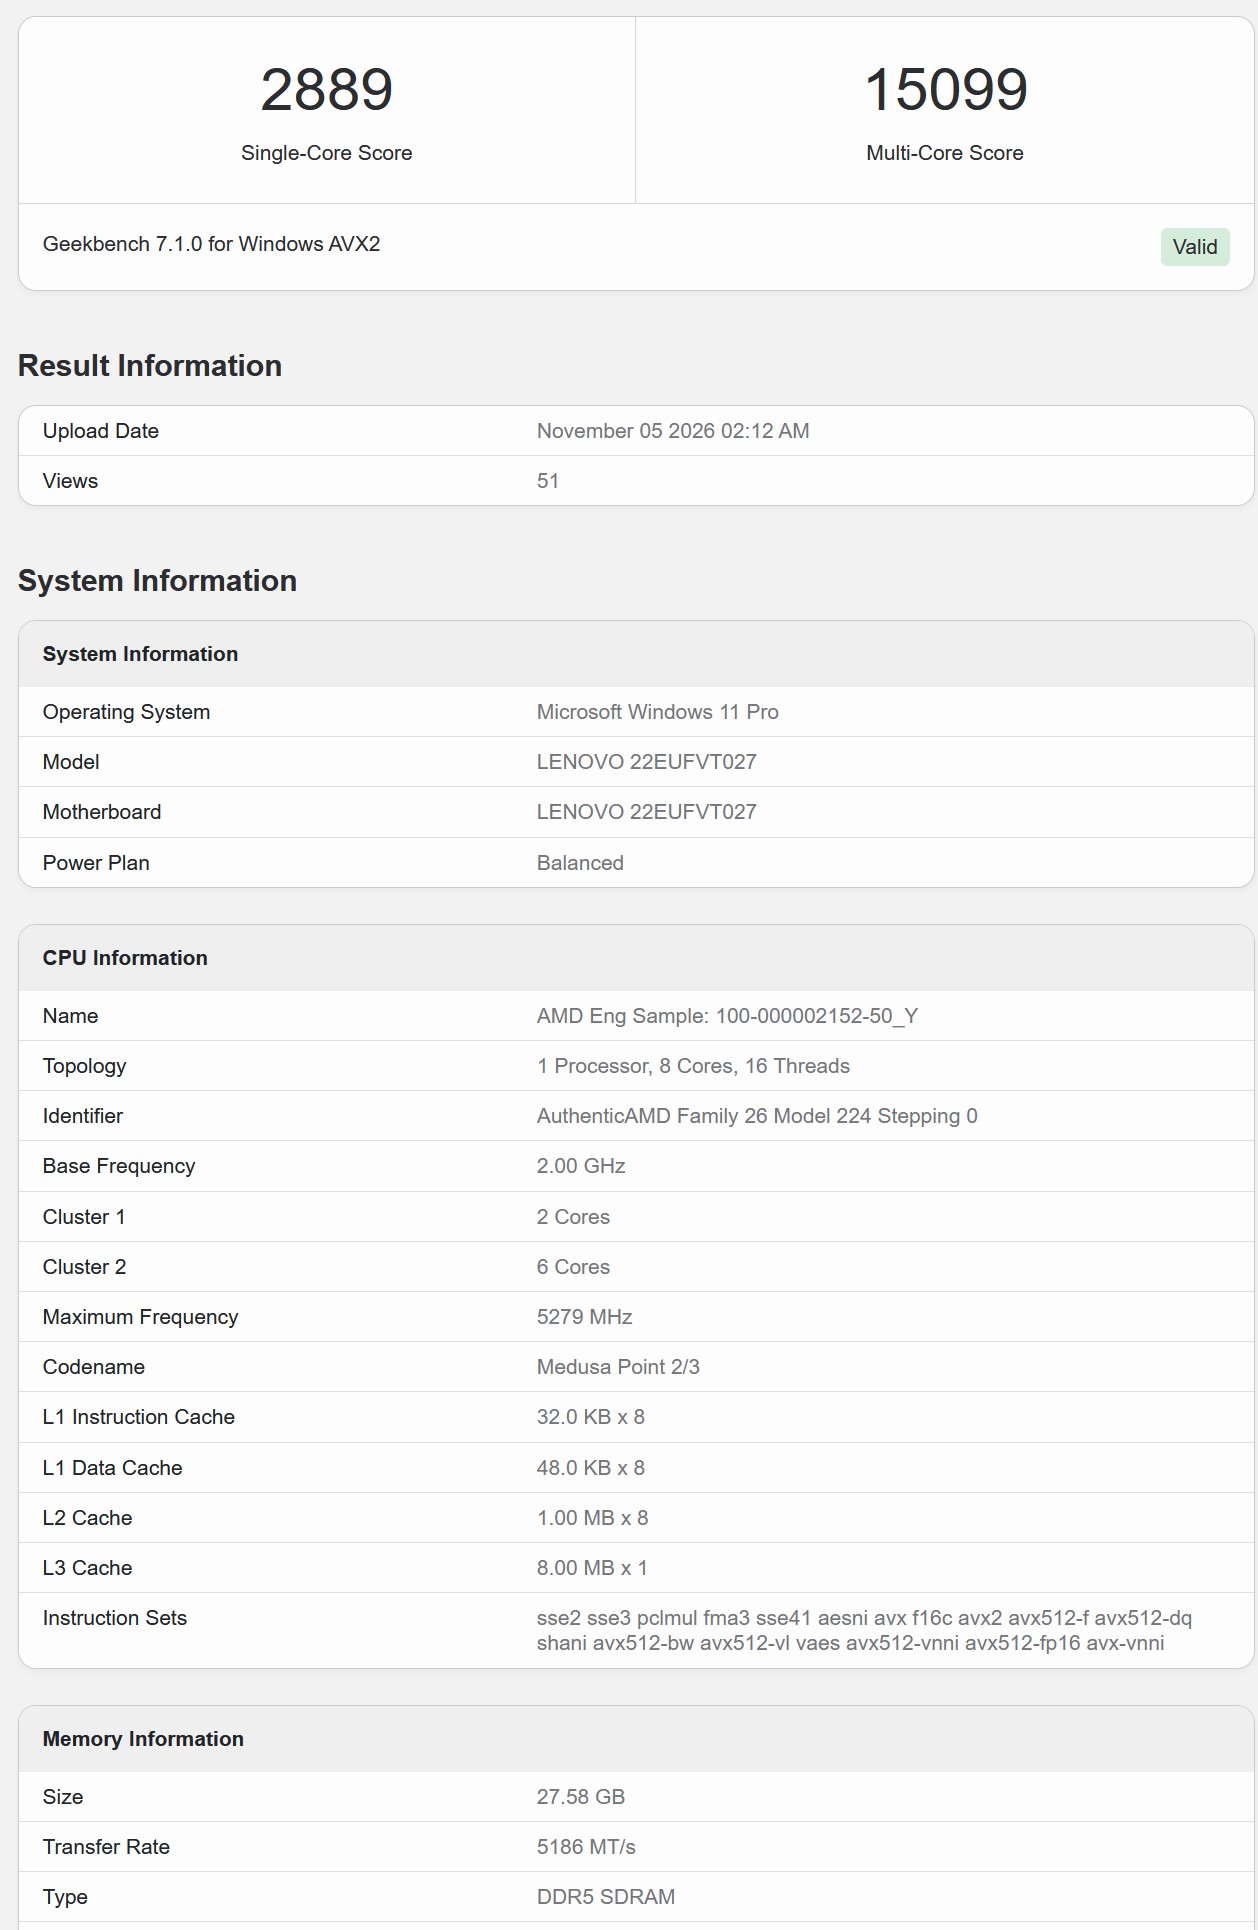 图:Geekbench 数据库曝光的 8 核 16 线程 Medusa Point 工程样本参数。来源:Geekbench
移动设备日常工况多为单线程瞬时突发。网页加载、系统滑动与文档输入只需单核冲刺高频。背景驻留服务对峰值算力需求不高。
**1+5 与 2+6 的非对称结构将大核数量压至最低。**突发高频计算交给 1 到 2 颗 Zen 6 核心。背景多线程负载引流至 Zen 6c 紧凑核。多大核并发带来的发热与电压争抢被物理隔离消除。
2nm台积电晶圆逼退通用堆核
芯片架构调整背后,先进制程的账本是关键推手。AMD 曾在财务分析师日确认,Zen 6 架构将于 2026 年采用台积电 2nm 级工艺。先进制程虽提升了开关速度,但微缩红利已明显放缓。
半导体产业正遭遇 SRAM 面积微缩停滞。从台积电 3nm 推进至 2nm 工艺,SRAM 单元面积缩减率不足 5%。逻辑晶体管密度虽提升约 15%,缓存单元占用面积却难以下降。先进制程晶圆被大面积缓存占据,产出收益不成比例。
半导体供应链预估,台积电 2nm 晶圆单片报价超过 3 万美元。若在移动端铺设 16MB 至 32MB 缓存,裸片面积将居高不下。高制造成本最终会转嫁给终端买单。
通用大核同样吃掉大量硅片面积。Zen 6c 紧凑核缩减了执行单元间距,精简了分支预测结构。紧凑核保留了完整指令集,同时大幅压缩了物理占板空间。精简 SRAM 阵列并用高密度紧凑核替代大核,是平衡 2nm 制程面积成本的务实解法。
掌机与轻薄本严控15W续航红线
物理层面的精简,直接让便携终端受益。随着 Steam Deck 与各类 Windows 掌机普及,15W 到 28W 低功耗区间竞争激烈。
便携设备受限于电池体积,整机电池容量大多落在 50Wh 到 80Wh 之间。在总功耗被焊死的前提下,通用大核与海量缓存成了能效负担。过往全大核芯片在 15W 工况下,多核频率被迫工作在低效区间。
Medusa Point 2/3 的物理瘦身为掌机与轻薄本量身定制。1+5 架构可以在掌机低画质锁帧运行时,仅靠紧凑核心维持开销。腾出的功耗预算可以完整交给核显与 NPU。
掌机运行对 CPU 算力的需求存在边界。多数游戏对 CPU 核心数依赖适度,但对图形核心供电异常敏感。将算力面积让给核显,能直接改善手持设备的帧率稳定度与机身发热。
移动芯片竞争重回能效基准
业界对这次缓存削减存在不同看法。部分开发者担忧,削减三级缓存可能降低特定高负载或老旧编译任务的执行效率。支持者则指出,搭配高频 LPDDR5X 内存后,轻量化缓存足以覆盖日常交互需求。在有限电池容量面前,多余缓存带来的静态功耗损失远大于微弱的单项性能增益。
Medusa Point 样本的露面标志着策略转变。AMD 不再强求全线采用统一大芯片方案,而是按功耗区间定点精简。高端 Medusa Halo 与 Medusa Point 1 负责争夺性能标杆。精简版 Medusa Point 2/3 则深耕主流走量市场。
先进制程的高昂成本挤压了堆料空间。芯片设计必须在有限面积内榨取每一毫瓦电力的产出。告别账面参数膨胀并转向以场景能效比为核心的物理定制,成为移动计算平台演进的务实法则。
参考链接:
- Notebookcheck 独家报道
- Geekbench 7 跑分数据库记录