49999 元的官方定价标牌贴在机箱侧面,打破了国内迷你主机市场长期维持的千元价格认知。2026 年 10 月 11 日,磐镭正式开售搭载 AMD 锐龙 AI Max+ PRO 495 处理器的 YO2 旗舰迷你工作站。192GB 内存配上 2TB 固态硬盘的顶配组合,把这台巴掌大小的设备推到了聚光灯下。
在过去的消费硬件谱系中,迷你主机通常被视为家用影音、软路由或轻度文字办公的低成本方案。磐镭此次直接瞄准企业研发与开发者群体的端侧算力需求。这台小机器允许将最高 160GB 统一内存动态划拨为 GPU 显存,正面迎战本地大语言模型的参数加载难题。
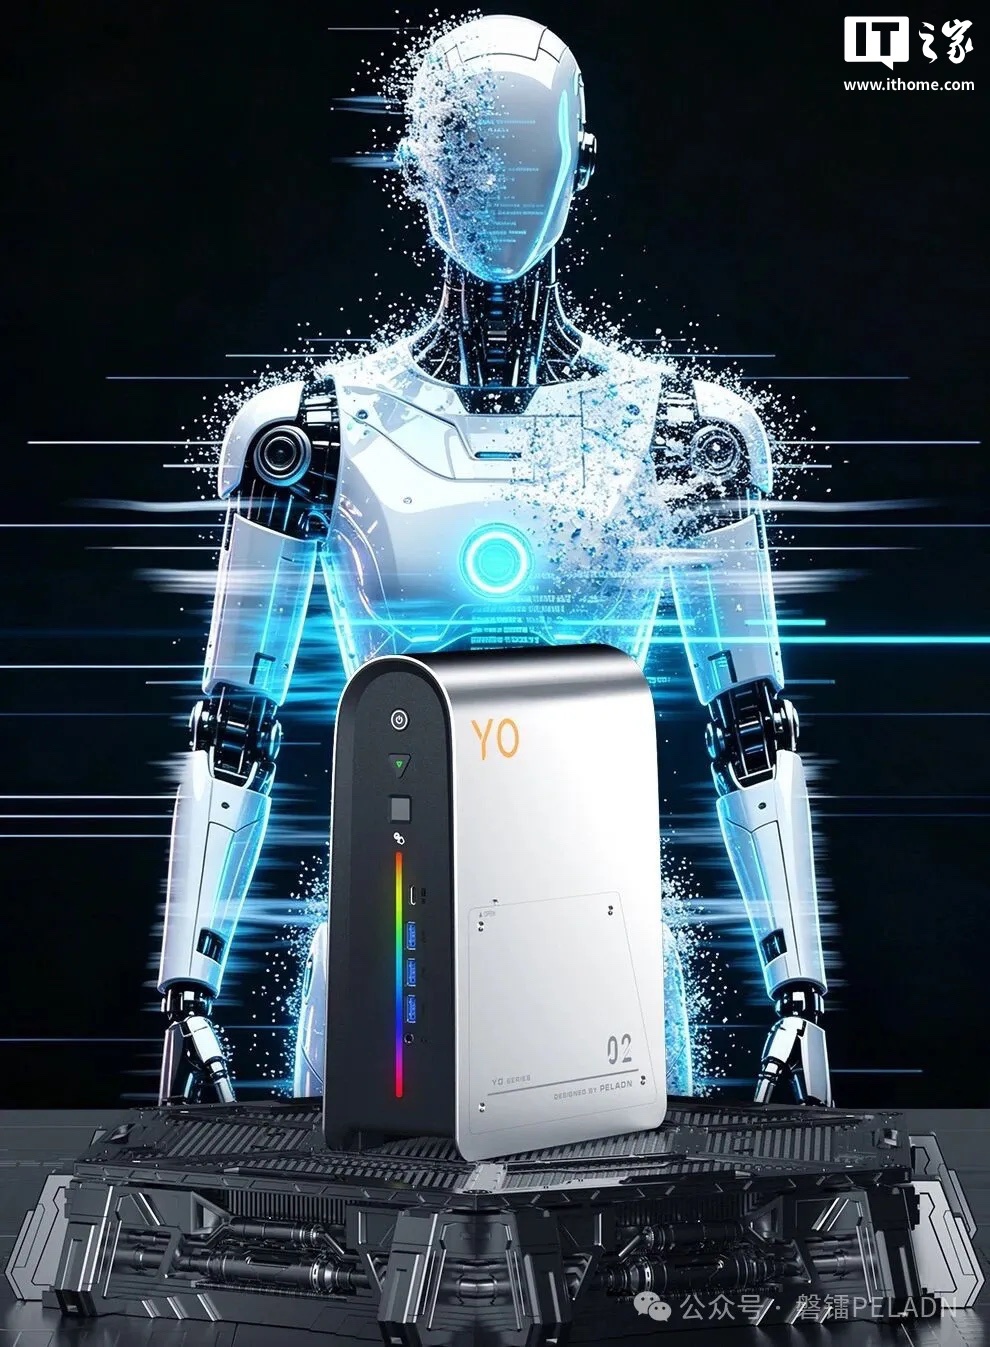 图:磐镭正式上架 YO2 旗舰迷你工作站,标配 192GB 内存。来源:磐镭官方商城
192GB 统一内存打破消费级显卡 24GB 显存天花板
在桌面端部署大语言模型,开发者遇到的第一道物理高墙永远是显存容量。主流消费级独立显卡如英伟达 RTX 4090 仅提供 24GB GDDR6X 显存。如果要完整加载一个 70B 参数的量化模型,权重文件便占据接近 40GB 空间。消费级单卡用户只能被迫选择四卡互联或忍受极小参数模型。
企业级专业卡虽然显存充足,单张拥有 48GB 显存的 RTX 6000 Ada 售价却高居 5 万元以上。如果搭建多卡工作站,整机采购成本轻松突破 10 万元,同时带来上千瓦的供电开销。高昂的显存成本将多数中小团队挡在私有化大模型的大门之外。
磐镭 YO2 借由 AMD Strix Halo 架构找到了新路径。处理器板载 192GB 四通道 LPDDR5X 统一内存,允许核显直接调用其中 160GB 作为显存使用。在一台桌面小型设备上,用户可以直接拉起 70B 甚至 120B 参数的完整量化模型。显存瓶颈在紧凑机身内部被统一内存架构化解。
40 组图形单元与 160W 散热挤进巴掌大机箱
机器搭载的 AMD 锐龙 AI Max+ PRO 495 属于商用级 APU 旗舰。处理器采用台积电 4nm 制程与 Zen 5 架构,拥有 16 核心 32 线程,最高加速频率达到 5.2GHz。系统内置 55 TOPS 算力的独立 NPU,整机 AI 算力总和达到 131 TOPS。
图形核心方面,芯片集成了基于 RDNA 3.5 架构的 Radeon 8065S 核显。其图形计算单元达到 40 组,运行频率冲至 3000 MHz。这一规格逼近主流独立显卡的流处理器规模,打破了以往核显羸弱的刻板认知。
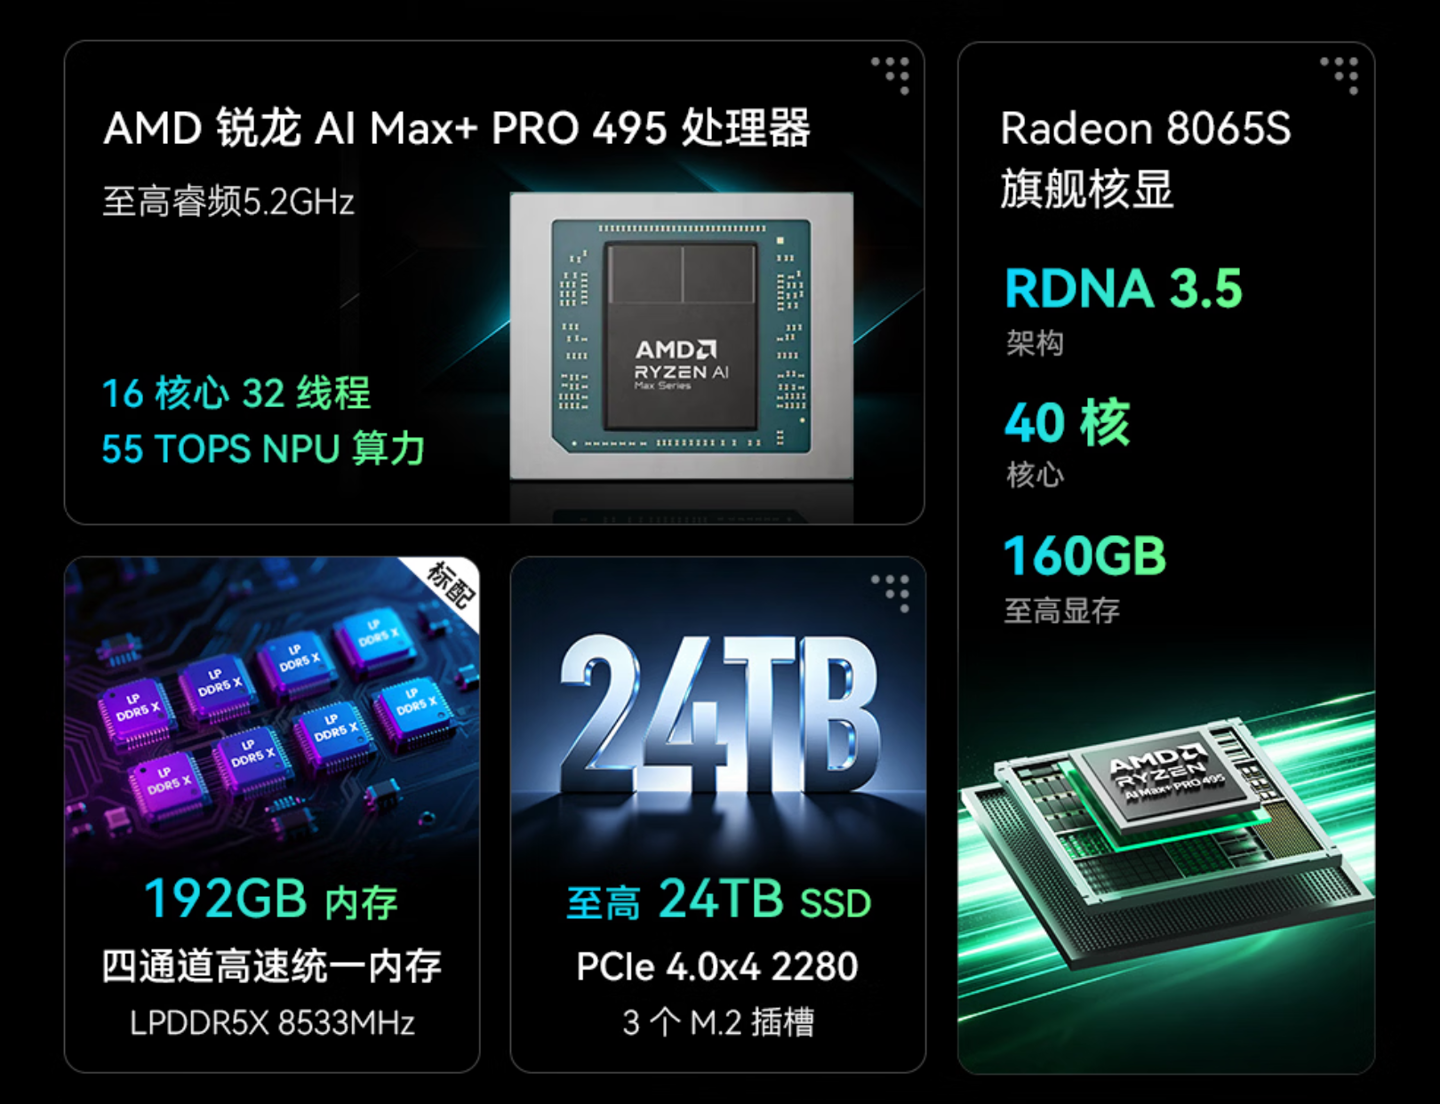 图:处理器集成 16 核 Zen 5 CPU 与 40 组 RDNA 3.5 计算单元。来源:AMD 官方技术白皮书
为了压制高负载计算产生的热量,磐镭设计了双 9020 涡轮风扇配合三根导热铜管,并在主板侧面增设了独立系统风扇。机身面板设有实体切换按键,支持在 55W 静音、85W 均衡与 120W 性能三档模式之间快速跳转。峰值功耗释放能够维持在 160W 阶段。高规格散热模组让迷你主机能够持续吞吐百瓦级功率。
扩展接口配置同样贴近工作站定位。机身集成双 USB4 40Gbps 接口、双 2.5G 有线网口、HDMI 2.1 与 DP 2.0 视频输出,内部还提供 3 个 PCIe 4.0 x4 M.2 插槽。多设备互联协议还支持 4 台主机并联共享显存,构建出最高 640GB 显存池。
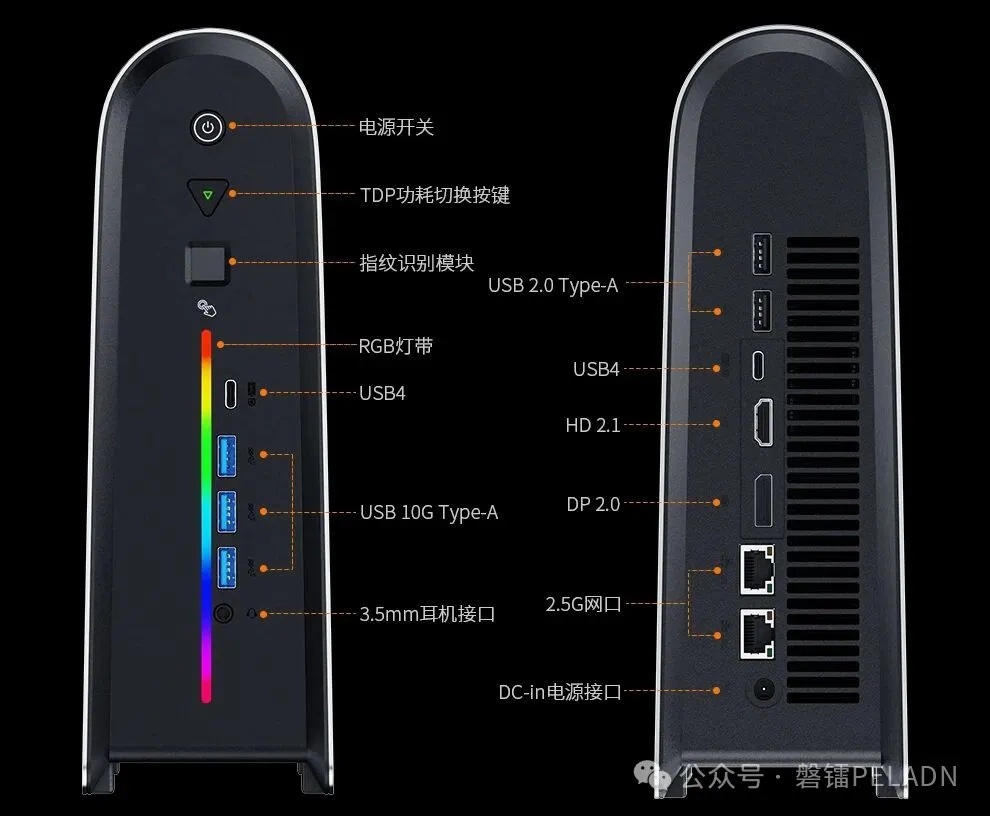 图:双 USB4 接口配合双 2.5G 网口为本地集群互联预留通道。来源:磐镭官方产品说明
273GB/s 内存带宽划出推理吞吐硬边界
尽管 192GB 统一内存在容量上打开了空间,但技术架构依然存在明确物理妥协。大模型在推理生成阶段属于典型的访存密集型任务。每生成一个新 Token,都需要将数十 GB 的模型权重从内存中完整读取一遍。
锐龙 AI Max+ PRO 495 采用 256-bit 显存位宽搭配 LPDDR5X-8533 内存颗粒,提供的理论峰值带宽大约在 273 GB/s。这一数据远高于普通双通道内存的 80 GB/s,但与专业独显相比差距明显。RTX 4090 的显存带宽达到 1008 GB/s,苹果 Mac Studio Ultra 芯片也能提供 800 GB/s。
在 273 GB/s 的带宽限制下,运行 70B 大模型时的文本生成速率基本维持在每秒 4 至 5 个 Token。这种速度能够满足代码单次审查、离线长文本摘要与自动化后台脚本调用,但在高频实时多轮对话场景中会产生肉眼可见的停顿。统一内存解决了模型装不下的难题,但带宽给生成速率划定了上限。
近 5 万元高定价考验企业本地私有化算力账本
围绕 49999 元的定价策略,市场形成了截然不同的算力账本核算方式。
支持者看重本地物理隔离带来的数据确定性。医疗机构、律所与工业设计团队处理敏感数据时,外部公有云 API 存在数据泄露与合规审查风险。5 万元换来一台低噪音、巴掌大、通电即用的本地推理节点,省去了搭建机柜和空调冷气的运维成本。
质疑者指出性价比并不突出。同等 5 万元预算,团队能够自行装配两台搭载双路 RTX 4090 的水冷塔式工作站,拥有更快的 Token 吞吐速度。在云端算力租赁价格持续下探的当下,5 万元采购资金能够购买数亿次商用大模型调用额度。
磐镭是在押注一个新兴细分客群。那些渴望 x86 原生开发环境,又受限于桌面空间的用户,正是这批设备的目标买家。
迷你主机跨过玩具与生产力工具分水岭
从两千元的塑料盒子到五万元的铝合金设备,国内品牌正在推高天花板。零刻、铭凡与磐镭相继推出高规格 APU 工作站,折射出算力分工的深刻变迁。
上游半导体厂商打破传统 CPU 与 GPU 的严苛界限。通过引入超宽位宽统一内存架构,芯片制造商将原本专属于服务器机架的内存容量下放到个人桌面。小体积设备不再只负责分发显示信号,开始具备承载复杂模型的能力。
磐镭 YO2 是这场硬件实验的前哨样本。49999 元或许只是少数专业机构尝鲜的入场券,但它所验证的技术路径已经清晰可见:当桌面小型终端拥有承载百亿参数的能力,本地私有化 AI 的演进脚步便再难停下。
参考链接:
- 磐镭官方商城产品说明
- AMD 锐龙 AI Max+ PRO 官方技术白皮书
- Notebookcheck 报道
- IT之家报道