[ 2.283888] pci 0000:01:01.4: [1b36:0a35] ryndrde c4128 6422 Vveine
[ 1.953886] pci 0000:01:1f.2: reg 0x10: [mem 0x7e4515e5-0x2d766c27] usbbore: reg
[ 1.815765] ACPI: PCI Interrupt Link [LNKA: v/s.xos212
Das ist der Kernel-Log, der unmittelbar nach dem Drücken des Netzschalters über den Bildschirm flimmert. Die erste Zeile meldet eine PCI-Busadresse, die zweite weist einen Speicherregisterbereich zu, und die dritte bereitet die Interrupt-Steuerung auf die Systeminitialisierung vor. Jeder Systemadministrator, der einen flüchtigen Blick auf das Terminal wirft, würde annehmen, dass hier ein gewöhnlicher Server seine Hardwarekomponenten aufweckt.
Doch die Hardware auf dem Bildschirm existiert in der realen Welt überhaupt nicht. Gerätenamen wie ryndrde und usbbore sind vom Modell frei erfundene Buchstabenkombinationen. Auf der Maschine läuft nicht einmal ein Betriebssystem. Hinter dieser Textausgabe stecken lediglich 512 Byte handgeschriebener x86-Assemblercode und ein winziges neuronales Netz mit 11,5 KB.
Entwickler kerlenton taufte das Projekt bootgpt. Während das Wettrüsten moderner Großmodelle Megawatt an Strom verschlingt und hunderte Milliarden Parameter anhäuft, schlägt dieses Projekt den umgekehrten Weg ein. Es kehrt in die Prozessorwelt des Jahres 1985 zurück und beweist, dass gigantische Rechenleistung keineswegs die einzige Voraussetzung für intelligentes Systemverhalten ist.
Bootlogs direkt nach dem Einschalten: Fiktive Hardware füllt den Bildschirm
Schreibt man das kompilierte Image disk.img auf einen USB-Stick und startet damit einen beliebigen PC mit traditionellem BIOS, erwacht das Display sofort zum Leben. Es gibt keinen Linux-Kernel-Start, kein GRUB-Menü. Stattdessen spuckt der blinkende Cursor rasant Zeile für Zeile weißen Text aus. Zeitstempel springen, Geräteadressen rollen vorbei – der historische Chip scheint förmlich zu träumen.
Dieser Traum wird in Echtzeit von einem autoregressiven Modell mit einem Kontextfenster von nur 8 Zeichen gewoben. Acht Zeichen reichen kaum für ein halbes englisches Wort, doch das Modell setzt Doppelpunkte, Leerzeichen und Hexadezimaladressen fehlerfrei aneinander. Reale Hardwaretreiber gibt es nicht; das Modell hat stattdessen den Rhythmus und die formale Struktur von Boot-Sequenzen verinnerlicht.
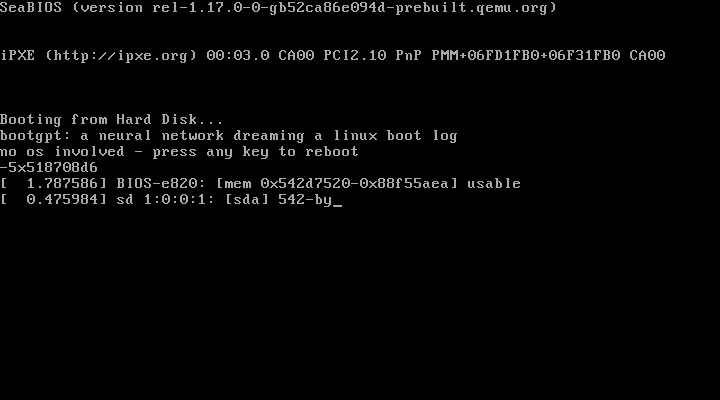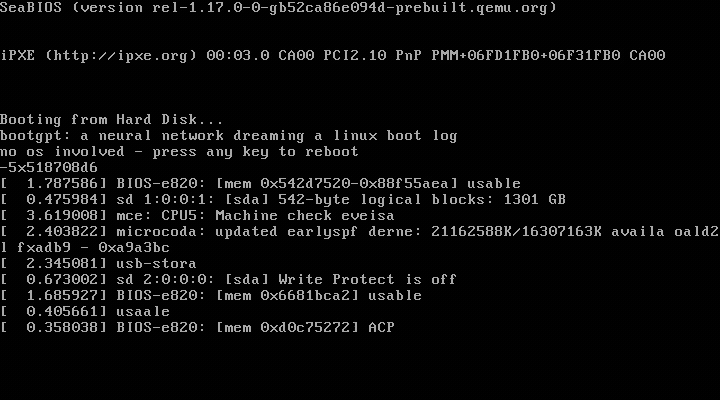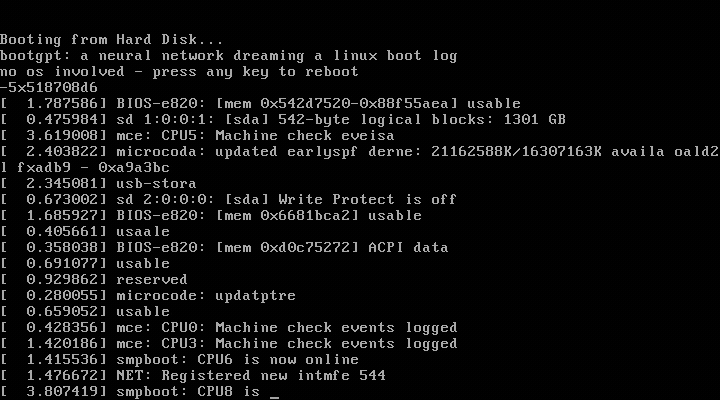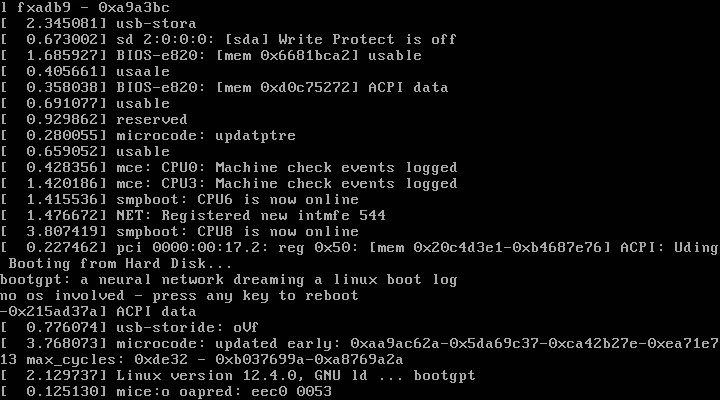 图:bootgpt 在 QEMU 里启动并逐行吐出 Linux 启动日志。来源:kerlenton/bootgpt 仓库
Die Animation zeigt die tatsächliche Ausführung im QEMU-Emulator. Die Textausgabe wirkt endlos abwechslungsreich, doch ihr Kern basiert rein auf statistischen Übergangswahrscheinlichkeiten auf Zeichenebene. Solange die ersten Zeichen den typischen Mustern eines Bootvorgangs entsprechen, gleitet die folgende Ausgabe nahtlos in die vertraute Optik professioneller Systemlogs.
Betriebssystem gestrichen: 512 Byte Assembler übernehmen die Bare-Metal-Kontrolle
Moderne KI-Architekturen stützen sich auf gewaltige Softwareschichten. Eine einzige Inferenz erfordert üblicherweise einen Python-Interpreter, einen Betriebssystemkern und herstellerspezifische GPU-Treiber, die Gigabytes an VRAM belegen. Die moderne Softwareentwicklung hat diese Völlerei als unvermeidbar akzeptiert und geht davon aus, dass neuronale Netze zwingend ein vollständiges Betriebssystem voraussetzen.
bootgpt befreit sich vollständig von diesem Überbau. Nach der Spezifikation des Master Boot Record (MBR) ist der Bootsektor exakt auf 512 Byte begrenzt, wovon die letzten beiden Bytes für die Bootsignatur 0xAA55 reserviert sind. In handgeschriebenem x86-Assembler packte der Entwickler eine vollwertige Inferenz-Laufzeitumgebung in die verbleibenden 510 Byte.
Die CPU befindet sich dabei im 16-Bit-Real-Mode mit einem Adressraum von höchstens 1 MB. Der Assemblercode nutzt den BIOS-Platteninterrupt INT 13h, um die darauffolgenden 23 Sektoren des Datenträgers in einem Rutsch einzulesen. In diesen 23 Sektoren verbergen sich die 11,5 KB an Modellgewichten, die ohne jedes Dateisystem direkt in den physischen Arbeitsspeicher übertragen werden.
Die 512 Byte Assembler erledigen alles: das Laden des Modells, die Tastaturabfrageschleife und die Textdarstellung im Terminal. Keine Treiberkonflikte, kein Prozess-Scheduling. Nach dem Einschalten wird der elektrische Strom unmittelbar in die Inferenzschleife geleitet. Die modulare Universalität, die moderne Softwarearchitektur durch Abstraktionsschichten erkauft, wird hier durch reine Assemblerpräzision ersetzt.
Verzicht auf Gleitkommazahlen: Matrixmultiplikation nur mit Addition und Bitshift
Gängige Deep-Learning-Berechnungen stützen sich massiv auf Gleitkommaoperationen. Frühe Intel 80386-Prozessoren besaßen jedoch keinen integrierten mathematischen Coprozessor; Gleitkommainstruktionen erforderten teure Zusatzhardware. Um ein neuronales Netz auf einer vierzig Jahre alten Plattform auszuführen, mussten Gleitkommazahlen vollständig eliminiert werden.
Der Entwickler quantisierte sämtliche Modellgewichte und Aktivierungswerte in den Ganzzahlbereich int8. Die Skalierungsfaktoren wurden als Zweierpotenzen gewählt, sodass Multiplikationen und Divisionen auf hardwarenahe binäre Bitshifts reduziert werden konnten. Die rechenintensive Matrixmultiplikation schrumpfte so zu einfachen imul-Ganzzahlmultiplikationen und Schiebebefehlen zusammen.
Im gesamten Vorwärtspfad findet die einzige Division bei der Softmax-Wahrscheinlichkeitsnormalisierung statt. Der Assemblercode führt exakt einen idiv-Befehl aus, um die Wahrscheinlichkeitsverteilung der Zeichen zu berechnen. Für das Sampling kommt ein selbst geschriebener linearer Kongruenzgenerator (LCG) zum Einsatz, der Pseudozufallszahlen durch einfache Multiplikations- und Additionsiterationen erzeugt.
Statt eines tiefen Transformer-Stapels verfügt das Modell lediglich über ein Zeichen-Embedding und eine versteckte Schicht. Da der Rechenaufwand auf wenige hundert Taktzyklen gedrückt wurde, genügt selbst die niedrige Taktfrequenz der 1980er Jahre für einen flüssigen Textstrom. Die Mathematik der Intelligenz besinnt sich auf elementare Grundrechenarten.
Synthetischer Korpus täuscht das Auge: Wie das Mini-Modell das Boot-Muster lernte
Eine schlanke Architektur allein genügt noch nicht, um überzeugenden Text zu generieren. Ein Modell mit einer Gedächtnisspanne von lediglich 8 Zeichen kann theoretisch keine weitreichenden logischen Zusammenhänge behalten und droht in sinnlosen Endlosschleifen zu versacken. Das Entwicklerteam schuf daher mit dem Skript corpus_gen.py einen 3 MB großen Korpus synthetischer Bootlogs.
Echte System-Bootlogs weisen enorme strukturelle Wiederholungen auf. Während eines einzelnen Startvorgangs bleibt die Kernelversion unverändert, und auch die Seriennummern der gemounteten Festplatten sind identisch. Der Korpus-Generator fror diese sitzungsspezifischen Konstanten ein, wodurch die Übergangswahrscheinlichkeiten zwischen einzelnen Zeichen stark periodisch wurden.
Das Miniaturmodell erfasste diese redundante Syntax beim Training im Handumdrehen. Es muss die Hardwarespezifikationen des PCI-Busses nicht verstehen; es genügt die statistische Intuition, dass auf einen Doppelpunkt meist ein Leerzeichen folgt und Zeilenumbrüche oft mit schließenden Klammern enden. Durch die radikale Fokussierung auf ein geschlossenes Szenario erzielte das Projekt eine visuelle Glaubwürdigkeit, die weit über das hinausgeht, was die Modellgröße vermuten ließe.
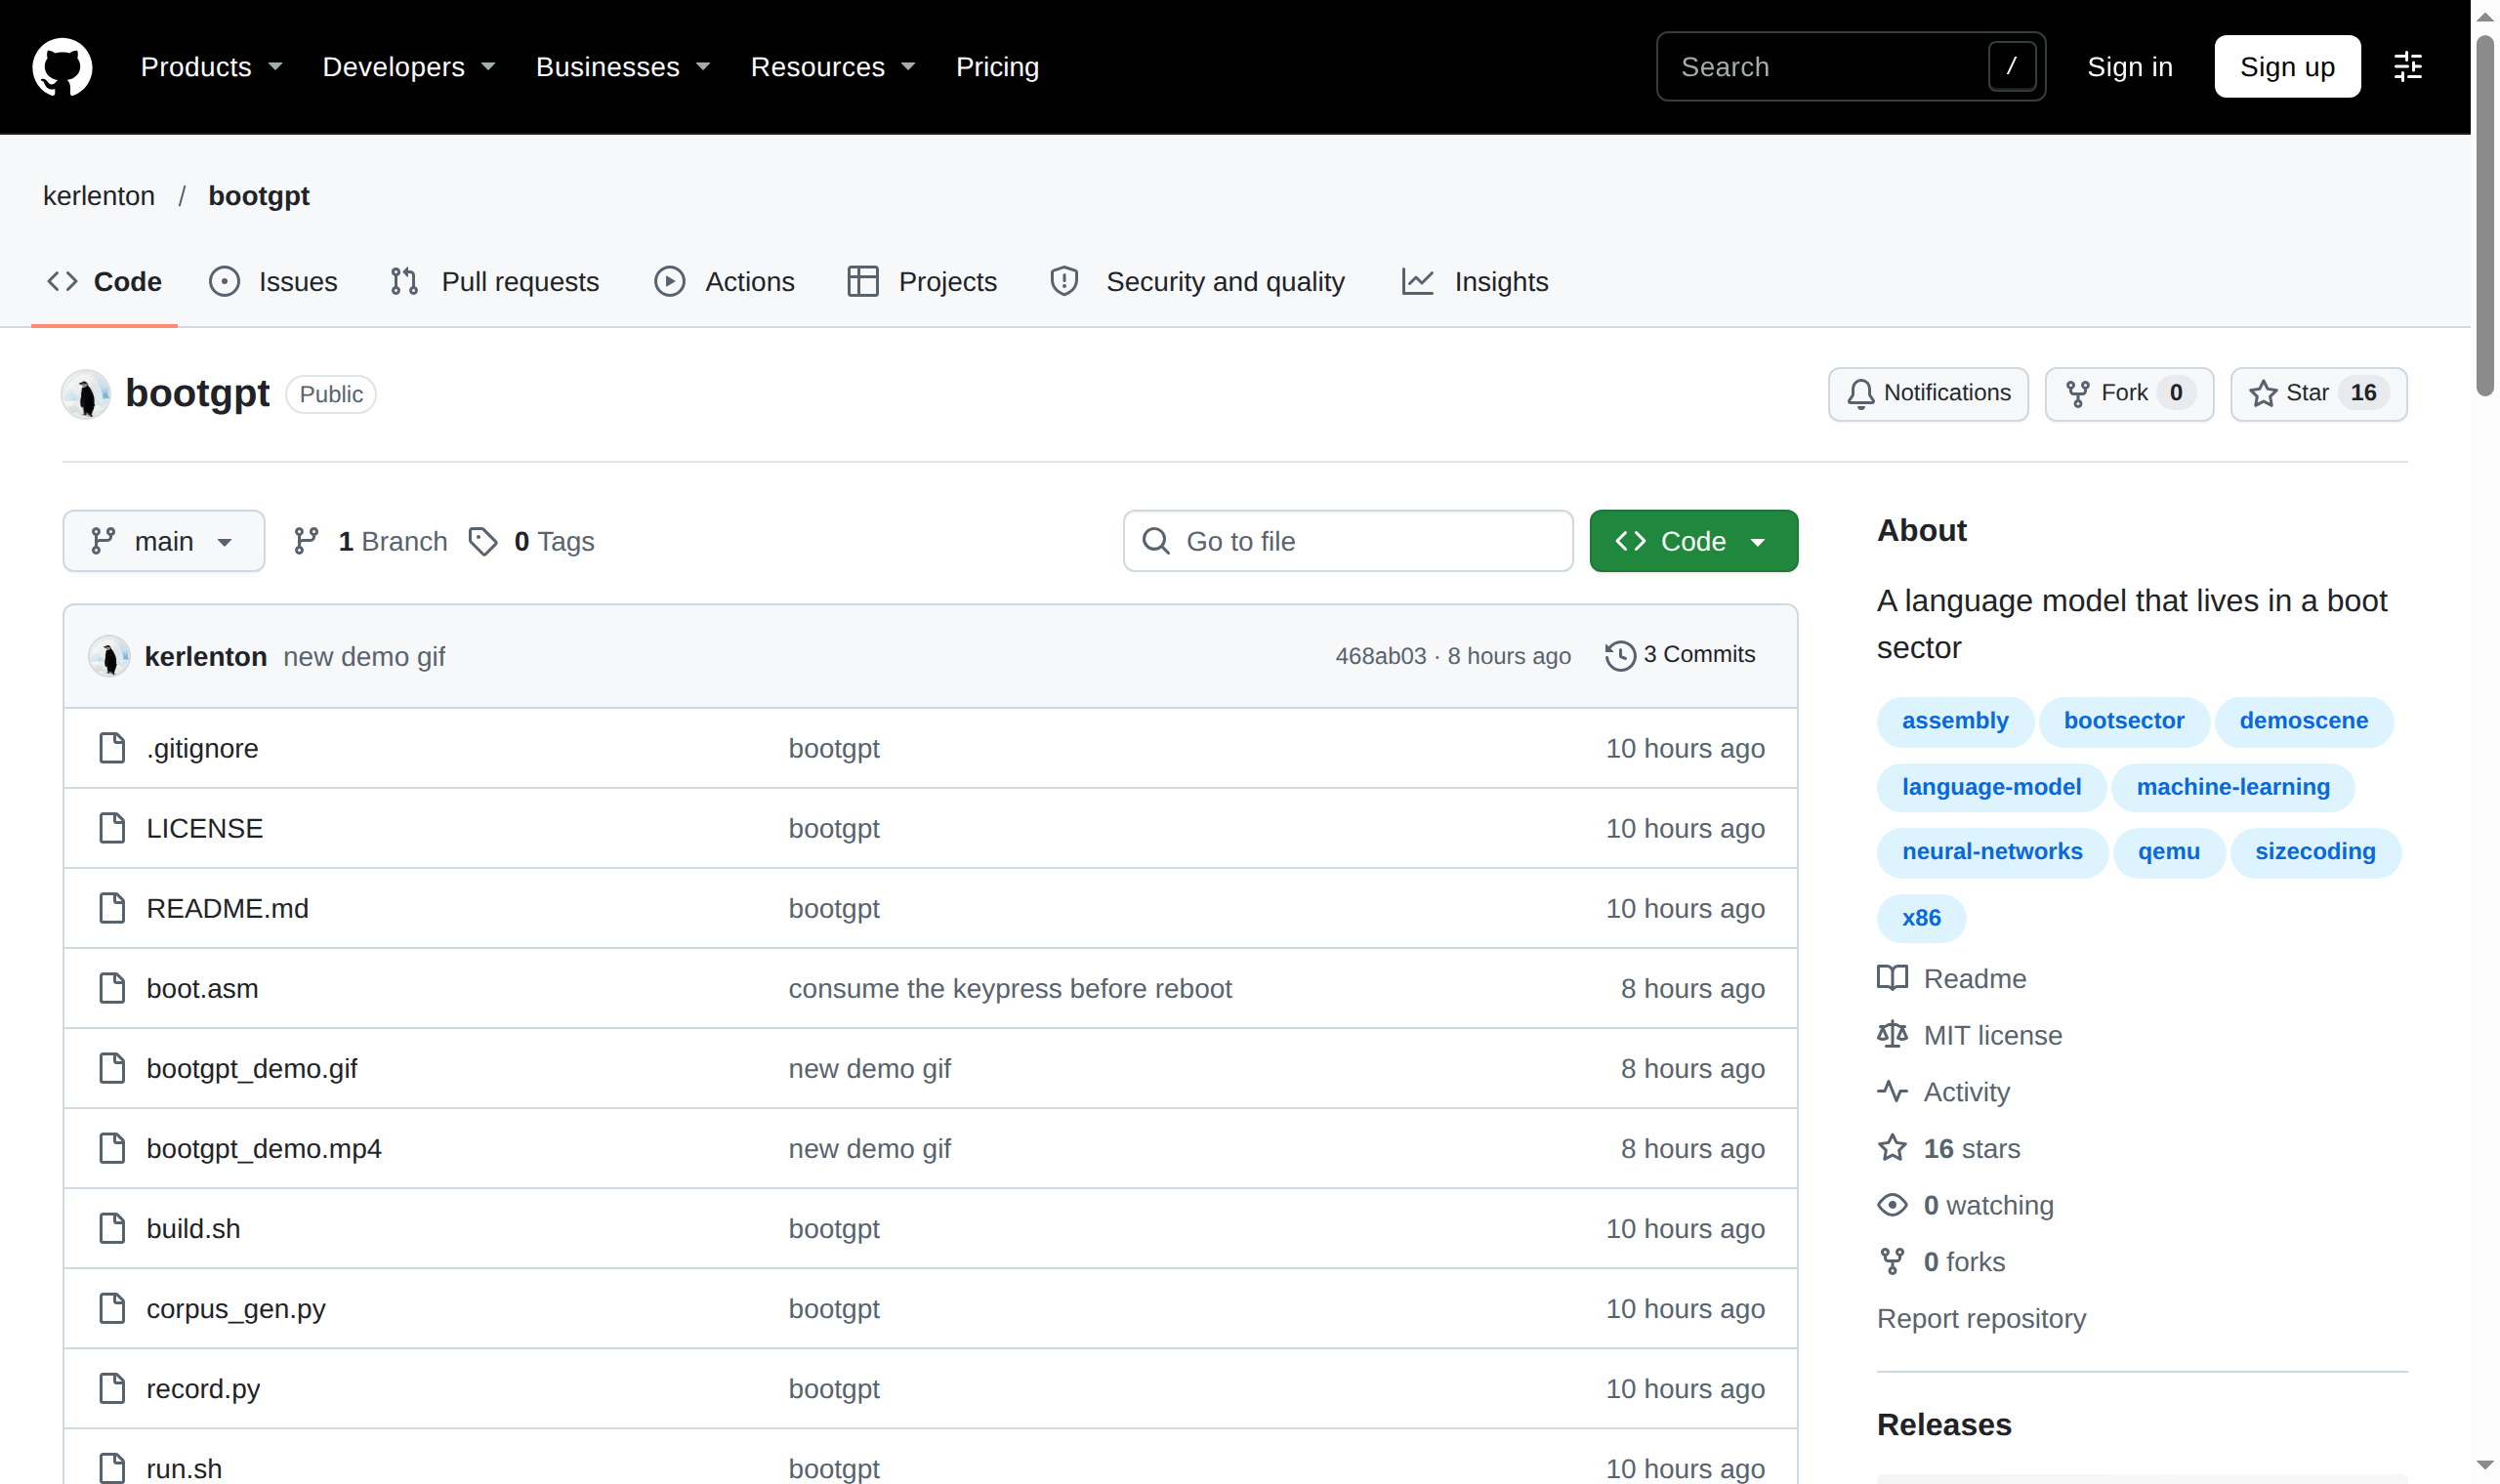 图:bootgpt 项目代码仓库。来源:GitHub
Das Trainingsskript train.py enthält einen exakten Ganzzahlemulator. Die Python-Trainingsumgebung bildet Rundungsfehler der Bitshifts und die LCG-Zufallslogik des Assemblercodes Byte für Byte nach. So wird bereits auf Quelltextebene sichergestellt, dass das Modell auf der echten Maschine ohne jegliche Diskrepanzen läuft.
Skalierung ist nicht alles: KI-Rückkehr auf den 386er
Das Ausreizen von 512 Byte im Bootsektor steht in einer langen Hacker-Tradition. Schon vor Jahrzehnten bauten Programmierer vollständige Schach-Engines in Bootsektoren ein; es folgten Mini-Betriebssysteme und Mikro-Compiler. Mit Projekten wie sectorllm gelang es später sogar, einen Self-Attention-Mechanismus in 1,2 KB Assembler unterzubringen.
bootgpt knüpft nahtlos an dieses Erbe an, die Grenzen des Machbaren zu erkunden. Statt allgemeiner Problemlösungsfähigkeit widmet es sich einer extrem spezialisierten Aufgabe an der physikalischen Grenze. Selbst wenn die Rechenleistung auf das Niveau eines 40 Jahre alten Single-Core-Mikroprozessors zurückgeschraubt wird, erfüllt das Modell auf dem Bildschirm seine Rolle perfekt.
Die Tech-Branche hat sich daran gewöhnt, jeden algorithmischen Engpass mit riesigen Budgets und gigantischem Stromverbrauch zu lösen. Massive Rechencluster haben die Obergrenze des Möglichen verschoben, lassen die Ingenieurswelt aber oft vergessen, wie elegant hardwarenahe Optimierung sein kann. Wenn ein Problem präzise definiert und der Algorithmus an harten Vorgaben geschliffen wird, genügen selbst 512 Byte, um die faszinierende Illusion von Intelligenz zu erschaffen.
参考链接:
- kerlenton/bootgpt 仓库源码
- Hacker News 讨论


