[ 2.283888] pci 0000:01:01.4: [1b36:0a35] ryndrde c4128 6422 Vveine
[ 1.953886] pci 0000:01:1f.2: reg 0x10: [mem 0x7e4515e5-0x2d766c27] usbbore: reg
[ 1.815765] ACPI: PCI Interrupt Link [LNKA: v/s.xos212
这是一台电脑按下电源键后,屏幕上跳出的内核日志。第一行打印出 PCI 总线地址,第二行分配内存寄存器范围,第三行准备初始化系统的中断响应。系统工程师扫过这些代码,会以为一台普通的服务器正在唤醒硬件。
屏幕里的硬件在现实世界里根本不存在。设备名里的 ryndrde 与 usbbore 是生造的错拼词汇,整台机器连操作系统都没有载入。驱动这串输出的程序只有 512 字节汇编代码,外加一个仅 11.5 KB 的神经网络。
开发者 kerlenton 把它命名为 bootgpt。主流模型军备竞赛正在吞噬成千上万度电力,追求数百亿参数。这个小项目反其道而行之。它退回 1985 年的芯片环境,证明算力从来不是智能的绝对门槛。
机器刚开机就吐日志,屏幕上全是虚构硬件
把编译出的 disk.img 镜像写入 U 盘,插进任何兼容传统 BIOS 的计算机,屏幕就会瞬间亮起。没有 Linux 内核引导,没有 GRUB 选单,光标开始一行行飞速喷出白字。时间戳在跳动,外设地址在滚动,冷冰冰的芯片仿佛正在做梦。
这个梦境由一个上下文长度仅 8 个字符的模型实时编织而成。8 个字符甚至塞不下半个英文单词,模型却能准确接出冒号、空格与十六进制地址。真实硬件驱动并不存在,它学会的是启动日志的形式节奏。
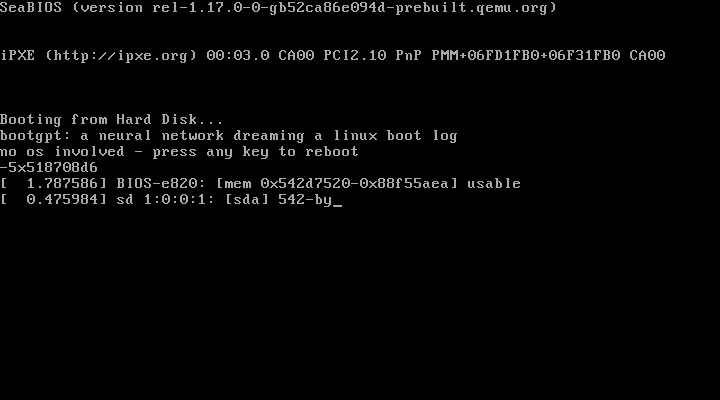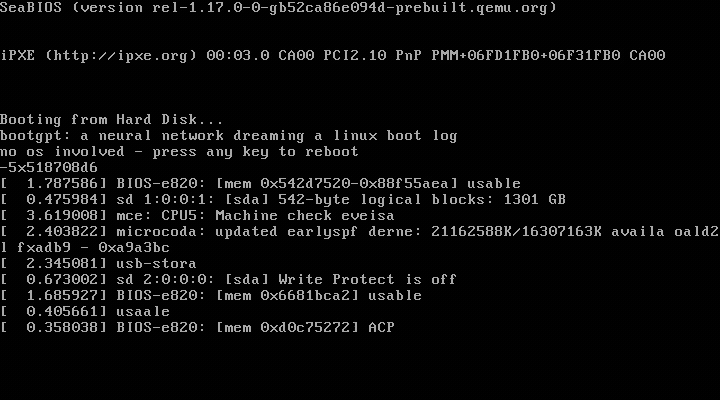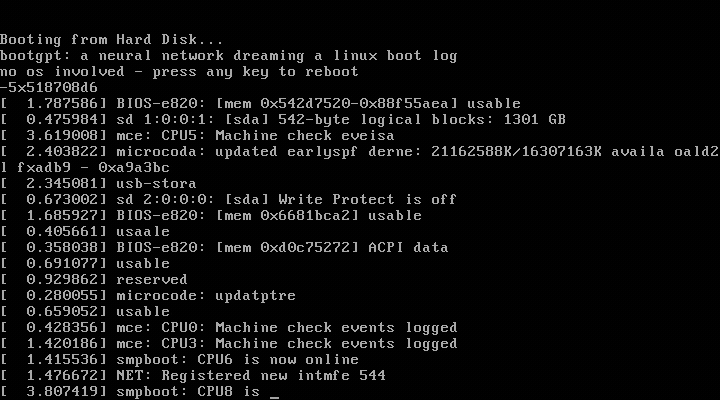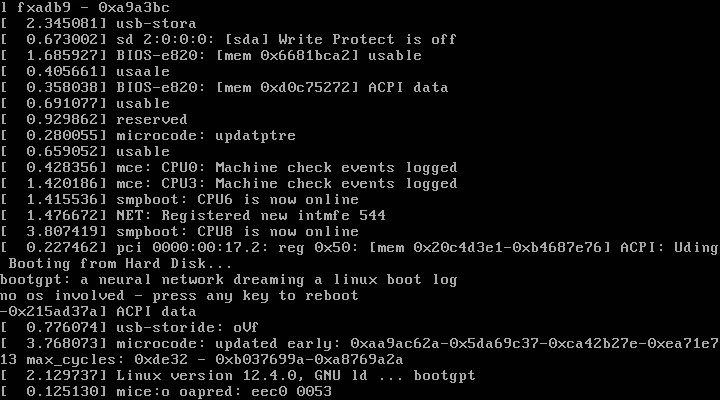 图:bootgpt 在 QEMU 里启动并逐行吐出 Linux 启动日志。来源:kerlenton/bootgpt 仓库
动图记录了 QEMU 模拟器里的真实运行状态。输出看似漫无边际,底层其实依托字符统计概率完成推演。只要前几个字符符合规律,后续输出就会滑入工程师熟悉的工业外表。
砍掉操作系统,512字节汇编接管整颗芯片
主流 AI 架构依赖繁杂的软件层。跑一次推理要调动 Python 解释器、系统内核与显卡驱动,吃掉数个 G 的显存。现代开发默认这种臃肿不可避免,认定神经网络必须依附于完整的操作系统。
bootgpt 把这些附加层剥离殆尽。主引导记录 MBR 在磁盘扇区规范里被锁死在 512 字节,最后两个字节必须固定保留给启动标识 0xAA55。开发者用纯手写 x86 汇编填满了剩下的 510 字节,在里面塞下了完整的推理运行时。
CPU 此时处于 16 位实模式,寻址空间被锁在 1 MB 以内。汇编代码利用 BIOS 的 INT 13h 磁盘中断,一口气读取硬盘后续的 23 个扇区。那 23 个扇区藏着 11.5 KB 的模型权重,随读随存,直接注入物理内存。
512 字节汇编处理了模型载入、键盘循环和终端字符显色。没有驱动冲突,没有进程调度,芯片通电后直接把电信号灌入推理循环。软件工程用层次堆出来的通用性,在这里被手写汇编全部收拢。
扔掉浮点数,矩阵乘法只做加减与移位
深度学习主流运算严重依赖浮点数。早期的 Intel 80386 处理器没有内置数学协处理器,执行浮点指令需要昂贵的扩展硬件。如果要让四十年前的架构运转网络,浮点通道必须关闭。
开发者将模型的所有权重与激活值压入 int8 整型范围。量化缩放因子被设计为 2 的幂次方,浮点数运算里的乘除缩放被简化为底层的二进制位移。原本繁杂的矩阵乘法,退化为基础的 imul 整数乘法与移位指令。
网络前向传播流程里,唯一的除法发生在 Softmax 概率归一化阶段。汇编代码只执行了一次 idiv 指令,便完成了字符概率分布的测算。采样环节使用手写的线性同余生成器(LCG),仅用简单的乘加迭代就产出了伪随机数。
模型没有庞大的 Transformer 堆叠,只有一层字符嵌入和一个隐藏层。运算量压缩到数百次时钟周期后,上个世纪的主频也足以跑出流畅的字频流。智能的数学表达回归为最简单的算术组合。
用假语料骗过人眼,小模型学会启动样貌
仅有轻量架构无法直接产出令人信服的文本。只有 8 个字符记忆容量的模型,理论上无法记忆长距离逻辑,容易陷入乱码死循环。工程团队用专门的语料生成脚本 corpus_gen.py 制造了 3 MB 的合成日志。
真实系统的启动日志充满大量模式重复。单个机器在一次开机过程中,内核版本号恒定,挂载的磁盘序列号始终一致。语料生成器锁定了特定会话的固定常量,让字符间的转移概率出现强烈的周期性。
小模型在训练时迅速抓住了这种重复语法。它不需要理解 PCI 总线的硬件定义,只需要建立冒号后面大概率出现空格、换行前伴随括号的统计直觉。这种针对特定场景的信息裁剪,换取了远超参数规模的视觉真实感。
 图:bootgpt 项目代码仓库。来源:GitHub
项目的训练脚本 train.py 包含一套严格的整数仿真器。Python 训练端直接复现汇编中的位移误差与 LCG 采样逻辑,使两个环境的输出可以逐字节比对。工具链在源码阶段就锁死了实机运行的确定性。
算力堆叠不是唯一解,退回386依然能跑AI
在 512 字节里做文章,属于经典的黑客工程传统。早在几十年前,就有人在引导扇区里写出国际象棋。微型操作系统与迷你编译器也相继诞生。后来出现的 sectorllm 项目,甚至在 1.2 KB 汇编里塞进了自注意力机制。
bootgpt 延续了这条探寻计算边缘的工程脉络。它放弃了复杂的通用推理,直接把特化任务压缩至物理极限。当算力被剥离到四十年前的单核微处理器水平,模型依然在屏幕上完成了预期的叙事。
产业界习惯了用资本和电网来解决一切模型瓶颈。算力堆砌固然推高了能力的上限,但也让工程界逐渐遗忘了资源受限时的优雅解法。把问题定义得足够清晰,用严密的约束反向雕刻算法,哪怕只有 512 字节也足以构筑出智能的幻觉。
参考链接:
- kerlenton/bootgpt 仓库源码
- Hacker News 讨论


