Am 21. November 2026 erreichte die mathematische Fachwelt ein historischer Beweis: Sage und schreibe 17 Millionen Zeilen Code erheben den Anspruch, die Riemannsche Vermutung bezwungen zu haben. Kein einziger Mathematiker auf der Welt kann dieses gewaltige Codemeer vollständig überblicken. Dennoch bestätigte die maßgebliche Fachgemeinschaft innerhalb von 24 Stunden offiziell die Gültigkeit des Beweises. Alle Welt feiert den Meilenstein, doch kaum jemand vermag im Detail zu erklären, wie der Autor diesen Beweis eigentlich geführt hat.
Vier Prüfkriterien schließen Rechenfehler aus, fordern aber kein menschliches Verständnis
Der Mathematiker Levent Alpöge unterteilte den Beweis in 175.187 Module und übergab ihn dem quelloffenen interaktiven Theorembeweiser Lean. Die Lean-Community und die Leitung von Mathlib reagierten unverzüglich. Anhand von vier Prüfkriterien, die zehn Tage zuvor festgelegt worden waren, leiteten sie eine gemeinsame Überprüfung ein. Nach 24 Stunden bestätigte eine offizielle Erklärung die Gültigkeit von Aussage und Beweisführung.
Dieser vierstufige Validierungsprozess kam von Anfang bis Ende ohne menschliches Nachvollziehen aus. Die erste Hürde betraf die formale Aussage: Der Beweis griff direkt auf die in Mathlib bereits etablierte, verifizierte Definition der Riemannschen Vermutung zurück, was begriffliche Verschiebungen von vornherein ausschloss. Die zweite Hürde bestand im unabhängigen Kompilieren durch Dutzende Forscher, um sicherzustellen, dass der Code fehlerfrei baute und identische Rohbeweisdateien erzeugte.
Die dritte Hürde isolierte die ursprüngliche Behauptung der Riemannschen Vermutung und glich sie mittels Textvergleichstools Zeichen für Zeichen ab. Die vierte und strengste Hürde schickte den exportierten Beweis an mehrere unabhängige Prüfkerne – nur ein einstimmiges Bestehen aller Engines galt als Zulassung. Die gesamte Pipeline war ausschließlich darauf ausgerichtet, lückenlose Deduktionslogik zu garantieren; ob menschliche Mathematiker dabei eine intuitive Vorstellung entwickeln konnten, spielte keinerlei Rolle.
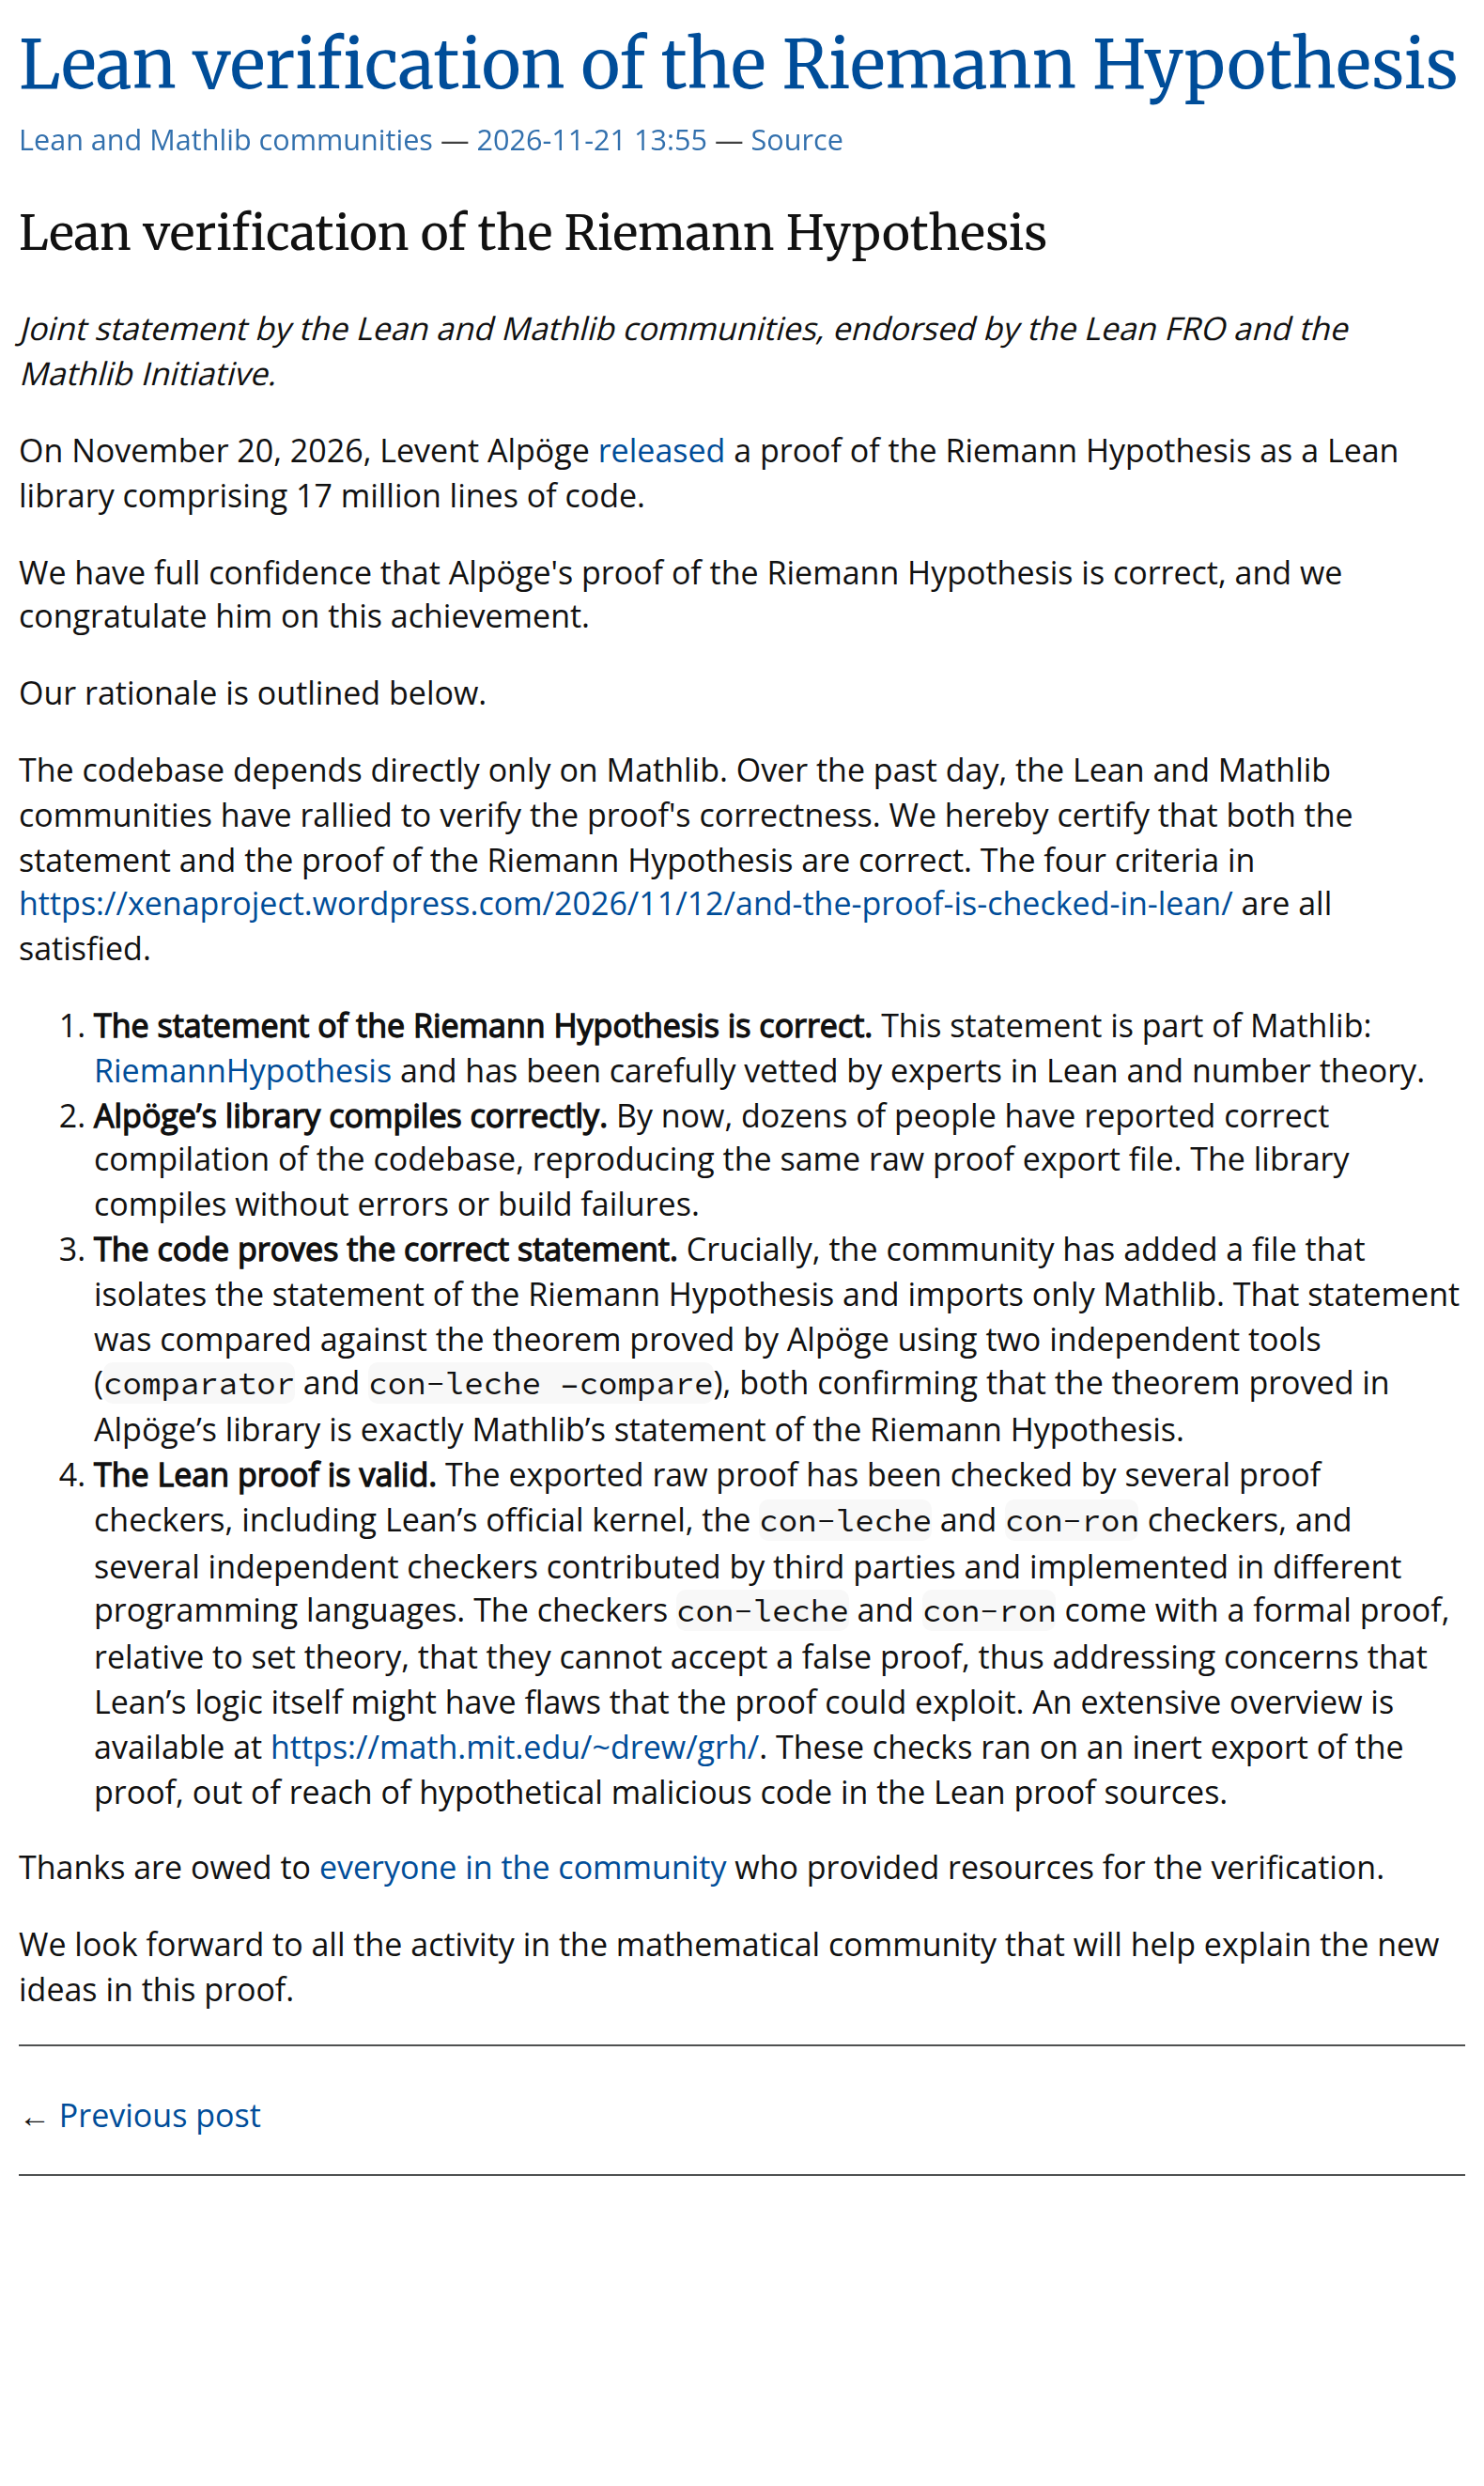 Abbildung: Gemeinsame Zertifizierungserklärung der Lean- und Mathlib-Communitys. Quelle: Lean community blog
80 Threads in 27 Minuten: Mehrere Prüfkerne riegeln Beweislücken ab
Der MIT-Mathematiker Andrew Sutherland richtete eine öffentliche Monitoring-Seite ein, um die automatisierte Prüfung transparent zu machen. Die Daten zeigten, dass alle 175.187 Module unter Lean 4.33.1 fehlerfrei kompilierten. Die fünf zentralen Hauptsätze stützten sich auf lediglich drei grundlegende logische Axiome und kamen ohne jegliche zusätzliche Hypothese aus.
Der in Rust geschriebene unabhängige Drittanbieter-Kern nanoda schloss seine Prüfung auf 80 Threads nach 27 Minuten und 42 Sekunden erfolgreich ab. Das Prüfwerkzeug con-leche scannte im Hochsicherheitsmodus in gerade einmal 3 Minuten und 15 Sekunden sämtliche 1.468.418 Deklarationen. Das Werkzeug verfügt selbst über einen formalen Korrektheitsbeweis, der ausschließt, dass falsche Theoreme fälschlicherweise anerkannt werden.
Alle 8.322 eingebundenen Basisdateien und 378 Abhängigkeiten stimmten Byte für Byte mit den offiziellen Hashwerten überein. Dass unterschiedliche Prüfwerkzeuge, verfasst in verschiedenen Programmiersprachen von unabhängigen Autoren, ausnahmslos grünes Licht gaben, bedeutet im Umkehrschluss: Um diesen Beweis zu Fall zu bringen, müssten alle Verifikationskerne simultan fehlerhaft sein. Diese tief gestaffelte Redundanz riegelte logische Schwachstellen auf Ingenieurniveau ab.
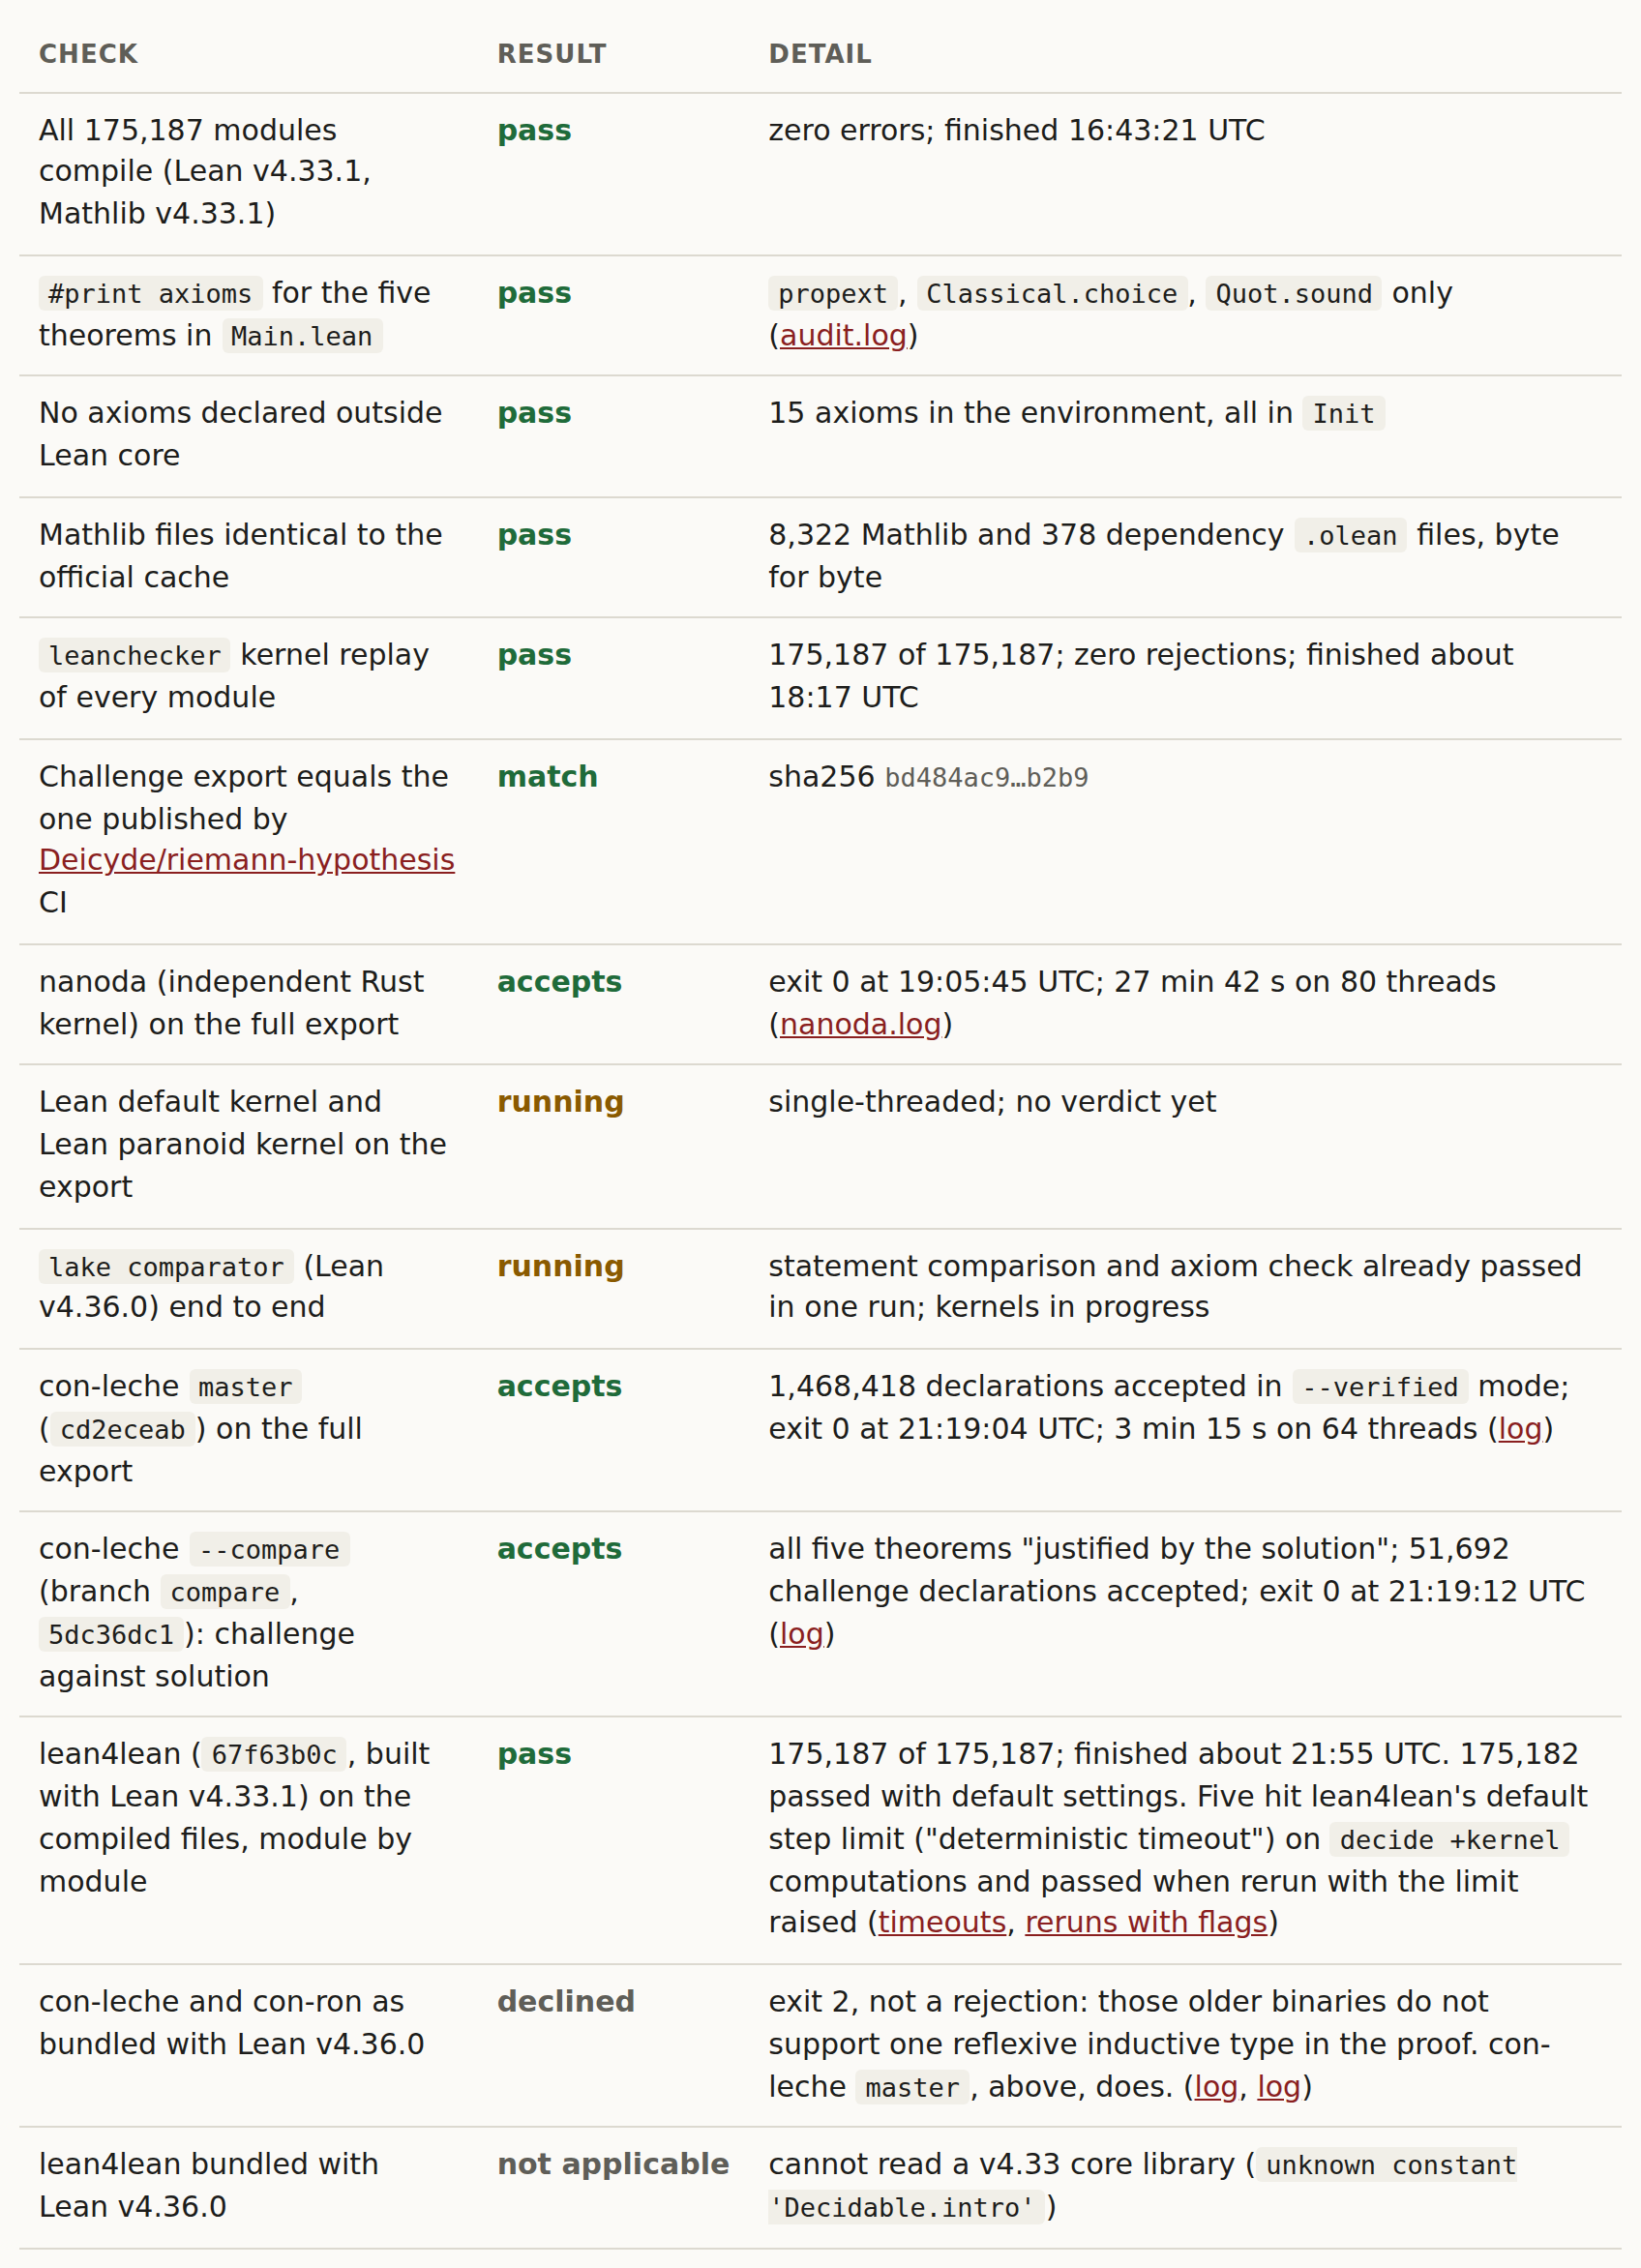 Abbildung: Vom MIT-Dashboard erfasste Prüfergebnisse der unabhängigen Kerne. Quelle: Andrew Sutherland / MIT
Ein 940-Seiten-Manuskript bricht in acht Stunden zusammen: Die Grenzen des Peer-Review
Am selben Tag veröffentlichte der Stanford-Mathematiker Ravi Vakil ein rein manuell verfasstes Manuskript des Forschers Alessandro Masullo. Die 940 Seiten starke Abhandlung mit dem Titel The Music of the Primes widmete sich der verallgemeinerten Riemannschen Vermutung. Das Manuskript beanspruchte für sich, vollständig ohne KI-Beteiligung entstanden zu sein. Es war bereits über Monate im kleinen Fachkreis geprüft worden und sollte eigentlich noch ein Jahr lang reifen – ehe Alpöges Coup eine vorzeitige Veröffentlichung erzwang.
Dieses monumentale Werk erlitt jedoch innerhalb von nur acht Stunden nach seiner Vorstellung einen verheerenden Rückschlag. Mehrere Fachkollegen untersuchten den Text mithilfe moderner KI-Tools und deckten rasch unüberbrückbare Widersprüche in der Beweisführung auf. Vakil sah sich zu einer Eilmeldung gezwungen, in der er einräumte, die Tragfähigkeit der Kernstrategie nicht mehr garantieren zu können. Aufmerksame Leser stellten zudem fest, dass der gesamte erste Abschnitt des Manuskripts schlichtweg leer geblieben war.
Der Kontrast war schonungslos. Ein 940 Seiten starkes Werk aus Menschenhand hielt der schnellen maschinellen Analyse nicht stand und zerfiel in kürzester Zeit. Dagegen errichteten 17 Millionen Zeilen Code, obwohl für Menschen unlesbar, dank unbestechlicher formaler Regeln innerhalb eines einzigen Tages eine uneinnehmbare Festung des Vertrauens.
Trotz einhelliger Kern-Bestätigung: Historische Präzedenzfälle für Falsch-Positive
Dass die Fachwelt der maschinellen Verifikation dennoch nicht blindlings vertraut, hat historische Gründe. Mathematiker erinnerten an frühere Vorfälle: Für die Collatz-Vermutung war einst ein fehlerhafter Gegenbeweis vorgelegt worden, der vermeintlich unabhängige Prüfkerne anstandslos passierte. Nachträgliche Analysen ergaben, dass die beteiligten Prüfsysteme tief im Code eine identische, ungeprüfte Grundannahme geteilt hatten.
Zieht sich die menschliche Intuition vollständig aus der Beweisführung zurück, lauern Klippen in den verborgenen Tiefen der Übersetzungslogik. Zwar griffen die vier Prüfkriterien lückenlos ineinander, doch schlossen sie den Menschen ganz bewusst aus der Schleife aus. Bis heute ist in der mathematischen Gemeinschaft niemand in der Lage, diese 17 Millionen Zeilen formaler Syntax in verständliche mathematische Gedankenmodelle zu übersetzen.
Ein erfolgreicher Compilerdurchlauf und das Begreifen mathematischer Prinzipien bleiben zwei grundverschiedene Dinge. Wissenschaftler wissen zwar nun mit an Sicherheit grenzender Wahrscheinlichkeit, dass das Theorem in der Maschine wahr ist, können daraus aber vorerst keine universellen theoretischen Werkzeuge ableiten. Die Blackbox lieferte die ultimative Antwort, überlässt den Menschen jedoch einer anhaltenden Ratlosigkeit.
Maschinen übernehmen die Verifikation, die Last des Verstehens bleibt beim Menschen
Die Kernfrage dieses wissenschaftlichen Umbruchs lautet: Wo verläuft künftig die Grenze maschinell verbürgter Erkenntnis? Vier strenge Abnahmekriterien arbeiteten auf Siliziumchips mit maximaler Effizienz und nahmen dem Menschen die mühsame Kärrnerarbeit des Prüfens ab.
Das zeitgleich veröffentlichte 940-Seiten-Manuskript führte diese Diskrepanz schonungslos vor Augen. Der Teil, den Maschinen entscheiden können, ist abgeschlossen. Das verbleibende Rätsel wartet auf jene Forscher, die bereit sind, sich durch die Codezeilen zu graben. In der Praxis finden sich freilich weit weniger Menschen, die Millionen Zeilen formalen Codes durchdringen wollen, als solche, die ein Prüfskript starten können.
Die Mathematik ist mit dem erfolgreichen Kompilieren nicht zum Stillstand gekommen. Sie mahnt uns vielmehr: Maschinen haben die Prüfung von Wahrheit und Falschheit übernommen. Das Privileg, der Mathematik eine Seele einzuhauchen, bleibt nach wie vor in den Händen des Menschen.
Weiterführende Links:
- Xena Project: Erläuterungen zu den Prüfkriterien der Riemannschen Vermutung
- MIT Department of Mathematics: Lean-Verifikations-Dashboard zur Riemannschen Vermutung
- Gemeinsame Zertifizierungsmitteilung der Lean- und Mathlib-Communitys
- Stanford University Department of Mathematics: Mitteilung zum 940-seitigen Beweismanuskript