¿Cuán corto puede llegar a ser el ciclo de vida de una nueva categoría de modelos de IA? A mediados de septiembre, Typesafe AI presentó Jev, demostrando cómo un modelo compacto puede puntuar las probabilidades de las distintas ramas de acción de un agente. Apenas dos semanas más tarde, Cloudflare subió a Hugging Face dos modelos con una arquitectura idéntica desarrollados internamente: Clef, bajo licencia Apache 2.0.
Esto no es una simple réplica: es patear el tablero. Jev es de código cerrado, arquitectura propietaria y solo accesible mediante API; Clef publica sus pesos íntegramente y asegura haber alcanzado el primer puesto en el propio Jev Decision Index de su rival. Sin embargo, en esta carrera de replicación exprés, la pregunta más reveladora no está en las tablas comparativas, sino en los comentarios de Hacker News: ¿qué hay realmente de nuevo en esto?
Qué son los modelos de decisión: de generar respuestas a puntuar opciones
Para entender la categoría impulsada por Jev, conviene analizar cómo abordan los LLM tradicionales tareas como «¿debe escalarse este ticket de soporte?». Estos modelos recurren a la generación autorregresiva: producen texto token a token para redactar una respuesta, un proceso lento, impredecible y difícil de controlar. El planteamiento de los modelos de decisión (Decision Models) consiste en suprimir la generación: al ingresar un estado y un esquema tipado de preguntas (schema), el modelo emite directamente probabilidades para cada opción predefinida sin redactar una sola palabra intermedia.
El blog de Cloudflare ilustra esto con el enrutamiento de incidencias: al enviar un mensaje de un cliente, el modelo devuelve puntuaciones estructuradas en paralelo como «Urgente: Sí 87%» y «Equipo asignado: Técnico 91%». La lógica de la aplicación downstream utiliza directamente estas probabilidades para enrutar, escalar o derivar a un operador humano. Al carecer de generación de texto, encaja de forma natural en el flujo crítico de decisión de los agentes autónomos.
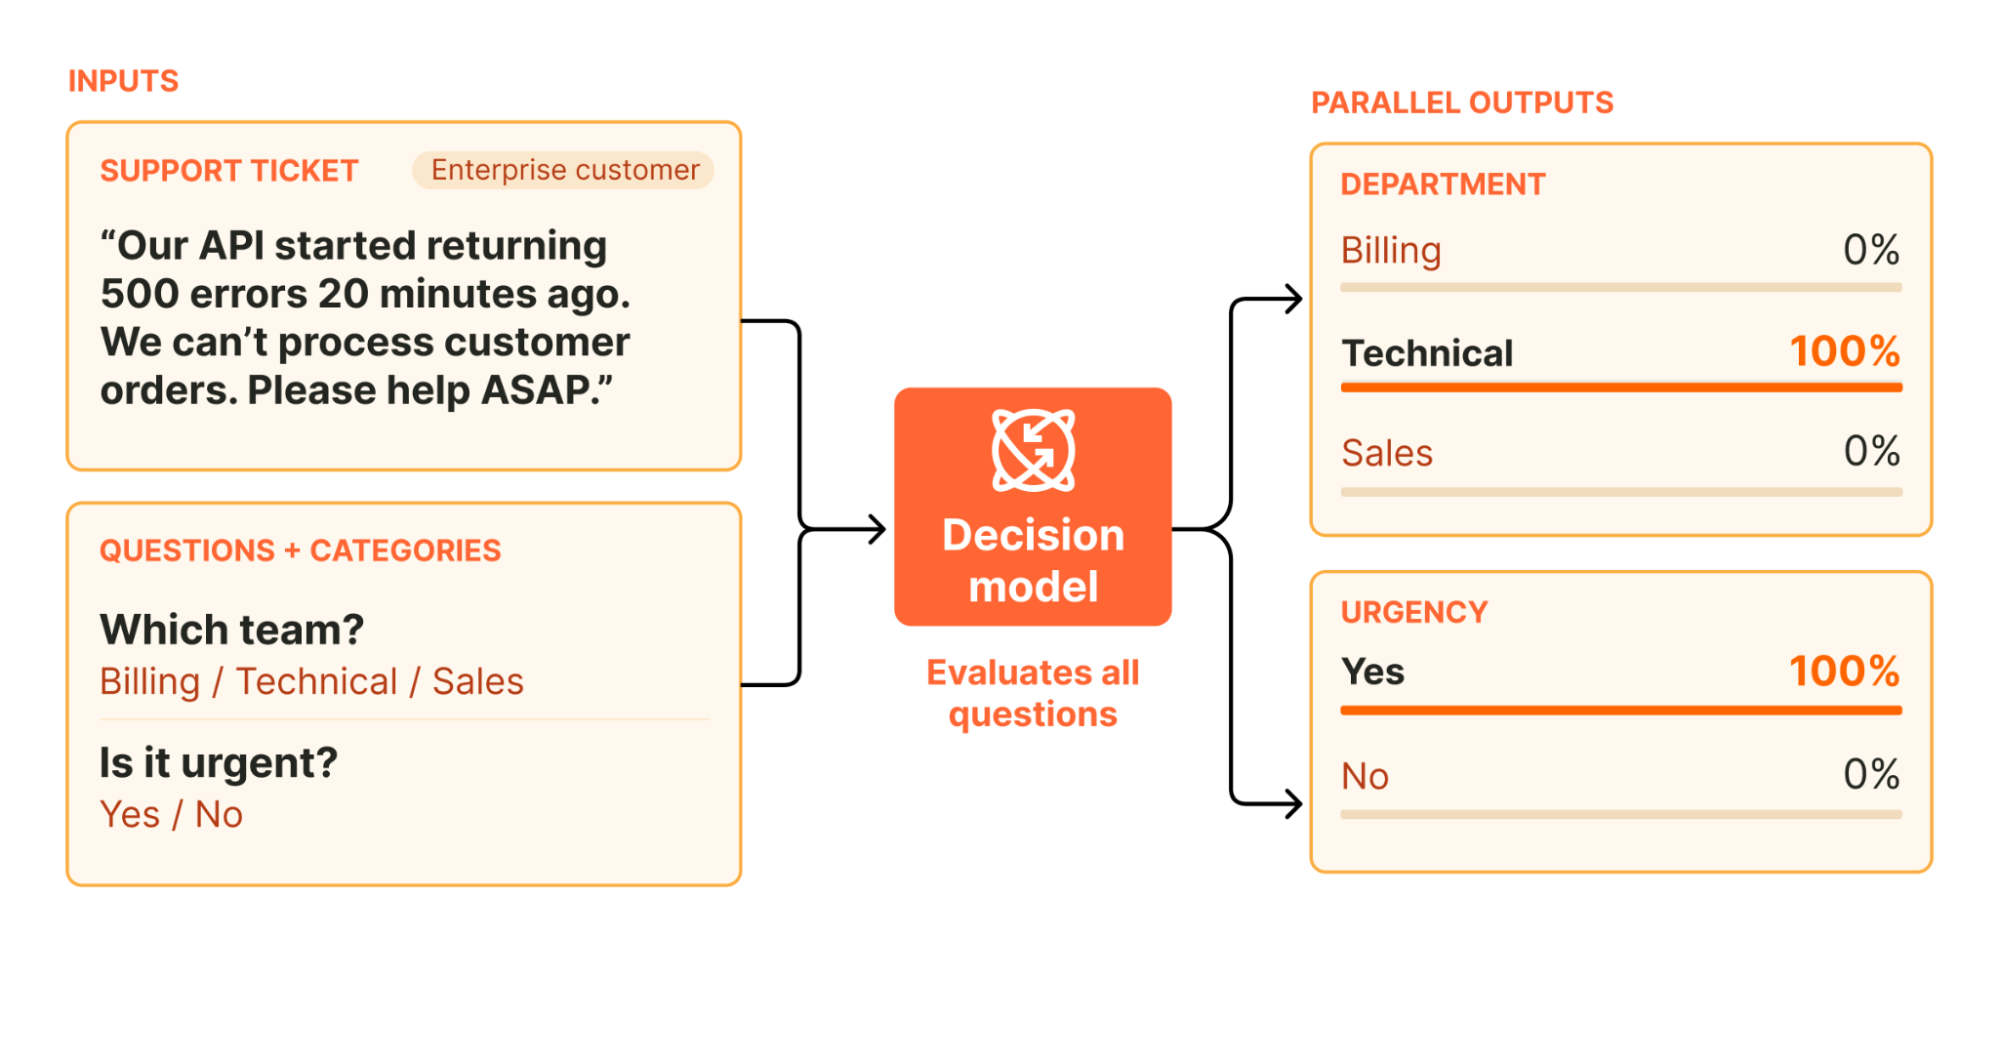 Figura: Flujo de trabajo del modelo de decisión: a partir del texto y el esquema, se calculan probabilidades en paralelo para todas las consultas. Fuente: Cloudflare Blog
La transformación real se sitúa en la capa de producto. En el pasado, esta función se denominaba simplemente «clasificador». En la era BERT, entrenar un clasificador para un dominio acotado tomaba una hora en un portátil y consumía menos de 1 GB de VRAM en inferencia, superando en velocidad a cualquier API remota. El acierto de Jev consistió en empaquetar esto como un producto universal: en lugar de reentrenar para cada nueva categoría, basta con cambiar el esquema JSON y consumir una API limpia. Jev validó el encaje producto-mercado (PMF) y abrió las puertas a toda la industria.
La arquitectura técnica de Clef: base Qwen y puntuación prefill-only
La familia Clef consta de dos variantes: Clef (27B) y Clef-flash (9B), fundamentadas respectivamente en Qwen3.8-27B y Qwen3.5-9B. El entrenamiento congela la red troncal (backbone) y únicamente ajusta un adaptador de bajo rango (LoRA) de rango 256 junto con un cabezal de enrutamiento dedicado.
Durante la inferencia, la base Qwen ejecuta una única pasada de precarga (prefill-only pass) y luego realiza una puntuación en paralelo sobre todas las opciones válidas del esquema. Dado que la fase de decisión es no autorregresiva y no genera tokens de manera secuencial, obtiene una ventaja estructural de latencia frente a los LLM estándar. Cloudflare define esto como «enrutamiento de atención en dos fases»: las opciones extraen contexto relevante del prompt, los campos cruzan atención antes de volver a referenciar la entrada original y finalmente puntúan bajo las restricciones del esquema. El entrenamiento combina entropía cruzada suavizada (label smoothing) con pérdida de Brier para calibrar probabilidades, apoyándose en una variante de RL denominada RLCD (Reinforcement Learning from Categorical Distributions) que premia con crédito parcial a opciones ordinales adyacentes.
Cloudflare reportó las siguientes métricas comparativas:
| Métrica | Clef | Clef-flash | Jev |
|---|---|---|---|
| Índice de decisión (Decision Index) | 61,2 | 57,1 | 57,9 |
| Latencia mediana | 209 ms | 38,8 ms | 524 ms |
| Ventana de contexto | 64k | 64k | 32k (estado + pregunta única) |
| Entrada visual | Soportada (imagen y vídeo) | Soportada | No soportada |
| Pesos del modelo | Apache 2.0 Código Abierto | Apache 2.0 Código Abierto | Cerrado (propietario) |
| Precio en Workers AI | $0,24 / 1M tokens | $0,09 / 1M | $0,042 / 1M |
Dos cifras merecen una mención especial. Clef-flash logra un índice de decisión de 57,1 con una latencia de 38,8 ms, un rendimiento prácticamente equiparable al de Jev (57,9 puntos y 524 ms) a una decimotercera parte de su tiempo de respuesta. Por su parte, el Clef estándar lidera la tabla oficial, superando a Jev en unos tres puntos y reduciendo la latencia a la mitad. En pruebas internas combinadas con Browser Run para categorización de dominios, Cloudflare rastreó, renderizó y clasificó un sitio web en 2,2 segundos; su LLM general gpt-oss-120b requirió 4,7 segundos y solo pudo emitir dos etiquetas de clasificación.
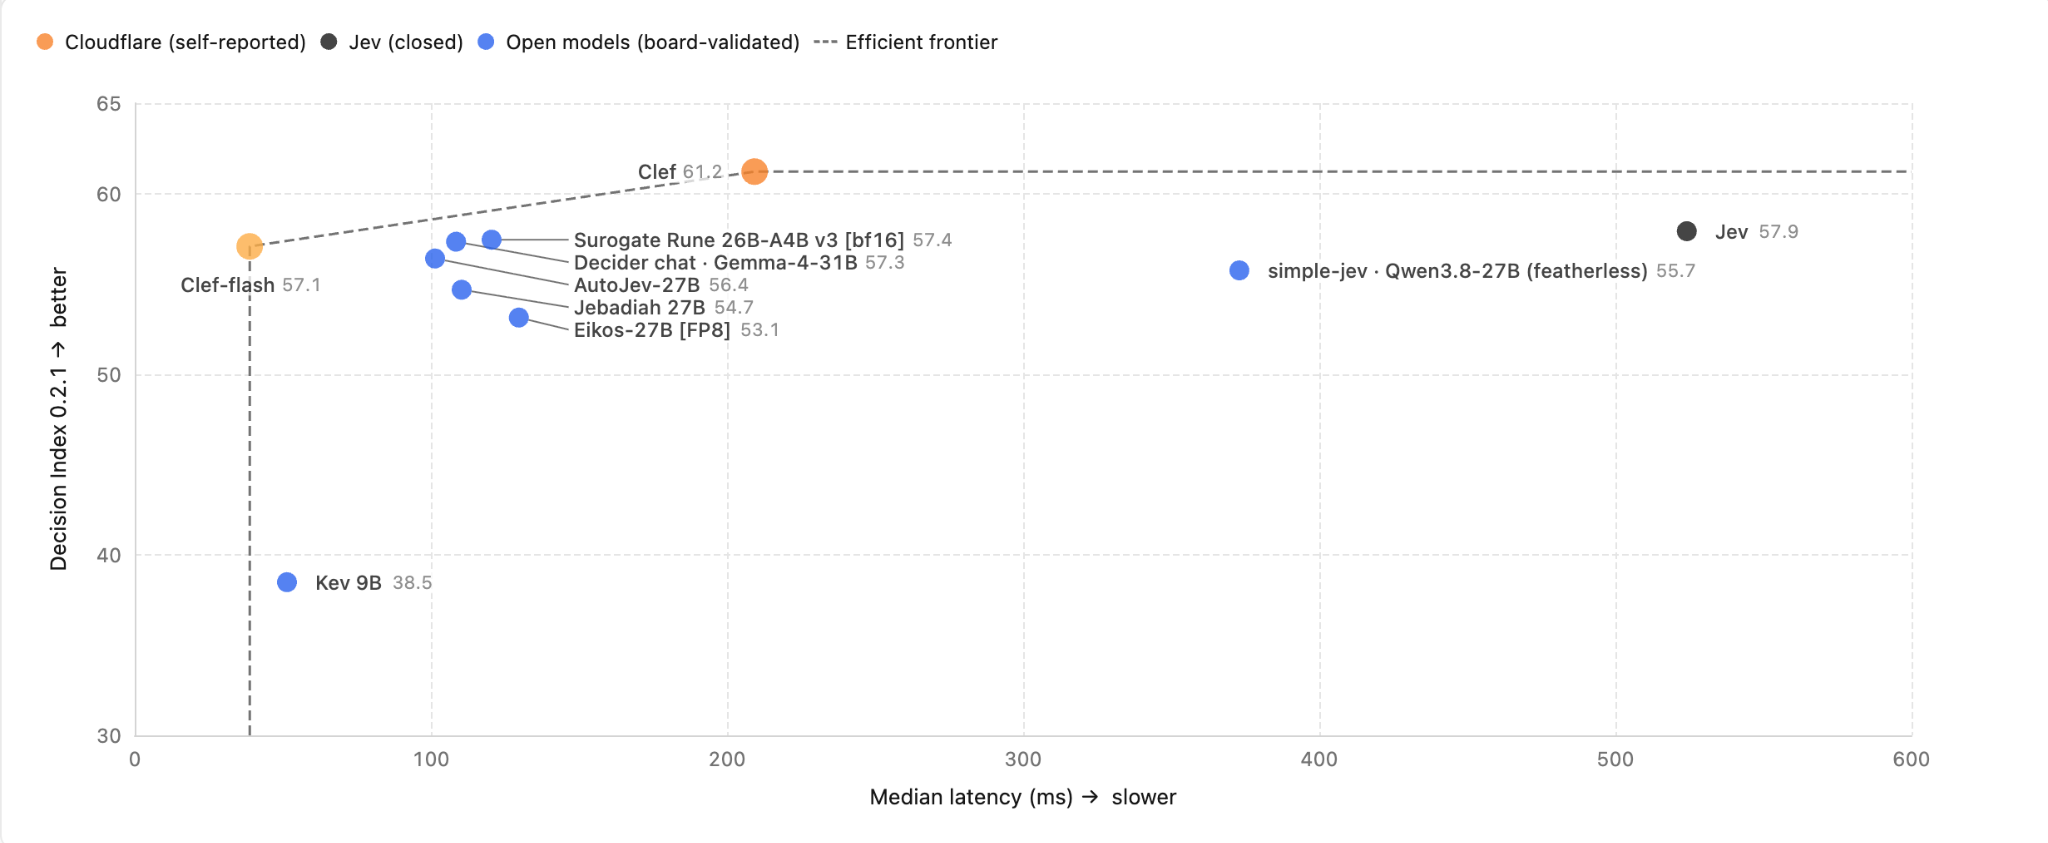 Figura: Comparativa entre Jev Decision Index y latencia, situando a la familia Clef en la frontera de Pareto. Fuente: Cloudflare Blog (datos declarados)
Letra pequeña en los resultados
Es necesario aplicar una dosis de realismo. Todos los datos del gráfico anterior están etiquetados como «Cloudflare (declarados por el autor)». Según confirmó The Register, estas marcas todavía no han completado el proceso de replicación y validación en la tabla oficial de Hugging Face. La distinción gráfica que hace el propio blog entre «Jev (cerrado)» y «Modelos abiertos (validados)» pone de relieve la diferencia entre anuncios propios y comprobaciones independientes.
El precio es otro factor determinante. A $0,24 por millón de tokens, Clef resulta casi seis veces más caro que Jev ($0,042/M), y Clef-flash ($0,09/M) más del doble. Como indicaron varios usuarios en Hacker News, el gráfico de Pareto ignora deliberadamente el coste. Si se añade la variable económica al análisis, la frontera cambia radicalmente: la ventaja en prestaciones existe, pero se paga cara.
Las barreras para el despliegue local tampoco son desdeñables. Michelle Chen, jefa de producto en Cloudflare, confirmó a The Register que Clef necesita 85 GB de VRAM y Clef-flash 41 GB (asumiendo concurrencia única y contexto de 64k). Aunque disponer de pesos abiertos habilita el autoalojamiento, las tarjetas gráficas de consumo quedan completamente descartadas. En HN se recordó que para tareas verticales bien delimitadas, entrenar un modelo tipo BERT en un portátil en una hora sigue ofreciendo una latencia inferior a cualquier API de nube. El valor real de los modelos de decisión generales reside en aquellos casos donde no se dispone de datos de entrenamiento previos.
Asimismo, los conjuntos de datos de entrenamiento no se han publicado. A pesar de la licencia Apache 2.0 para los pesos, The Register confirmó que los datos de entrenamiento se mantienen privados. La autenticidad de la etiqueta «open source» depende de si la prioridad son los pesos o los datos de base.
El debate en HN: ¿avance técnico o simple lavado de cara de un clasificador?
El debate en el hilo de Hacker News (478 puntos) giró en torno a la pregunta más votada: «¿Cómo es posible que tanta gente construya modelos de decisión en cuestión de días o semanas? ¿No era este un concepto ya conocido?»
Las respuestas más respaldadas explicaron la base técnica: las arquitecturas transformer emiten por naturaleza distribuciones de probabilidad sobre el vocabulario. Aprovechar salidas estructuradas (structured outputs) y logprobs para clasificar es una práctica habitual en la comunidad desde hace años: solicitar un token al modelo y ordenar los logprobs funciona con solvencia incluso en modelos pequeños. Varios desarrolladores añadieron: la verdadera aportación de Jev estuvo en el diseño de interfaz y la API, permitiendo que una técnica previa fuera comprensible y accesible para cualquier programador; y las API son extraordinariamente sencillas de replicar. Que en solo dos semanas surgieran competidores abiertos en Hugging Face (AutoJev, Jebadiah, Kev y Clef) demuestra lo asequible de la barrera de entrada.
No obstante, existen argumentos en sentido contrario: la calibración constituye el verdadero desafío. Diseñar un clasificador veloz está al alcance de muchos; conseguir que las probabilidades emitidas correspondan fidedignamente a la confianza real es sumamente complejo, y se reconoce que Jev destaca en esta faceta. Desde la ingeniería de datos, la conclusión fue elocuente: la arquitectura es «la parte entretenida y sencilla», mientras que la auténtica dificultad radica en los datos y la rigurosidad de la evaluación. Sin datos etiquetados de alta calidad, ni siquiera es posible evaluar con precisión si un clasificador acierta.
Ambas posturas abordan caras de la misma moneda: la técnica no es inaccesible, pero las probabilidades calibradas exigen una ingente ingeniería de datos. La capacidad de Cloudflare para responder en dos semanas proviene de sus quince años acumulando tráfico de red y canalizaciones de etiquetado, la ventaja que la distingue de los clones improvisados de fin de semana.
La jugada estratégica: la plataforma de RL integrada
En la segunda mitad del artículo se desvela un movimiento estratégicamente más relevante que el propio Clef: Cloudflare lanzó en paralelo un servicio de ajuste fino por refuerzo (RL), con el que las empresas pueden adaptar Clef a sus propios dominios utilizando datos de su tráfico real.
El circuito de entrenamiento aprovecha componentes preexistentes: AI Gateway captura el tráfico de producción para construir conjuntos de datos, Workers AI genera rollouts, Containers aloja entornos aislados para las funciones de recompensa, un nuevo componente denominado Trainer actualiza los pesos y, mediante BYO Model, se redespliega el modelo directamente en los nodos de la red perimetral. Cloudflare aplica este mecanismo en sus operaciones internas: moderación en Trust & Safety, clasificación de tickets de soporte y detección de bots, tareas con volúmenes masivos de datos históricos etiquetados.
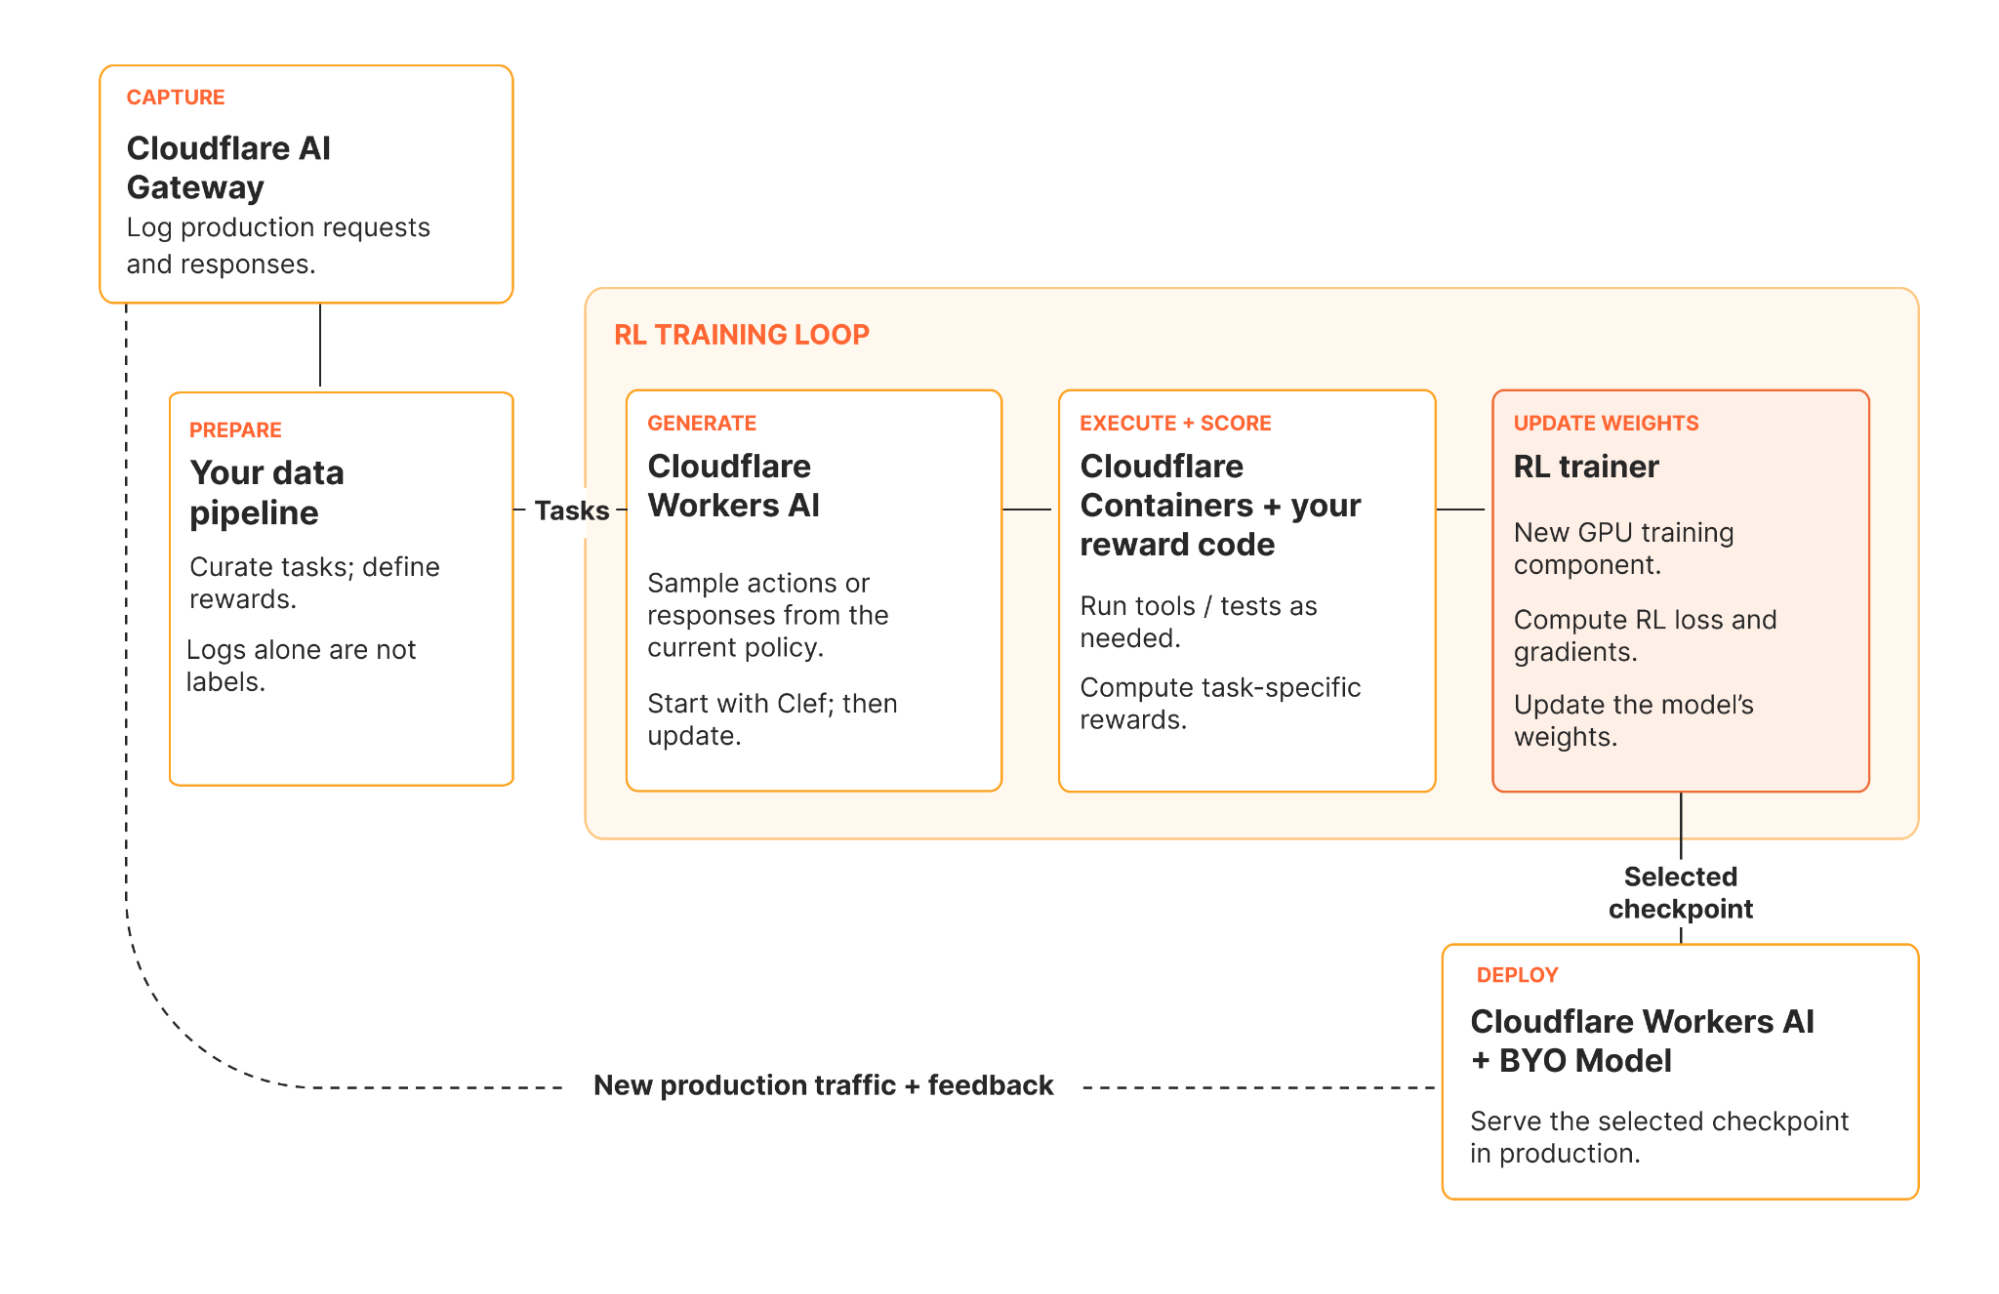 Figura: Arquitectura del pipeline de fine-tuning por RL: captura de datos mediante AI Gateway, ciclo de entrenamiento y despliegue final en la red perimetral. Fuente: Cloudflare Blog
El objetivo comercial es evidente: la venta de tokens de inferencia reporta márgenes estrechos. El negocio sustancial consiste en consolidar la cadena integral («modelo base → entorno de RL → despliegue perimetral») dentro de la infraestructura de Cloudflare. Aunque los datos recopilados por AI Gateway pertenecen al cliente, el ciclo de entrenamiento y ejecución queda anclado en su plataforma. Esta maniobra encaja con la visión de la «agent cloud»: los modelos de decisión son el componente más invocado en la ruta crítica de los agentes autónomos, y quien domine ese cuello de botella controlará el flujo principal del tráfico de IA.
Conclusión
Replicar a Jev en dos semanas evidencia que la barrera técnica de los modelos de decisión es reducida: basta con apoyarse en una base Qwen existente, eludir la generación autorregresiva de texto y evaluar opciones en paralelo. Cualquier organización con infraestructura sólida puede conseguirlo.
La verdadera diferenciación se manifestará en los aspectos de fondo: la estabilidad de la calibración de probabilidades en escenarios límite, la calidad de las canalizaciones de datos para alimentar el ajuste por RL y la capacidad de la red perimetral para cumplir la promesa de los 38 ms a escala global.
Para los equipos de ingeniería, el paso inmediato es directo: la API de Clef es totalmente compatible con la de Jev y sus pesos están abiertos. Probar ambos modelos con datos reales propios toma apenas diez minutos para determinar cuál encaja mejor en cada flujo de producción.
Enlaces de referencia:
- Cloudflare Blog: Introducing Clef — our open-source decision models, and new RL fine-tuning platform
- The Register: Cloudflare tries to outplay Jev with open-weight Clef models
- Discusión en Hacker News: Clef — Open-weight decision models, and new RL fine-tuning platform
- Hugging Face: Ficha del modelo Cloudflare/clef
- Documentación de Cloudflare: Workers AI Clef Documentation