Quelle peut être la durée de vie d’une nouvelle catégorie de modèles d’IA ? À la mi-septembre, Typesafe AI lançait Jev, démontrant la capacité d’un modèle compact à attribuer des scores de probabilité à chaque embranchement d’action d’un agent autonome. Deux semaines plus tard à peine, Cloudflare mettait en ligne sur Hugging Face deux modèles internes partageant la même architecture sous licence Apache 2.0, baptisés Clef.
Il ne s’agit pas d’une banale démonstration de suivi : c’est un véritable coup d’éclat. Alors que Jev demeure fermé, discret sur son architecture et uniquement accessible par API, Clef en publie l’intégralité des poids et revendique la première place sur le Jev Decision Index, le benchmark même de son rival. Pourtant, au cœur de cette course à la reproduction en quinze jours, la question la plus instructive ne figure pas dans les tableaux de scores, mais dans les commentaires de Hacker News : quelle est la véritable nouveauté ici ?
Qu’est-ce qu’un modèle de décision : de la génération de texte à la notation d’options
Pour bien appréhender cette catégorie popularisée par Jev, il convient d’observer comment les LLM classiques traitent une question telle que « faut-il escalader ce ticket client ? ». Ils s’appuient sur une génération autorégressive : les tokens sont produits les uns après les autres pour « rédiger » une réponse, une méthode lente, coûteuse et difficile à maîtriser de manière déterministe. Les modèles de décision (Decision Models) éliminent purement et simplement cette étape de rédaction. On leur transmet un état (state) et un schéma typé de questions (schema), et le modèle retourne directement une probabilité pour chaque option prédéfinie, sans générer un seul mot de texte intermédiaire.
Le blog de Cloudflare illustre ce principe par le routage de tickets d’assistance : lorsqu’un message client arrive, le modèle renvoie en parallèle des scores structurés, tels que « Urgent : Oui 87 % » et « Équipe assignée : Technique 91 % ». Le code applicatif en aval utilise directement ces probabilités calibrées pour orienter, escalader ou transmettre la demande à un opérateur humain. En l’absence totale de génération textuelle, cette approche s’insère idéalement sur le chemin critique des boucles de décision des agents autonomes.
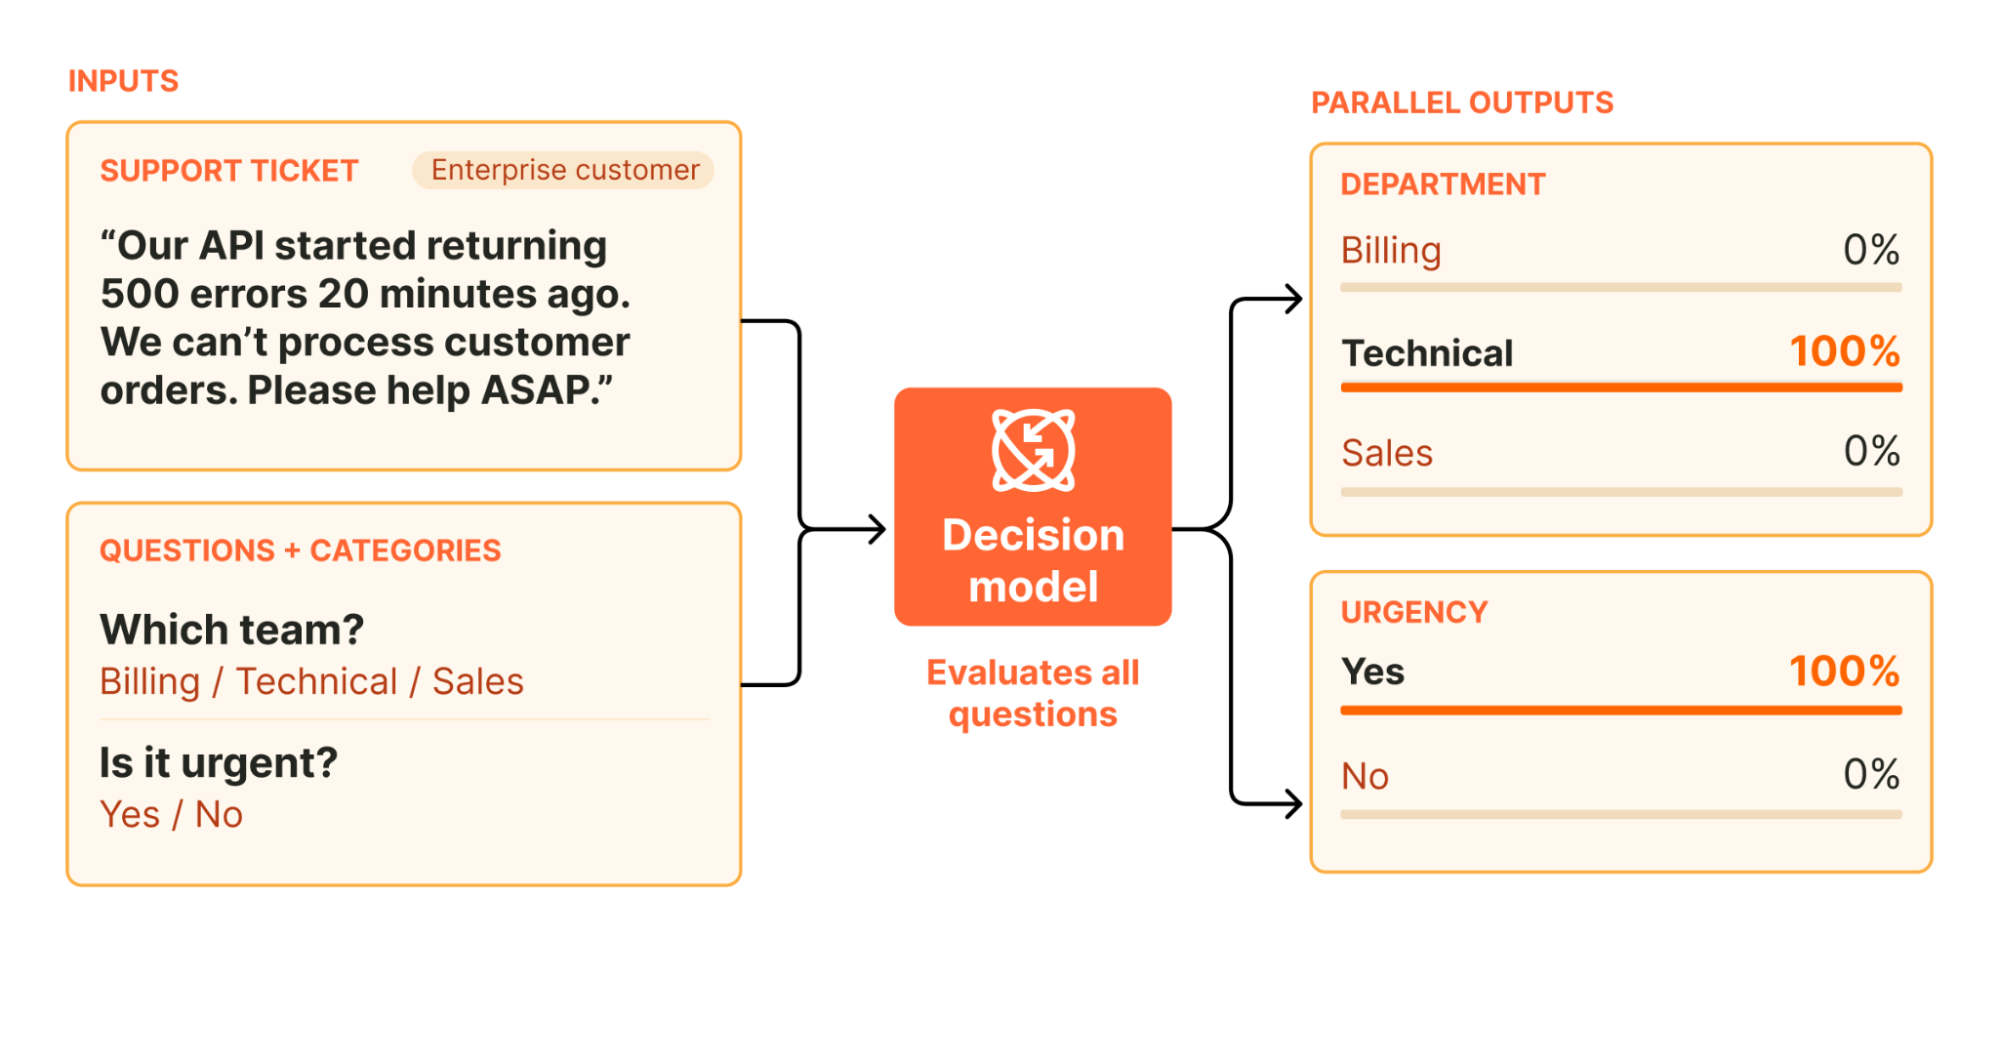 Figure : Fonctionnement du modèle de décision — le texte du ticket et le schéma en entrée produisent des distributions de probabilité parallèles pour toutes les requêtes. Source : Cloudflare Blog
Le changement marquant s’opère au niveau produit. Par le passé, cette compétence portait simplement le nom de « classificateur ». À l’époque de BERT, entraîner un classificateur sur un domaine restreint prenait une heure sur un ordinateur portable et occupait moins de 1 Go de VRAM en inférence, devançant n’importe quel appel API. La contribution décisive de Jev a été d’en faire un produit générique : au lieu de réentraîner pour chaque nouvelle taxonomie, il suffit de changer le schéma JSON, le tout orchestré par une API pensée pour les développeurs. Jev a validé le Product-Market Fit (PMF) ; désormais, tout le monde s’y engouffre.
La recette technique de Clef : base Qwen et scoring prefill-only
La famille Clef se décline en deux modèles : Clef (27B) et Clef-flash (9B), reposant respectivement sur Qwen3.8-27B et Qwen3.5-9B. L’entraînement fige l’ensemble du réseau dorsal (backbone) pour n’ajuster qu’un adaptateur de bas rang (LoRA) de rang 256 couplé à une tête de routage spécifique.
Lors de l’inférence, la base Qwen exécute une seule passe de pré-remplissage (prefill-only), suivie d’un calcul de scores en parallèle sur toutes les options admissibles du schéma. Comme cette phase de décision est non autorégressive et se passe de décodage séquentiel de tokens, elle bénéficie d’un avantage de latence structurel face aux LLM polyvalents. Cloudflare qualifie cette mécanique de « routage d’attention en deux phases » : chaque option candidate extrait le contexte pertinent du prompt, les champs croisent leur attention avant de revenir à l’entrée d’origine, et la notation sous contrainte de schéma conclut la passe. L’objectif d’entraînement associe une entropie croisée avec lissage d’étiquettes (label smoothing) et une perte de Brier pour le calibrage des probabilités, renforcées par une variante de RL appelée RLCD (Reinforcement Learning from Categorical Distributions) qui attribue un crédit partiel aux choix ordinaux contigus.
Cloudflare a publié les repères comparatifs suivants :
| Métrique | Clef | Clef-flash | Jev |
|---|---|---|---|
| Indice de décision (Decision Index) | 61,2 | 57,1 | 57,9 |
| Latence médiane | 209 ms | 38,8 ms | 524 ms |
| Fenêtre de contexte | 64k | 64k | 32k (état + question unique) |
| Entrée visuelle | Prise en charge (images + vidéo) | Prise en charge | Non prise en charge |
| Poids du modèle | Apache 2.0 Open Source | Apache 2.0 Open Source | Fermé (propriétaire) |
| Tarification Workers AI | 0,24 $ / 1M de tokens | 0,09 $ / 1M | 0,042 $ / 1M |
Deux chiffres méritent d’être soulignés. Clef-flash atteint un indice de décision de 57,1 avec une latence de 38,8 ms, rivalisant avec le modèle fermé Jev (score de 57,9 à 524 ms) pour une latence environ treize fois inférieure. De son côté, le modèle étendard Clef s’adjuge la première place sur le benchmark officiel, dépassant Jev de plus de trois points tout en divisant la latence par deux. Lors de tests internes couplés à Browser Run pour classifier des noms de domaine, Cloudflare a mesuré 2,2 secondes pour explorer, effectuer le rendu et catégoriser un site web, contre 4,7 secondes pour son modèle général gpt-oss-120b, limité en outre à deux classes en sortie.
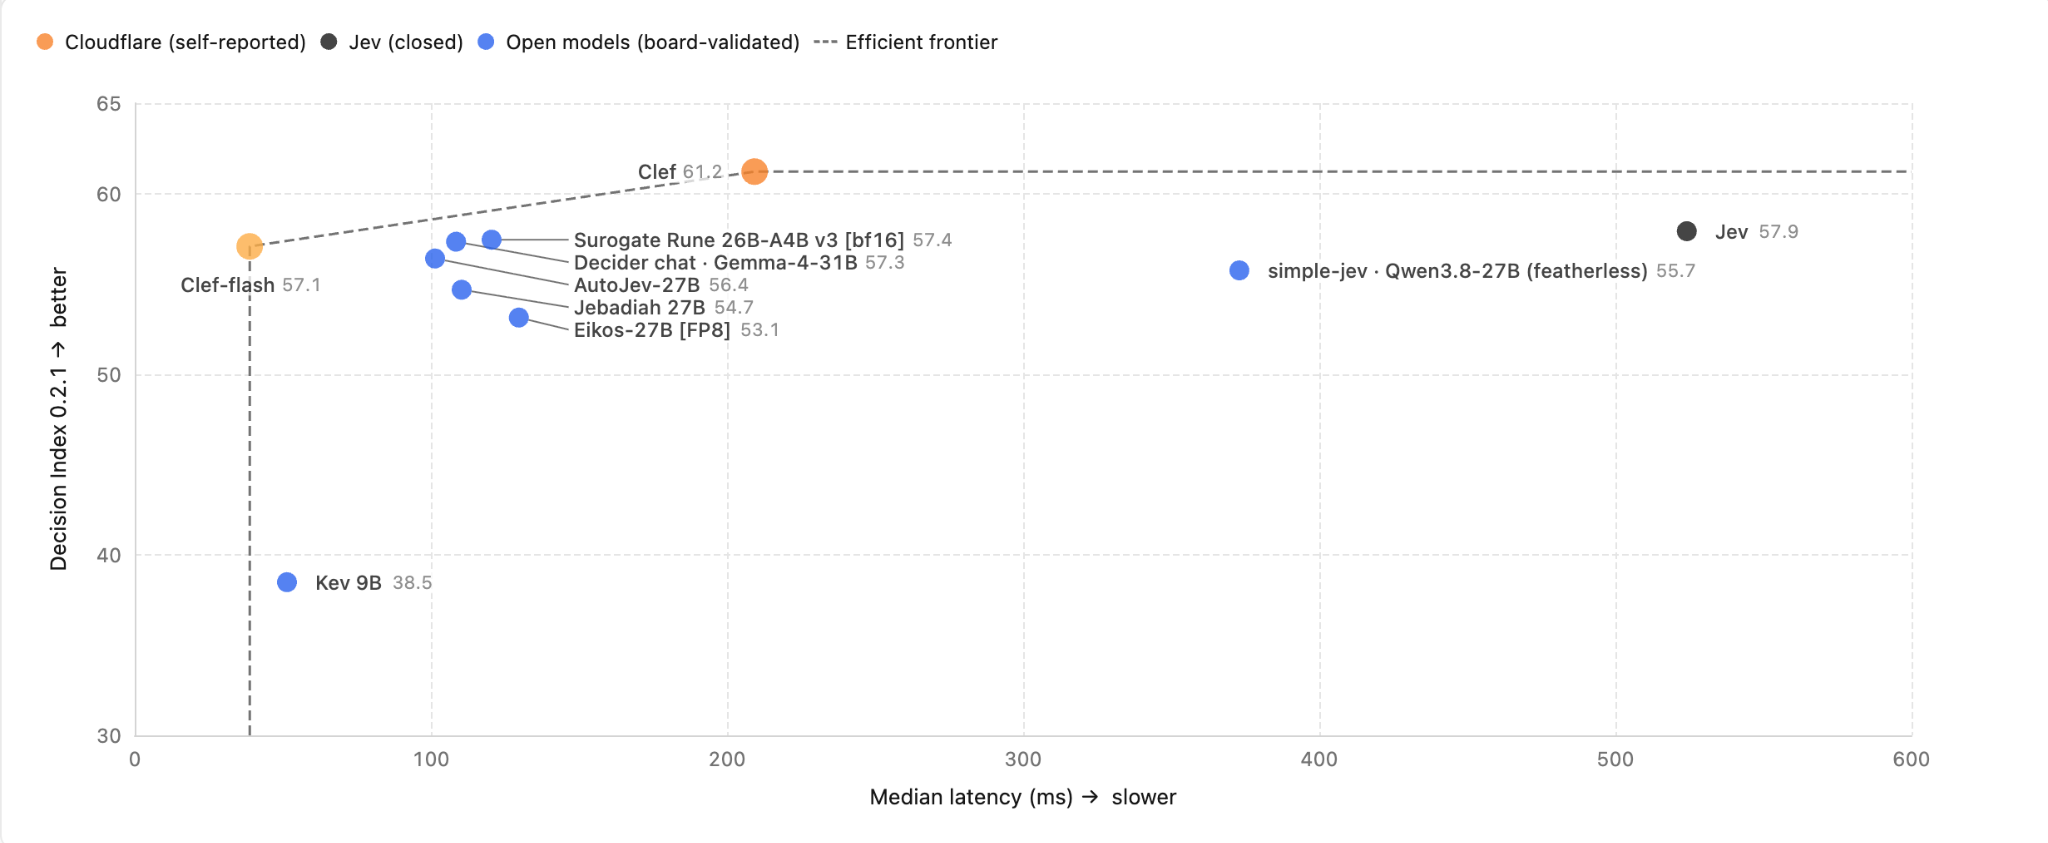 Figure : Comparaison entre Jev Decision Index et latence, plaçant la suite Clef sur la frontière d’efficacité de Pareto. Source : Cloudflare Blog (chiffres autodéclarés)
Les nuances derrière les performances affichées
Un regard lucide s’impose. Toutes les données du nuage de points ci-dessus portent la mention « Cloudflare (autodéclaré) ». Comme l’a vérifié The Register, ces mesures n’ont pas encore fait l’objet d’une validation indépendante sur le tableau officiel du Decision Index sur Hugging Face. La distinction graphique faite par le blog entre « Jev (fermé) » et « Modèles ouverts (validés) » met elle-même en lumière l’écart entre annonces internes et vérifications collégiales.
La grille tarifaire apporte un autre éclairage. À 0,24 $ le million de tokens, Clef coûte près de six fois plus cher que Jev (0,042 $/M), et Clef-flash (0,09 $/M) reste deux fois plus onéreux. Plusieurs participants de Hacker News ont souligné que le graphique de Pareto omet opportunément la dimension du coût. Si l’on réintègre l’axe financier, l’allure de la frontière d’efficacité change radicalement : l’avance en performance est bien réelle, mais elle s’achète au prix fort.
Les contraintes de déploiement en local s’avèrent tout aussi exigeantes. Michelle Chen, cheffe de produit chez Cloudflare, a confirmé à The Register que Clef réclame 85 Go de mémoire vidéo (VRAM) et Clef-flash 41 Go (dans une hypothèse de concurrence unique avec 64k de contexte). Bien que la mise à disposition des poids autorise l’auto-hébergement, les cartes graphiques grand public sont totalement hors course. Sur HN, plusieurs intervenants ont rappelé que pour des tâches spécialisées et restreintes, entraîner un petit modèle de type BERT sur un portable en une heure offre une latence bien plus basse que n’importe quelle API distante. La véritable raison d’être des modèles de décision généraux réside dans les cas de démarrage à froid, lorsqu’aucune donnée d’entraînement spécialisée n’est disponible.
Enfin, les jeux de données d’entraînement demeurent secrets. Si les poids relèvent de la licence Apache 2.0, The Register a confirmé que les données d’apprentissage n’ont pas été publiées. La portée du caractère « open source » dépend dès lors de l’importance accordée aux poids plutôt qu’aux données sources.
Le débat HN : réelle avancée ou simple rhabillage d’un classificateur ?
Sur le fil de discussion de Hacker News (478 points), le commentaire le plus approuvé a cristallisé le débat : « Comment se fait-il que tant de personnes parviennent à concevoir des modèles de décision en quelques jours ou semaines ? Ce concept n’existait-il pas déjà ? »
Les réponses techniques les plus solides ont clarifié la situation : l’architecture transformer produit par nature des distributions de probabilité sur le vocabulaire. L’usage de sorties contraintes (structured outputs) et de logprobs pour accomplir des tâches de classification est éprouvé depuis des années dans la communauté. Demander un token au modèle et classer les options selon les logprobs fonctionne parfaitement, même avec des architectures modestes. Des développeurs ont poussé l’analyse plus loin : l’innovation majeure de Jev reposait sur l’interface et le formatage de l’API, rendant une méthode ancienne limpide pour l’ensemble des ingénieurs ; or, une API est la chose la plus rapide à répliquer. La floraison d’alternatives ouvertes sur Hugging Face (AutoJev, Jebadiah, Kev et maintenant Clef) en l’espace de deux semaines témoigne de la modicité du ticket d’entrée.
Néanmoins, un contre-argument prévaut : le calibrage constitue le verrou déterminant. Construire un classificateur véloce est accessible ; faire en sorte que les probabilités prédites correspondent fidèlement à la confiance empirique est particulièrement complexe, et beaucoup reconnaissent à Jev une qualité de calibrage remarquable. Du point de vue de l’ingénierie des données, le bilan est sans équivoque : l’architecture du modèle est « la partie amusante et facile », tandis que la véritable difficulté repose sur la qualité des données et la rigueur de l’évaluation. Sans annotations soignées, il est impossible de certifier la fiabilité d’un classificateur.
Ces deux analyses décrivent les deux facettes d’un même phénomène : la mécanique est accessible, mais des probabilités fiables réclament une ingénierie de données massive. La capacité de Cloudflare à répliquer en deux semaines s’explique par quinze ans d’accumulation de trafic réseau et de chaînes d’annotation propriétaires. C’est ce qui le distingue fondamentalement des clones développés en un week-end.
La manœuvre stratégique : la plateforme de RL intégrée
La seconde moitié de l’annonce officielle dévoile un enjeu bien plus lourd de conséquences que Clef lui-même : Cloudflare a présenté simultanément un service de fine-tuning par renforcement (RL), offrant aux entreprises la possibilité d’adapter Clef à leurs contextes métiers à partir de leurs propres données.
Le pipeline d’entraînement imbrique des briques existantes de la plateforme : AI Gateway intercepte le trafic de production pour composer des jeux de données, Workers AI produit les rollouts, Containers exécute les fonctions de récompense en bac à sable, un nouveau composant Trainer actualise les poids, et BYO Model redéploie le modèle optimisé sur les nœuds perimétriques (edge). Cloudflare applique déjà cette boucle à ses propres services : modération Trust & Safety, dispatching des tickets d’assistance et identification des bots, autant d’usages adossés à des bases historiques considérables de données annotées.
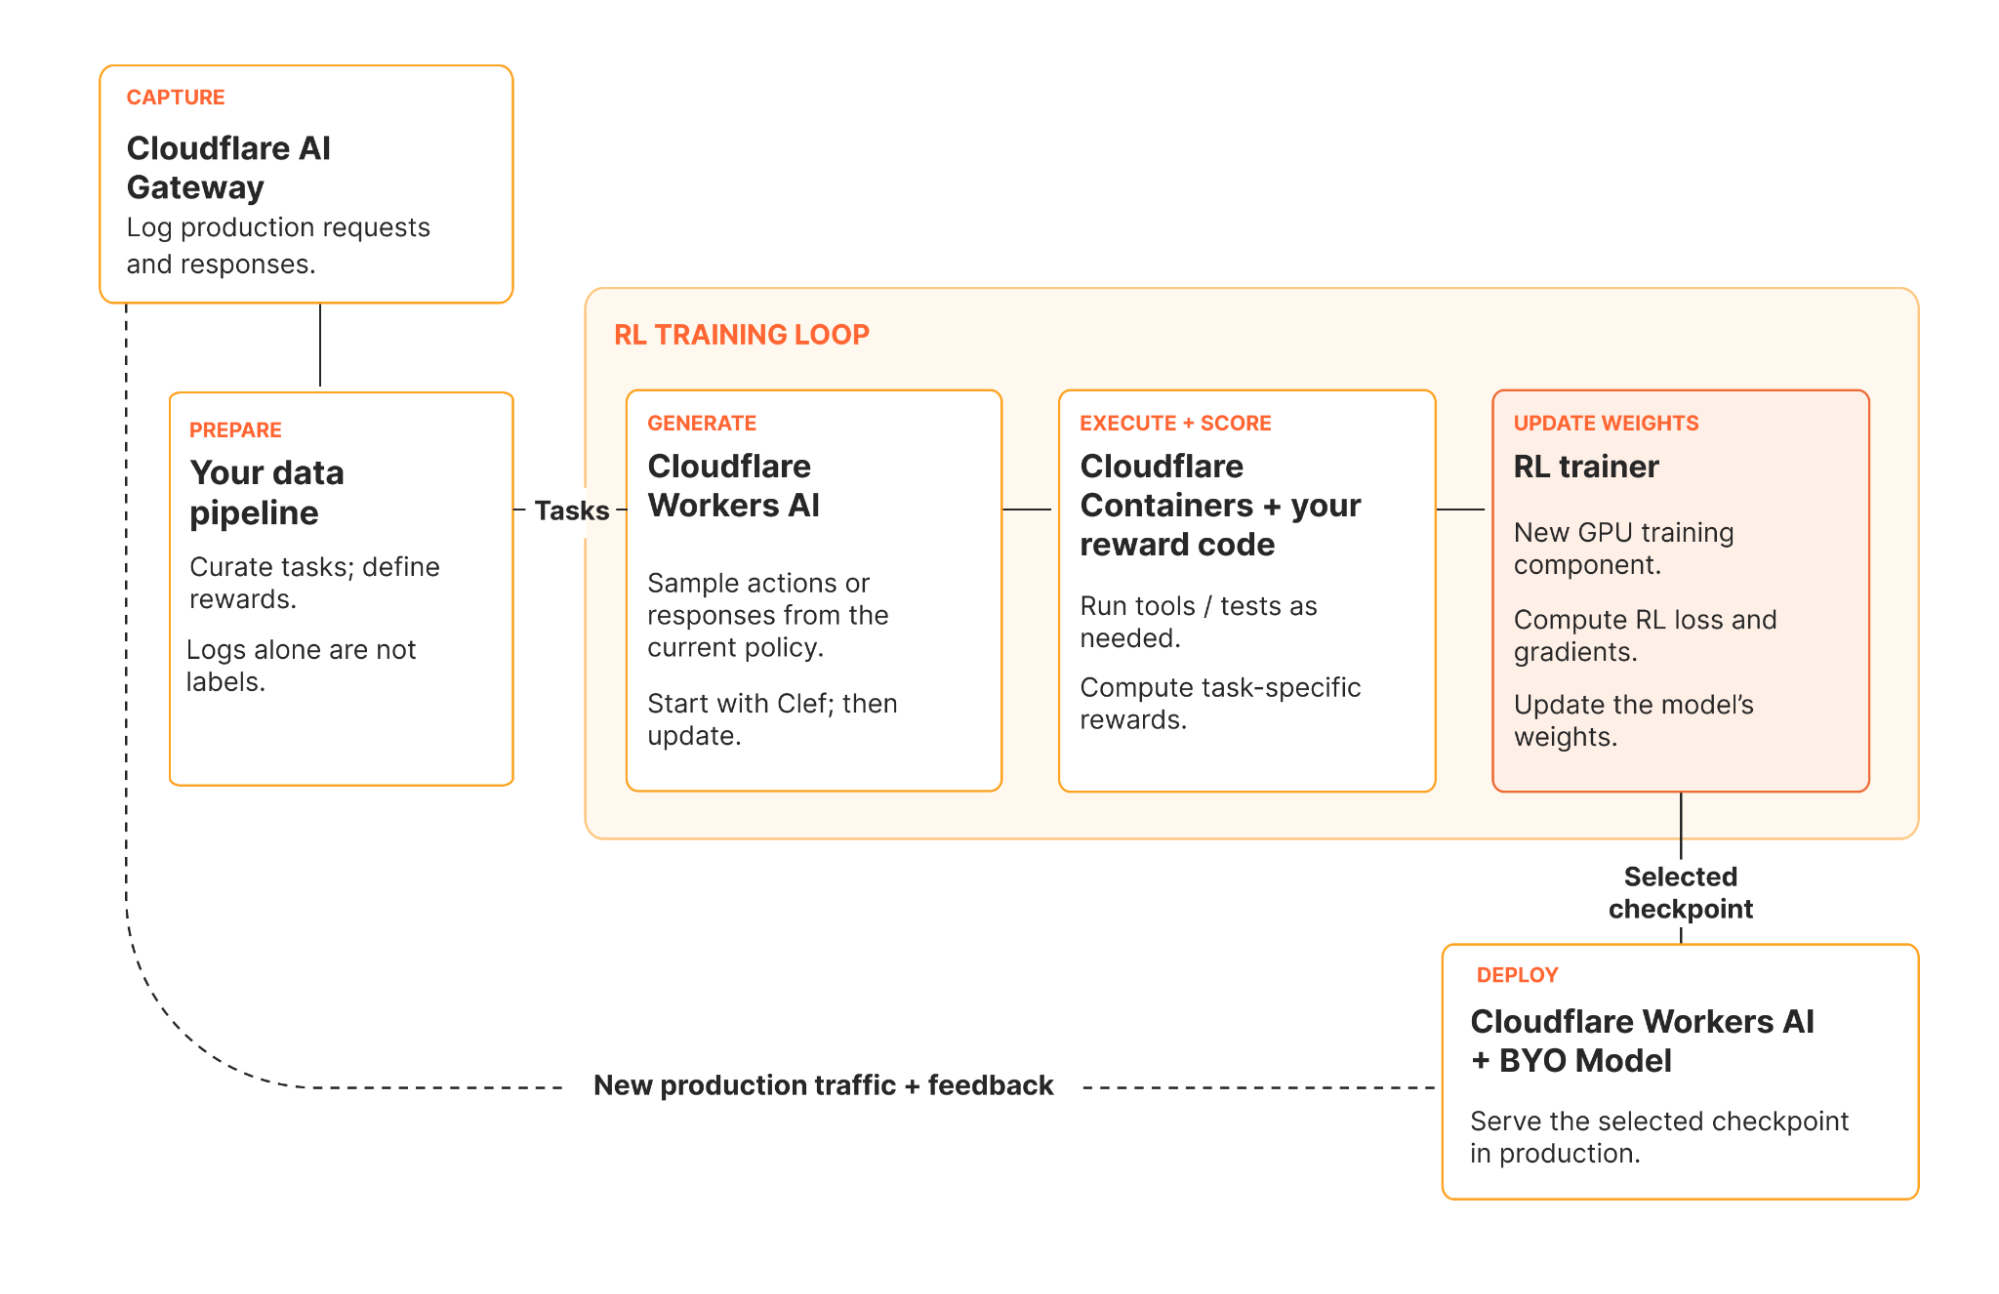 Figure : Architecture du pipeline de fine-tuning RL : collecte des données via AI Gateway, cycle d’apprentissage et déploiement final sur le réseau périphérique. Source : Cloudflare Blog
La visée commerciale apparaît limpide : la vente brute de tokens d’inférence dégage des marges réduites. La véritable opportunité consiste à verrouiller l’ensemble de la boucle (« modèle de base → environnement d’entraînement RL → déploiement edge ») dans l’écosystème Cloudflare. Si les données collectées par AI Gateway demeurent la propriété des clients, le moteur d’exécution et d’apprentissage reste captif de l’infrastructure Cloudflare. Cela s’articule parfaitement avec sa stratégie d’« agent cloud » : les modèles de décision constituent les composants les plus fréquemment sollicités sur le chemin critique des agents autonomes, et quiconque maîtrise ce goulot d’étranglement captera le flux primaire du trafic d’IA de demain.
En conclusion
Reconstituer Jev en deux semaines prouve que la barrière technologique à l’entrée des modèles de décision est basse : partir d’une base Qwen existante, faire l’économie de la génération autorégressive et évaluer les options en parallèle est à la portée de toute équipe disposant d’infrastructures solides.
La véritable différenciation se jouera sur les fondamentaux : la robustesse du calibrage des probabilités face aux cas limites, la capacité des pipelines de données à alimenter un ajustement RL continu, et l’aptitude du réseau edge à tenir la promesse des 38 ms sur une échelle géographique mondiale.
Pour les équipes de développement, la conduite la plus pragmatique s’impose d’elle-même : l’API de Clef est compatible trait pour trait avec celle de Jev et ses poids sont ouverts. Y soumettre ses propres jeux d’évaluation ne prend qu’une dizaine de minutes pour observer, chiffres à l’appui, quelle solution répond le mieux aux impératifs de production.
Liens de référence :
- Blog de Cloudflare : Introducing Clef — our open-source decision models, and new RL fine-tuning platform
- The Register : Cloudflare tries to outplay Jev with open-weight Clef models
- Discussion sur Hacker News : Clef — Open-weight decision models, and new RL fine-tuning platform
- Hugging Face : Fiche de modèle Cloudflare/clef
- Documentation Cloudflare : Workers AI Clef Documentation