苹果在 M5(2025)上把神经引擎(ANE)的计算核折进了 GPU 核,把「LLM 性能」写进了这一代的卖点。今年 8 月,开发者 Eileen Yoon 公开了她对 M1 ANE 的完整逆向工程复盘,从计算核一路拆到内存通路。两件事摆在同一个时间轴上看,指向同一个结论:ANE 输给了 2017 年写进硅片的工作负载假设——它为「可预测复用的稠密 CNN」设计了一整套数据流,而自回归解码把可预测复用变成了最坏情况。
苹果折叠了独立 NPU
ANE 从 2017 年的 A11 Bionic 开始上机,最初专门针对稠密图像处理类 CNN 负载。开发者 Eileen Yoon 三年前曾试图为 ANE 写一个 Linux 驱动,但随后放弃。她的理由很直接:架构太有主见,做不成通用加速器平台。连 macOS 自己也只在 Finder 里用它跑个生成预览图的上采样。
在 ANE 落幕时,Eileen 回头做了一件纯粹的技术解剖:把 M1 ANE 的计算、调度、内存和执行模型完整拆了出来。
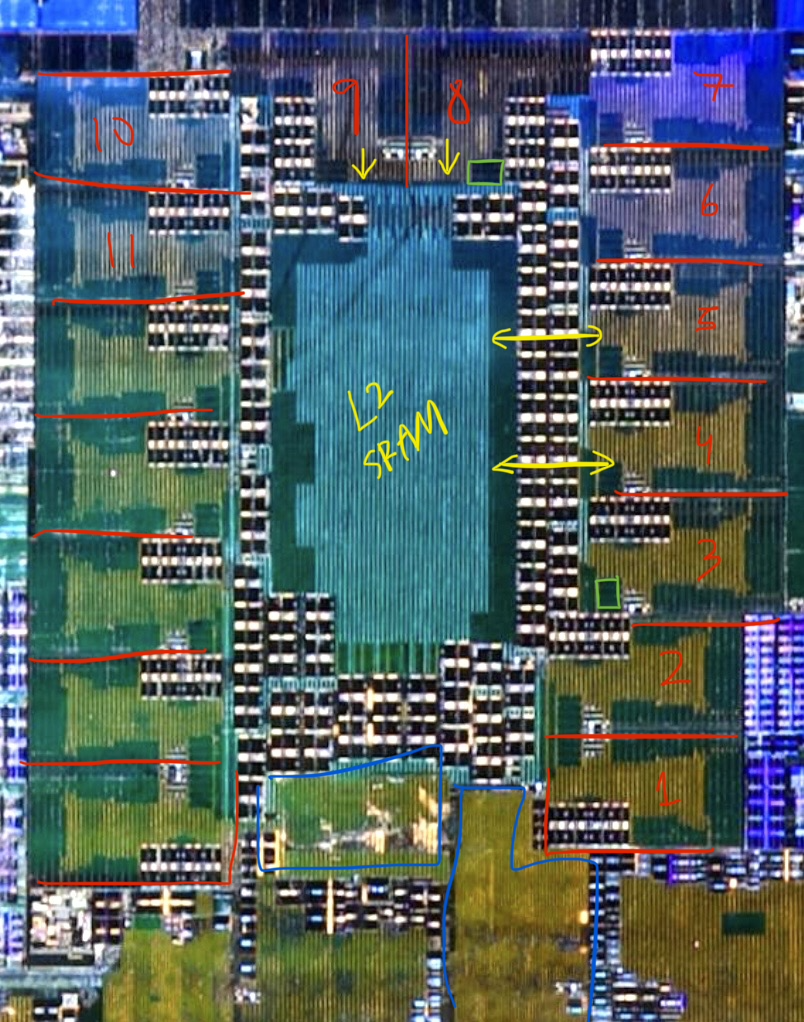 图:M1 ANE 芯片布局:中央是 L2 SRAM 矩形,两侧各排布 7+7 个核。来源:Eileen Yoon 逆向工程笔记
在 Eileen 的判断里,M5 把 ANE 核折进 GPU 核,是独立 NPU 路线收尾的标志。决定 ANE 性格的是围绕 MAC 搭起来的数据流——输入输出何时、何处进入、停留、移动。乘法累加单元本身没什么特别:一个点积就是一个点积,一个 MAC 也只做一件事,差异全在它周围的数据通路。
MAC 不背锅,数据流定生死
逆向结果显示,M1 ANE 拥有 16 个计算核,每核 128 条 FP16(或 256 条 INT8)MAC 通道,合计 2048 条并行 MAC 通道。硬件每周期执行 2048 次并行归约,时间轴是它唯一的归约方向。乘加结果直接进入后置激活单元,中途不写回内存。
| 组件 | 规格/状态 | 逆向推断结论 |
|---|---|---|
| 计算核 | 16核,2048条 MAC 并行 | 定点归约,读出时转 FP16 |
| 累加器 | 32位 Q16.16 格式 | 饱和上限在 2^15 |
通过构造全 1 向量的点积,Eileen 观察到累加器溢出行为:当 CPU 十六进制 0x7800 对应 32768 时,ANE 输出的 0x7c00 在 CoreML 里变成了正无穷。钳位发生在累加器内部,而不是 FP16 输出端。这种硬连线的流水线保证了特定网络结构的高能效,但也堵死了通用矩阵乘法的灵活性。
用查找表插值搞定激活函数
在非线性激活处理上,ANE 采取了粗暴且有效的硬件查表法(LUT)。逆向发现,非线性模式通过状态控制:0 代表无表,1 代表 ReLU,2 对应 tanh。
对于 tanh,Eileen 编译了一个只含 TANH 层的 CoreML 模型。反编译硬件寄存器文件(hwx)后,她在 0x4288 地址处找到了 33 个连续的 FP16 字,正好对应 round16(tanh(i/8))(i 取 0 到 32)。通过脉冲 LUT 实验验证,输出呈现三角形,证实相邻表项之间在执行线性插值。
编译器在下发任务前,会把常量的缩放和偏置直接折进卷积权重里。原始权重为 4、偏置为 -2、缩放 0.5、偏移 1 的模型,编译后直接变成权重 2、偏置 0。这与解码 model.espresso.weights 的结果一致。
调度前端像极了 GPU 推送缓冲
ANE 的驱动层面设计得很死板。驱动从不给 ANE 下发 CONV、MATMUL 或 RELU 这类具体操作码。整个神经网络在前端被编译成一串任务描述符(task descriptor),驱动只负责把任务放到内存,把指针写进 TM_ADDR 和 TM_SIZE,最后敲 TM_PUSH 门铃提交给硬件。
这个前端机制像极了 GPU 的 pushbuffer,硬件自己消费命令流,完成后再中断 ARM64 核。不过 ANE 采用的是定长描述符,TM_INFO 寄存器里只存描述符双字数和总数量,这与 GPU 变长命令流存在核心差异。任务队列状态、优先级和 BAR 寄存器分布在 8 组队列块(qid 0 到 7)中。
内存带宽锁死解码上限
大模型的瓶颈在访存,而 ANE 的内存架构让它在跑 LLM 时雪上加霜。逆向揭示,ANE 必须先把自己要用的内存拷进本地 SRAM。统一内存机制在这里不等于零拷贝流式访问。
| 内存层级 | 容量 | 用途 |
|---|---|---|
| KMem | 每核 64 KiB,16 核合计 1 MiB | 存放卷积核 |
| L2 SRAM | 全局共享 2 MiB | 跨核共享 |
| L1 | 每核独立 | MAC 输入暂存 |
这三层里没有 L2 到 KMem 的直连通路。按 Eileen 的推测,这条缺口的来源是 2017 年「卷积核不会被当成数据」的假设,跟带宽竞争无关;她自己也承认这是从既有设计反推出来的判断。以 M1 ANE 标称 11 TOP/s、系统 DRAM 68 GB/s 算,屋顶线拐点在 162 OP/byte:算术强度低于这个数,算力再快也不会提升解码的 token/s。
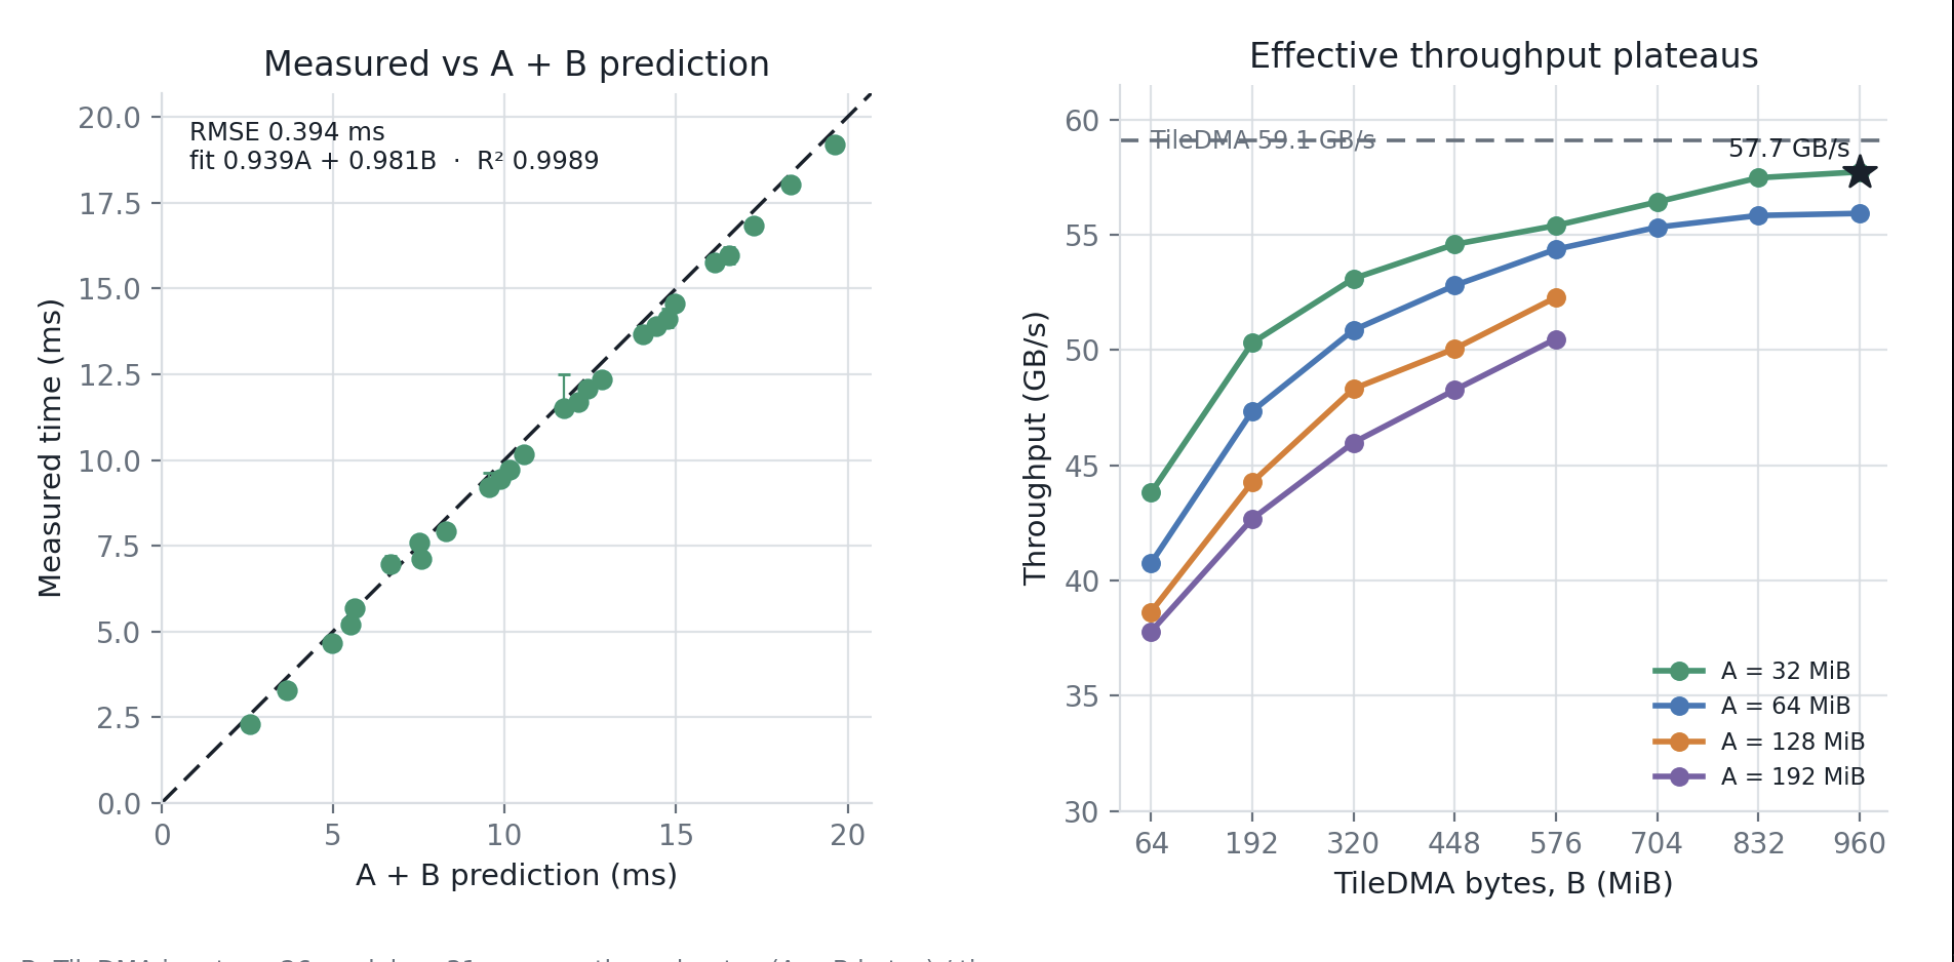 图:kernel DMA 与 tile DMA 运行时间相加性回归:两条通路串行,不重叠。来源:Eileen Yoon 逆向工程笔记
在 M3 上实测 DRAM 读带宽显示,ANE 的 KernelDMA 为 37.99 GB/s,TileDMA 为 59.08 GB/s,而 GPU 能跑到 77.70 GB/s。核流量与 tile 流量呈现串行特征,两条通路无法叠加。
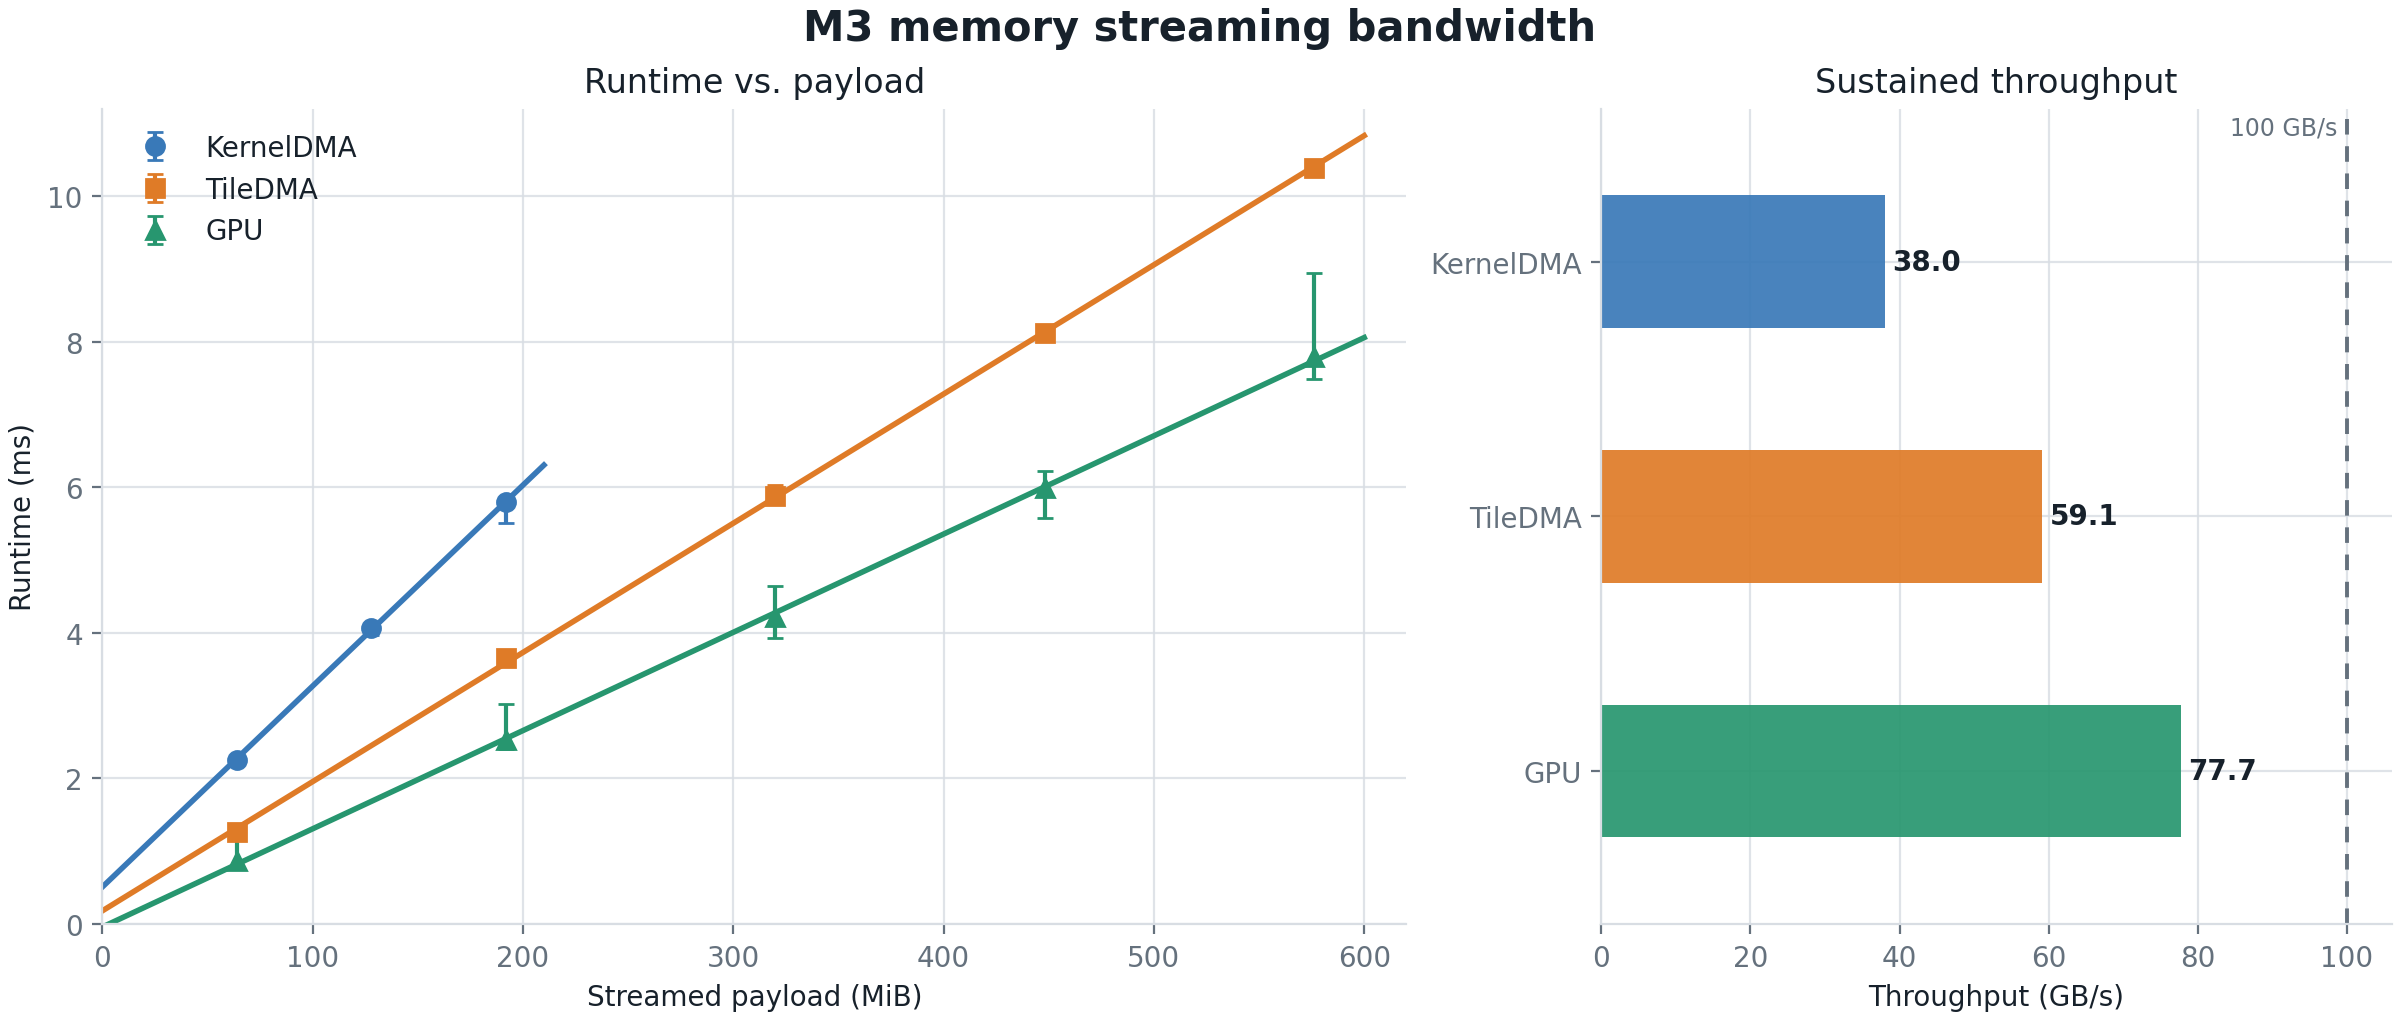 图:M3 上 ANE 与 GPU 的 DRAM 读吞吐实测对比。来源:Eileen Yoon 逆向工程笔记
ANE 的 DRAM 吞吐面临双重受损:单路上限低于 GPU,且两路通道无法并行。只有流式带宽提升约 2.5 倍时,解码速度才可能从 10 tok/s 提到 25 tok/s。
把 ANE 折进 GPU,是苹果对这条硬件路线下的判断。这套流水线为卷积网络打通了局部复用,代价是把通用性锁死;等到自回归解码成了主流负载,瓶颈落在内存搬运上,而 ANE 的两条 DMA 通路既跑不过 GPU,又不能并行。上面每一个数字都是逆向推断出来的,作者也明说了自己有「扶手椅工程」的成分——但那些实测带宽和寄存器取证,指向的方向是一致的。
参考链接:
- Eileen Yoon 个人博客文章
- Hacker News 社区讨论