D=1536 的单 token 解码耗时 310.9 微秒,D=2048 耗时 997.6 微秒。参数维度仅仅增加了三分之一,苹果 M3 神经引擎的处理时间却飙升了近 3 倍。2048 恰好是当前主流开源模型 Llama 3.2 的默认特征维度。这种反常识的性能断崖,直接拖慢了整整一代端侧开源大模型的部署速度。
苹果 M3 芯片配备了 128 bit 的 LPDDR-6400 内存,理论 DRAM 上限高达 102.4 GB/s。实际测试也证实了这一点,在常规状态下它能稳定输出接近宣传值的 100 GB/s 带宽。当模型尺寸恰好卡在特定整数倍时,一半以上的显存带宽会凭空消失,这个问题隐藏在常规基准测试的视线之外。
扫出 2048 共振波谷
精确的测试数据揭开了性能塌陷的边界。当 D=2016 时,M3 神经引擎(ANE)的吞吐量保持在 44.5 GB/s。一旦 D 踩中 2048,吞吐量暴跌至 16.93 GB/s,降幅超过 60%。
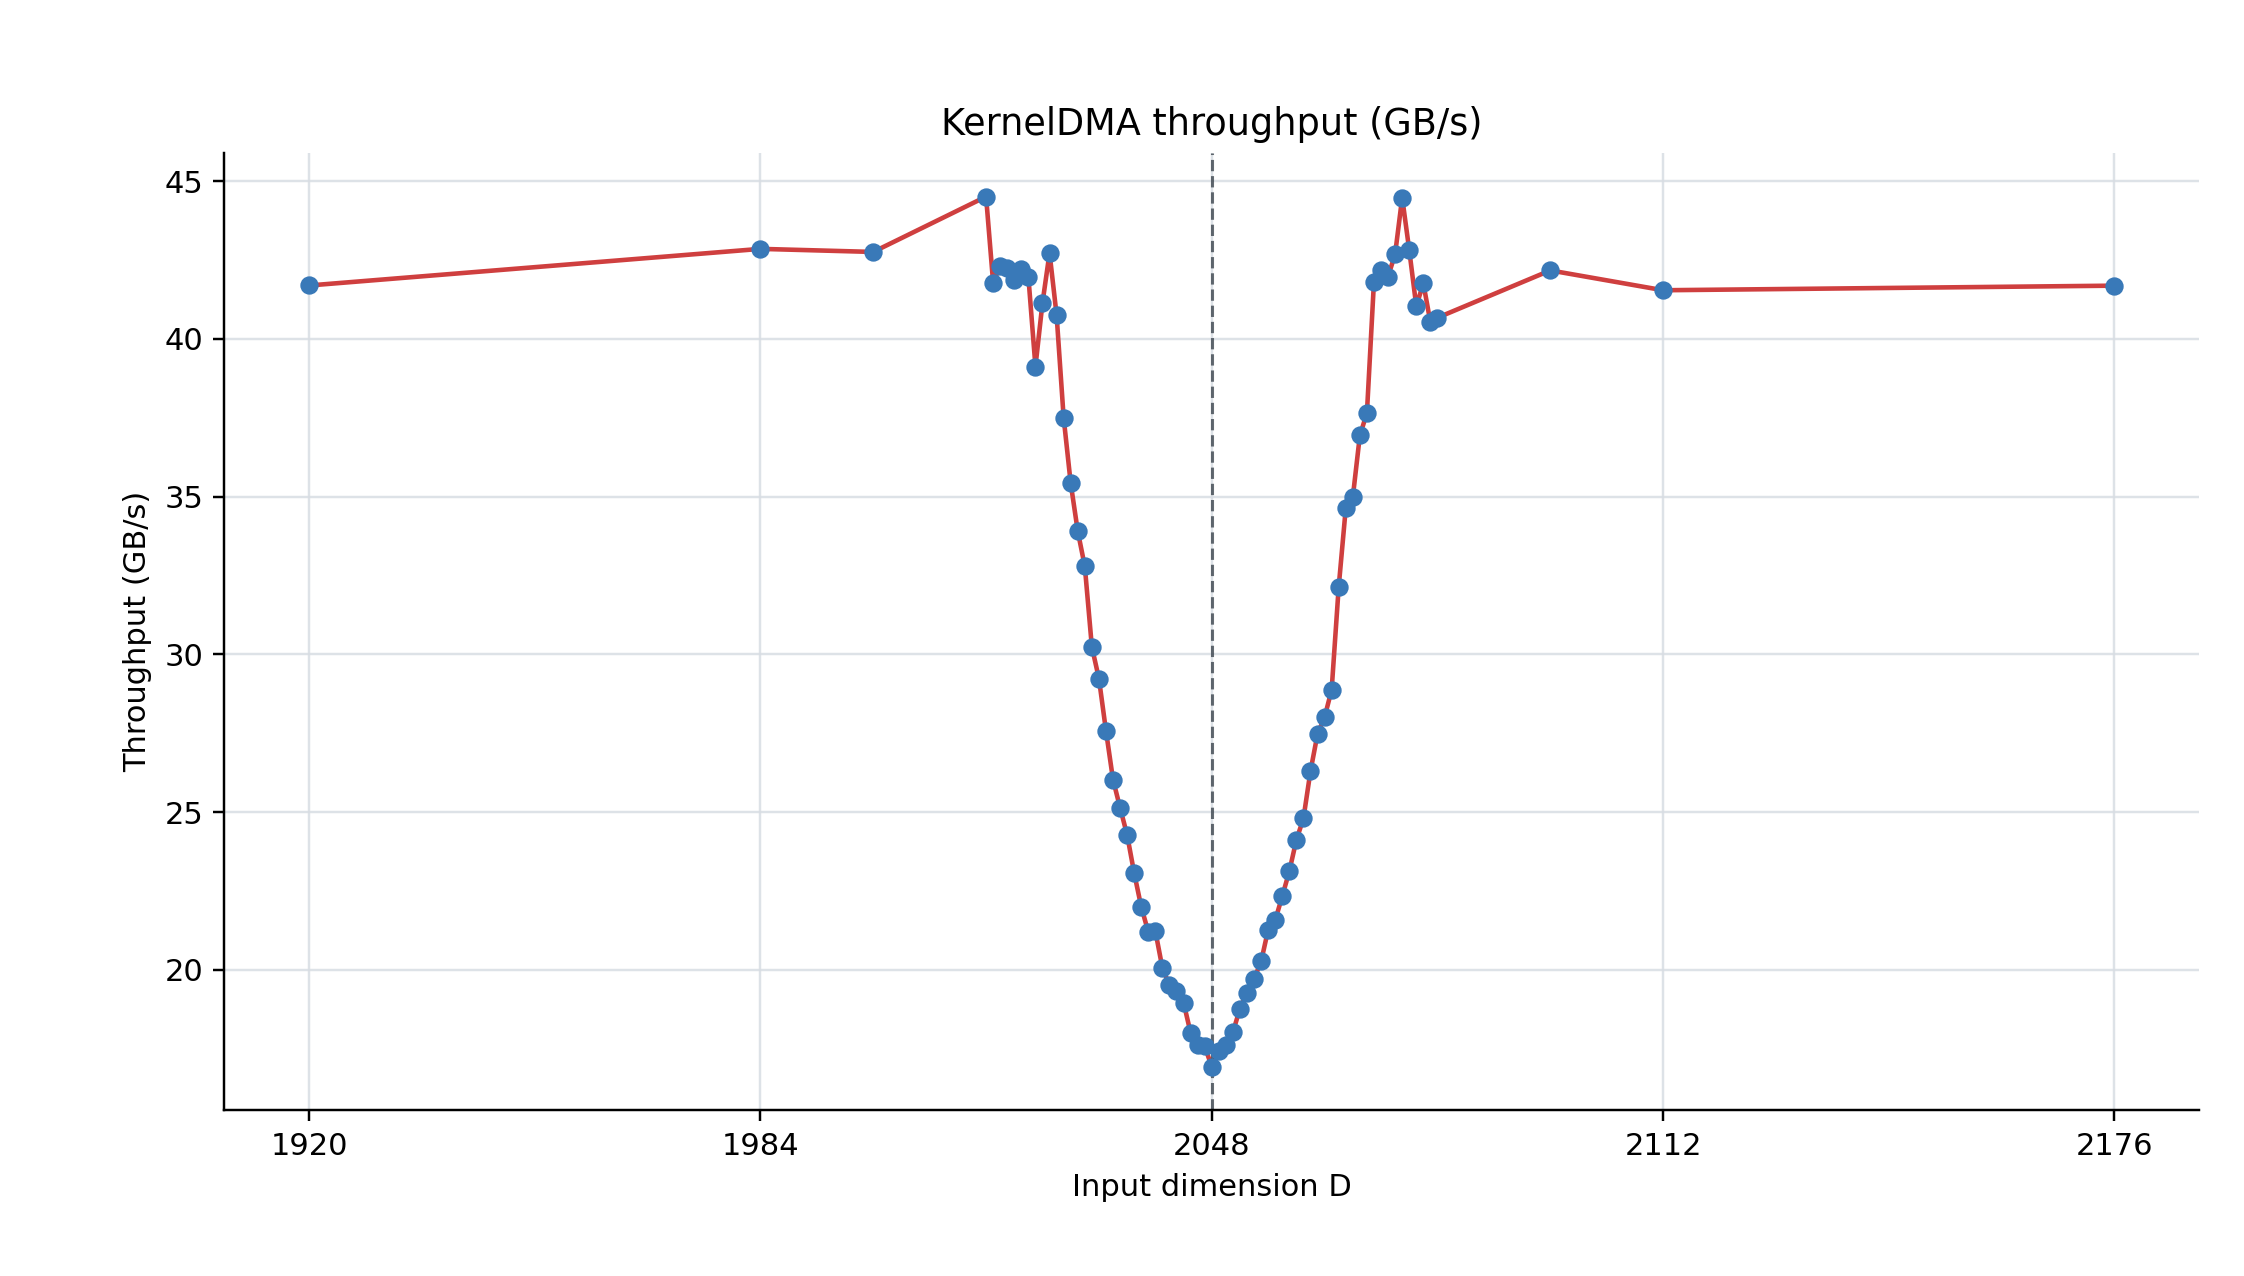 图:D 在 2048 附近的带宽塌陷。来源:Eileen Yoon,eiln.github.io
作者把 D 值在整个测试孔径上做了全量扫描,引入了 67 个不同的 D 值和 41 轮随机化操作,共采集 2747 个样本。数据图表显示,吞吐率对 D 的曲线存在一个以 2048 为波长的共振谷。所有 2048 的整数倍都被死死压在 17-19 GB/s 的地板上,而只要偏离大约 256 行(等价于 16 KiB,即一个内存页),带宽就能瞬间恢复正常。
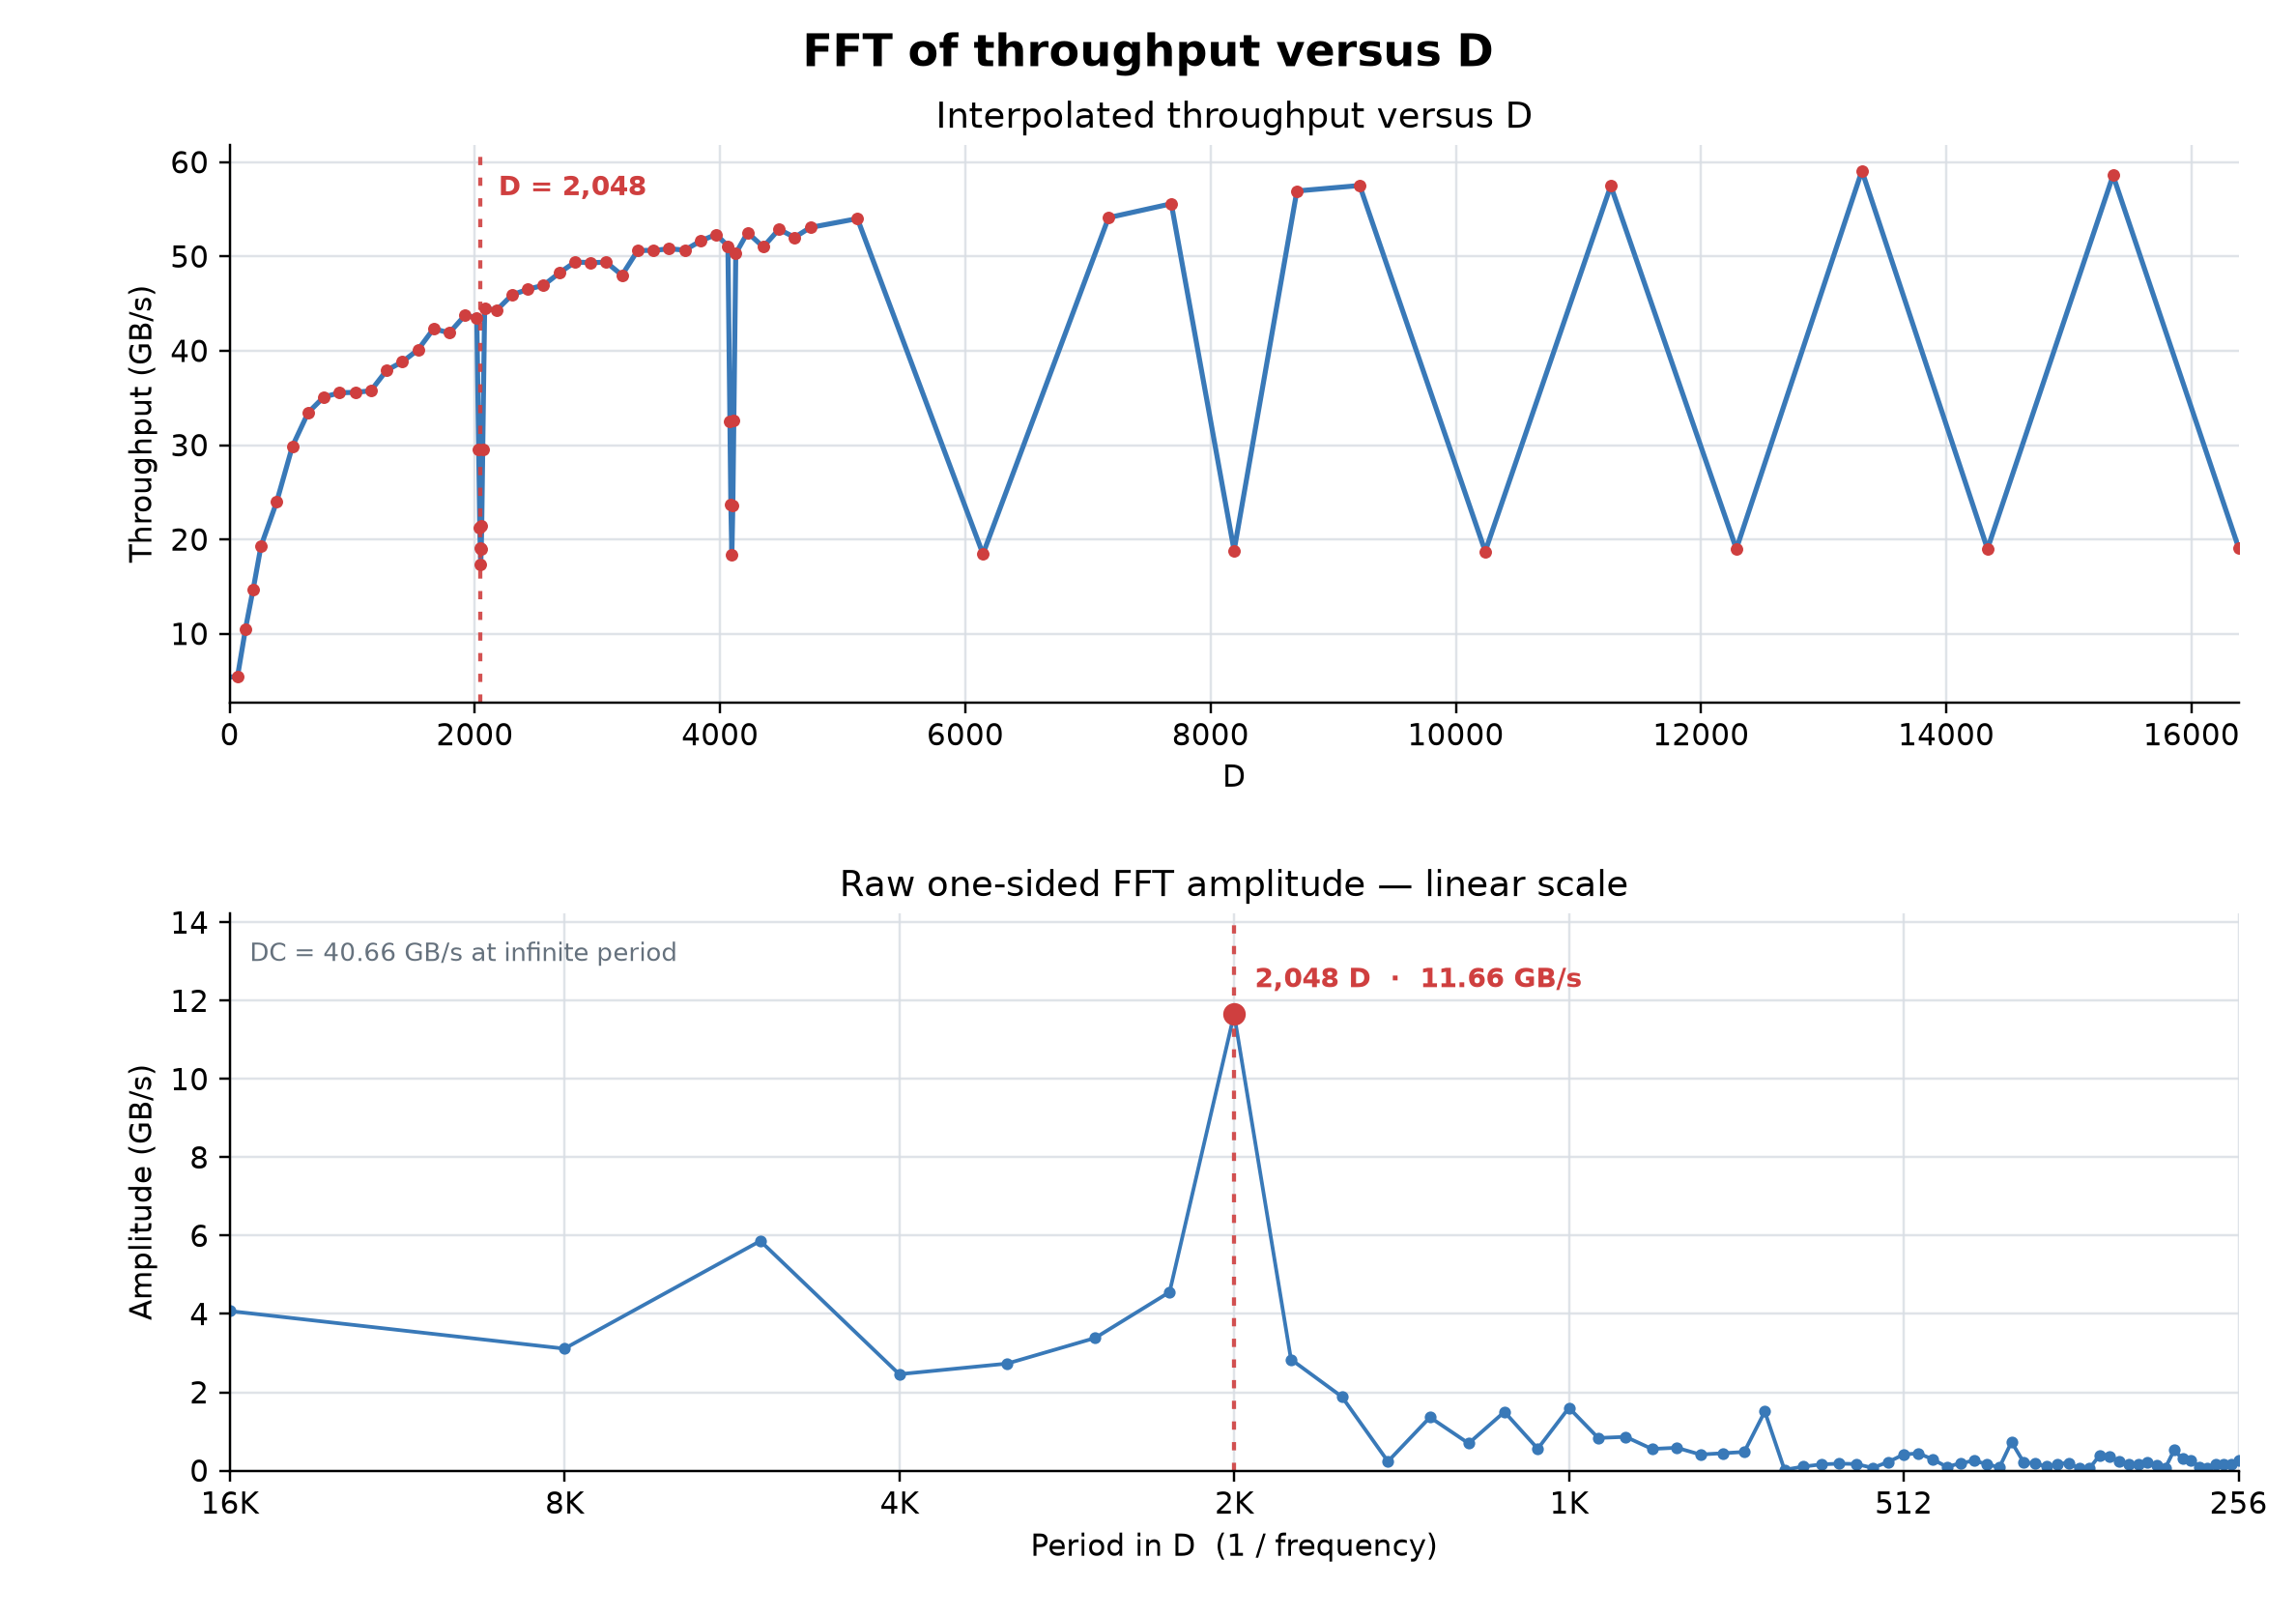 图:吞吐率对 D 的 FFT 频谱,显示出 2048 的主谐波。来源:Eileen Yoon,eiln.github.io
把吞吐率画成 FFT 频谱图后,2048 的主谐波峰值清晰可见。性能黑洞并非由于操作系统抖动随机产生,底层的硬件逻辑存在一个隐蔽且绝对的数学硬边界。
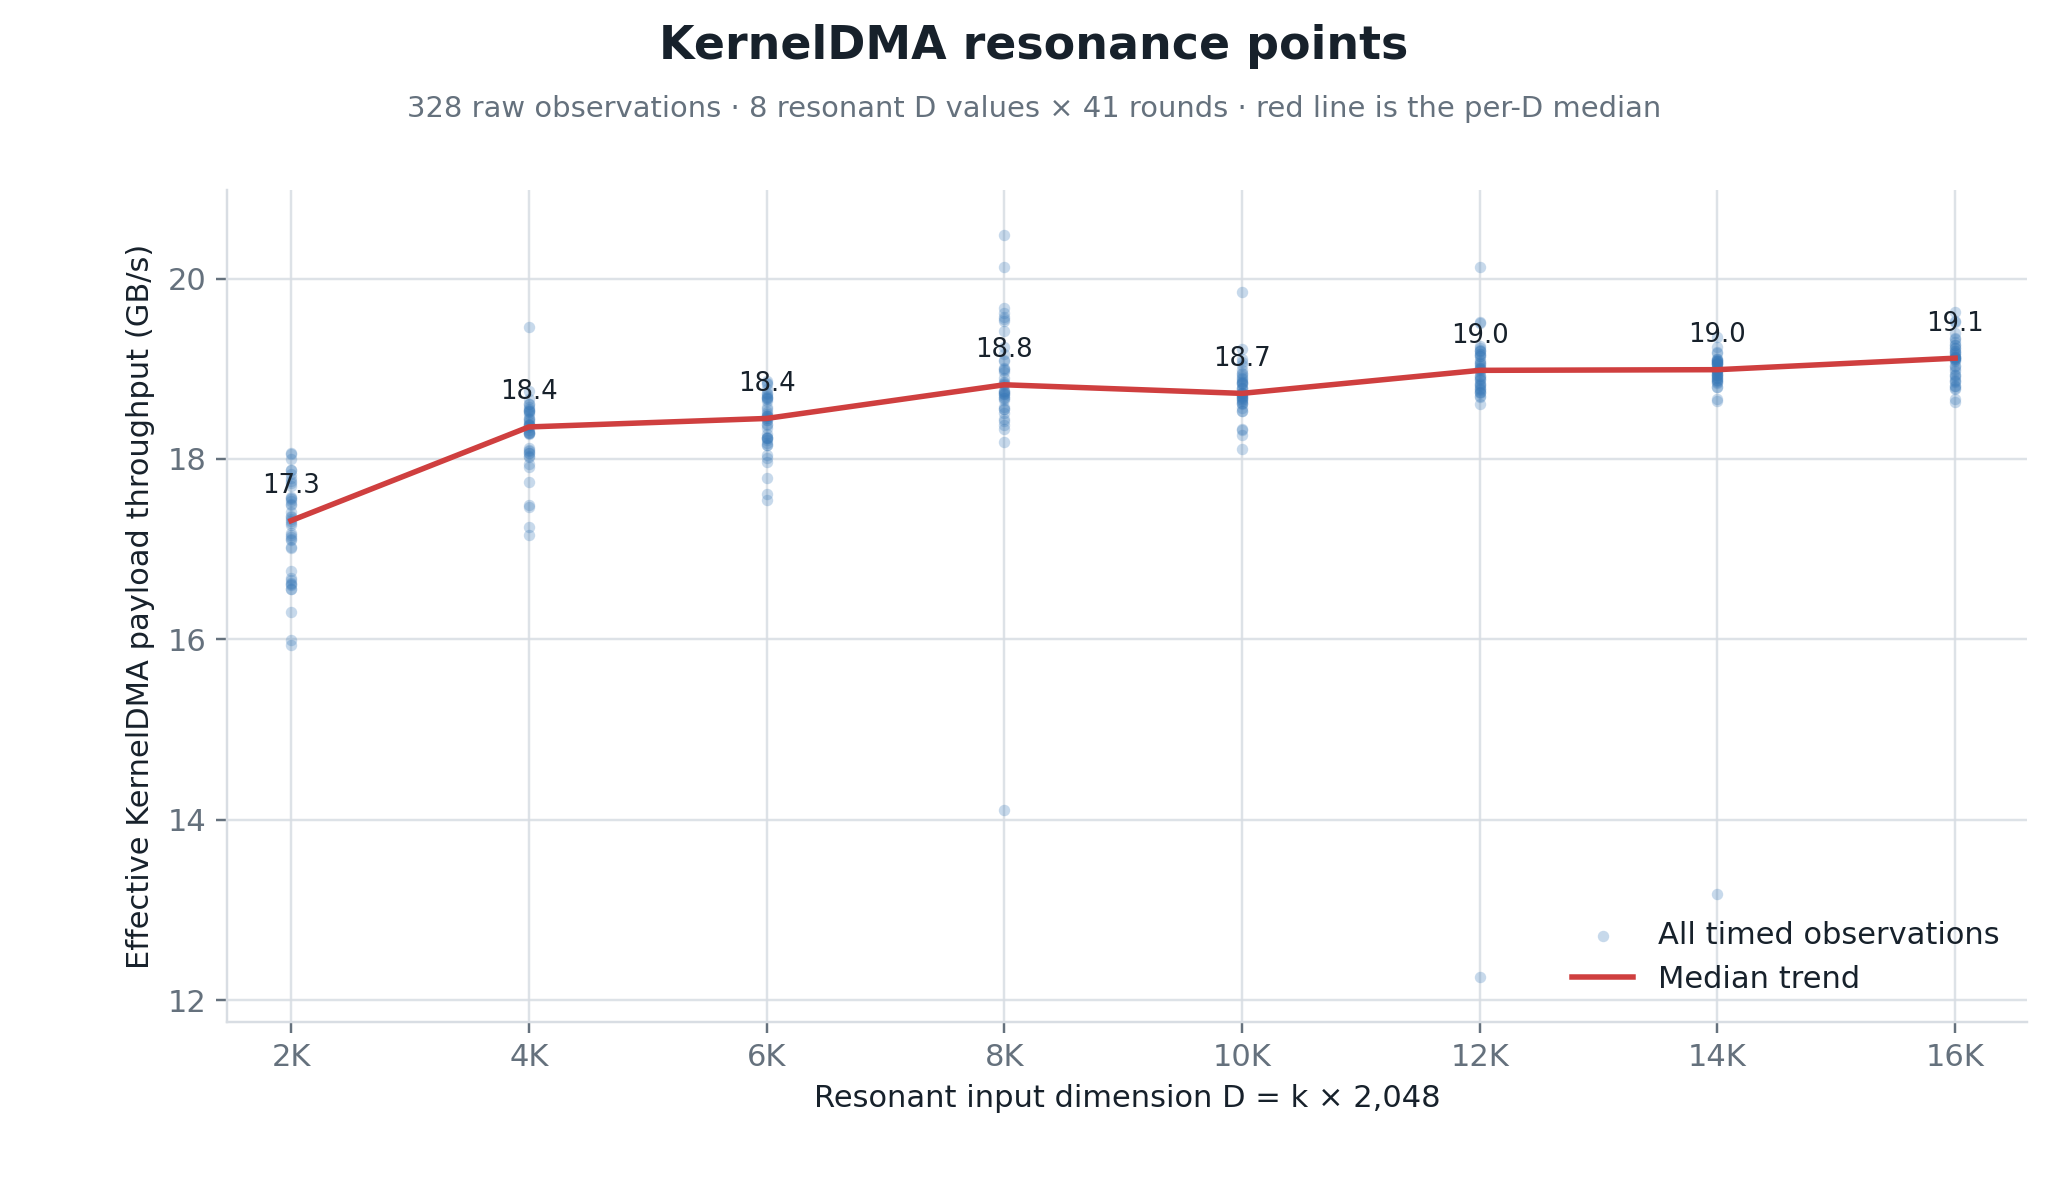 图:所有 2048 整数倍处的带宽凹口。来源:Eileen Yoon,eiln.github.io
排除系统资源争抢嫌疑
排查性能异常的第一步是隔离外部干扰因素。测试首先针对 DRAM bank 空间相关性进行了检验,将内存地址在整个大约 64 MiB 的 IOVA 区间内进行随机打散,并执行了 287 轮交错测量。中位吞吐量仅仅从 31.37 GB/s 极小幅度上升到 32.29 GB/s。内存空间的相关性并不能解释 28-43 GB/s 如此巨大的性能缺口。
随后引入了多核满载的交叉比对测试,将活跃核心数从单核一路扫描拉升到 16 核满载。结果表明,无论激活多少个计算核心,D=2016 与 D=2048 的延迟比率始终恒定不变。
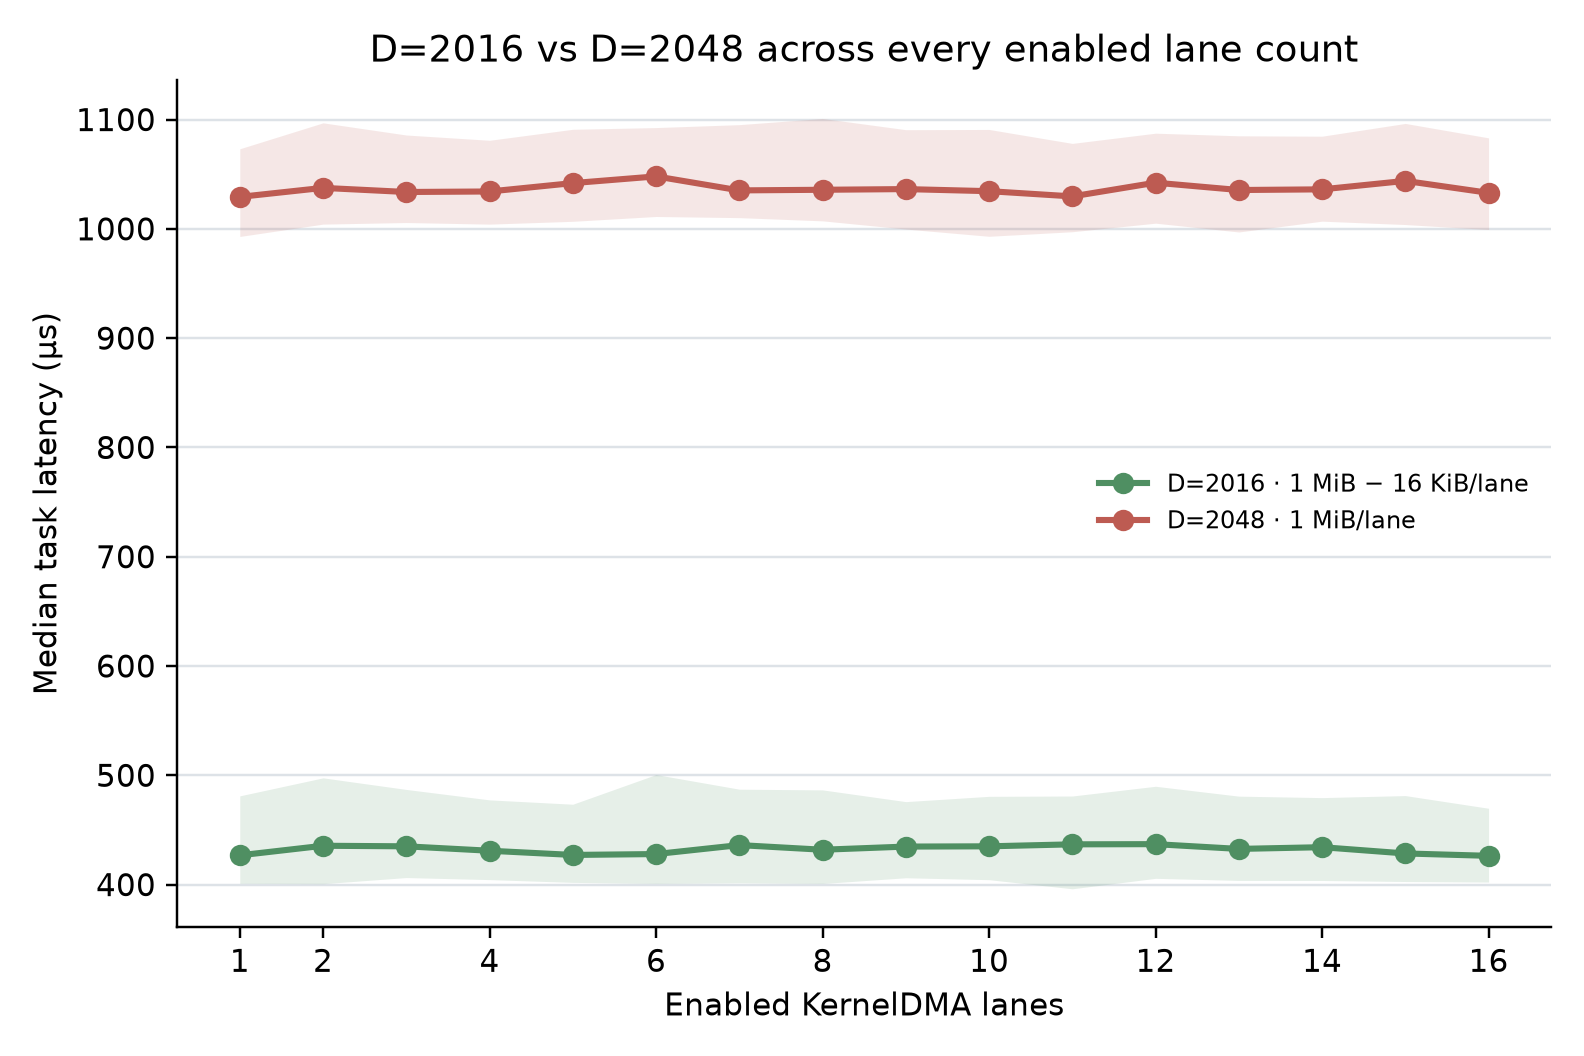 图:活跃核心数从 1 扫到 16 的延迟曲线。来源:Eileen Yoon,eiln.github.io
节流现象在最底层的单核层面就已经存在,排除了系统层面的总线拥堵与多核调度不佳问题。嫌疑对象被进一步剥离,直接锁定在计算核心内部本身的直接内存访问(DMA)行为特征上。
14位指针饿死预取管线
M3 硬件架构中,ANE 具备 16 个核心,每个核心配备 64 KiB 的核心内存,而 Kernel DMA 的行粒度被设定为 64 字节。2048 的整数倍在数据量上对应每核 1 MiB 的内核数据传输。1 MiB 换算为行数,正好等于 0x4000 行。
最有可能的证据指向了芯片设计的一个常数边界:当预取环的行指针被设计为 14 位(即最大表示 0x4000)时,1 MiB 刚好完整走完预取环的一圈。控制代码中用于计算预取距离的公式 distance = end_ptr - rd_ptr,在模 0x4000 的溢出语义下,把一整圈的待传数据计算成了「没有距离」。
根据 credit(x) = min(x, 256) 的预取额度分配逻辑,距离为零意味着系统判定无需提前拉取任何数据。整个硬件预取管线在充沛的数据面前将自己直接饿死,原本设计精良的高速传输链路,退化成了每取一次数据都要停下来等下一个指令的串行慢路径。传输依然能完成、结果也正确,错的只是取数节奏:预取管线把自己饿住了。
朴素切分找回丢失算力
明确了指针回绕的机理后,相应的软件规避方案朴素得甚至显得有点滑稽:只需将 1 MiB 的单次内存传输操作,拆分为两次独立的 512 KiB 传输。
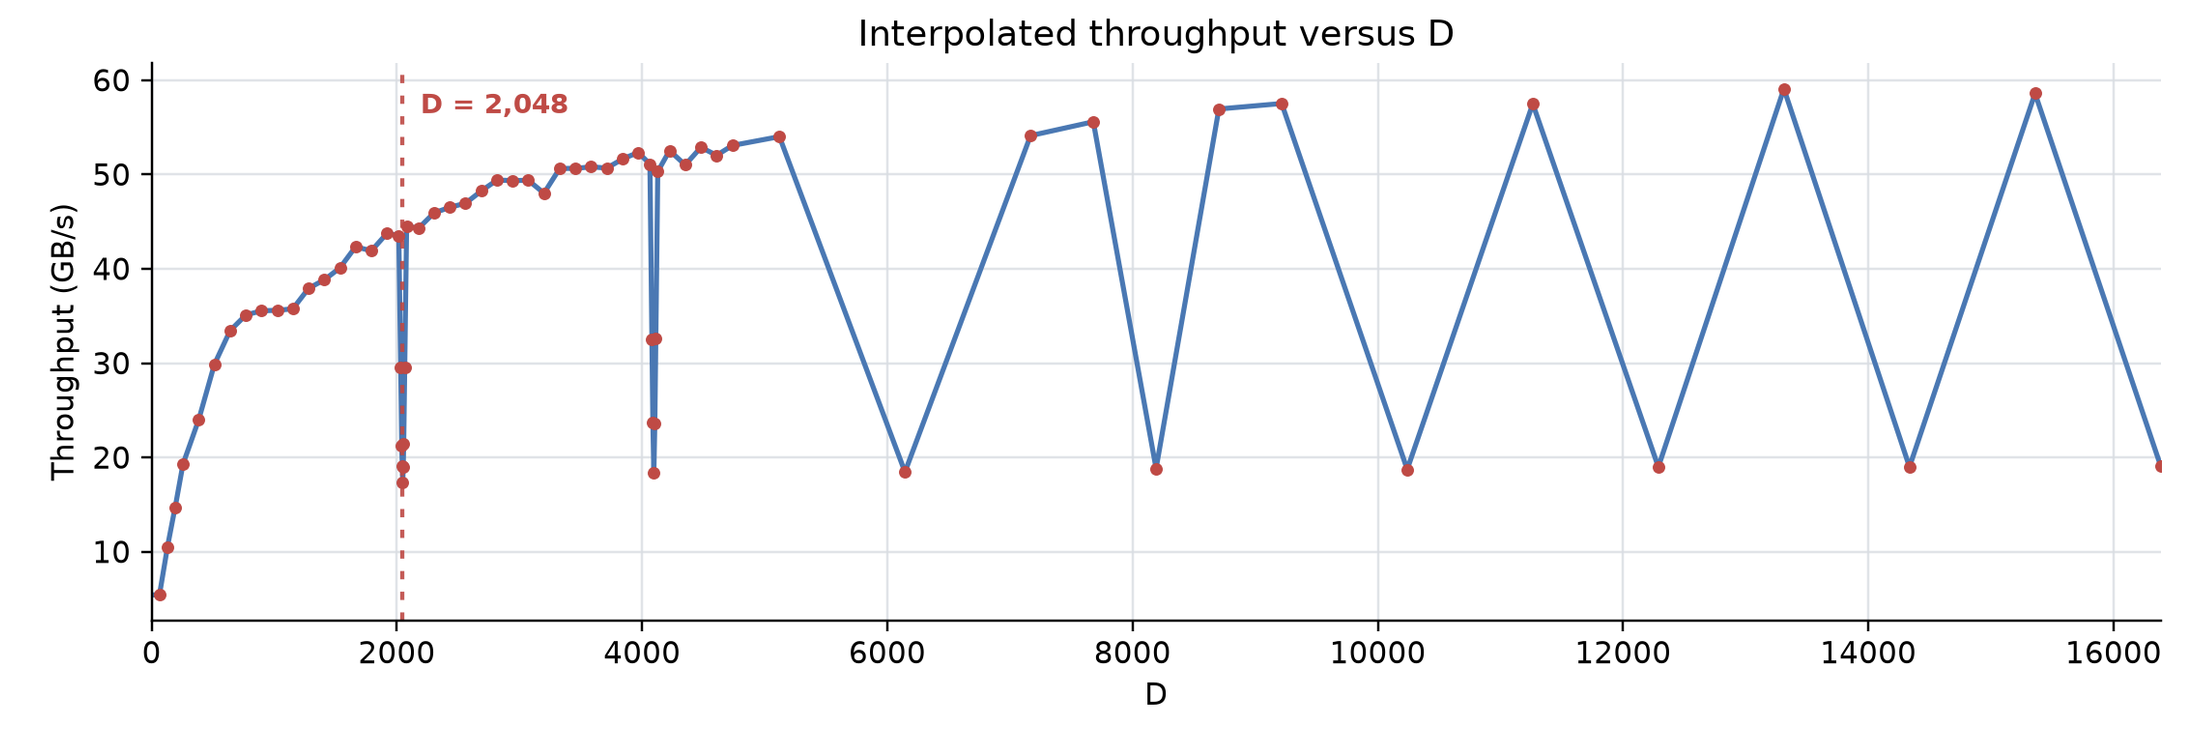 图:各 lap 曲线在凹口处的塌陷对比。来源:Eileen Yoon,eiln.github.io
拆分 0x4000 行的传输后,吞吐量立刻恢复到 45.52 GB/s,达到了原先的 2.66 倍。如果拆成四次 0x1000 行(256 KiB)的传输,吞吐量依然稳定在 44.83 GB/s。在 D=16384 的长序列场景下,吞吐量更是从谷底的 19.1 GB/s 直接暴涨 3.16 倍,达到了 60.5 GB/s。
作为对照测试,对原本就不处于 1 MiB 边界的数据(例如 1 MiB 减去 16 KiB)进行同样的切分操作,毫无加速效果。性能收益实打实来自于绕开了特定的寄存器溢出状态,而不是小尺寸传输在物理机制上具备天然优势。
七个主流模型踩中硬伤边界
这个 14 位寄存器漏洞直接波及了 ANEMLL 项目 15 个模型中的 7 个。踩中的包括 Llama 3.2 1B、Llama 3.1 8B、DeepSeek 以及 DeepHermes 8B 的 q、o 投影层,还有 Qwen3-8B 和 Gemma 3 4B 的相关分片。
部署拆分补丁后,真实业务场景下的收益可观。实测结果显示,Llama 3.2 1B 的推理速度从每秒 10.0 tokens 跃升到 24.3 tokens,对应的 DRAM 带宽占用从 24.7 GB/s 满血拉升到 60.0 GB/s。Qwen3-8B 也从原本不可用的 1.36 tokens/s 提升到勉强可用的 2.97 tokens/s,内存吞吐从 22.4 GB/s 翻倍至 48.7 GB/s。
软件层面的切分和规避,并不等同于从硅片层面修复了硬件问题。这种基于无风扇 M3 MacBook Air 的交错采样测试,在排除了热漂移干扰后给出了确凿结论:缺陷的根源依然驻留在那个 14 位的指针域里。
硬件勘误的代价,往往要等到有人把吞吐率画成频谱图才被看见。当最前沿的开源模型在端侧设备上遭遇莫名其妙的性能墙时,速度上限并不在复杂的模型架构或智能编译器里,而可能死死卡在一个 14 位寄存器的回绕语义上。顶级的端侧推理优化,依然是与底层硬件行为最原始的近身肉搏。
参考链接:
- Eileen Yoon 技术报告《Getting 50 GB/s Back Out of the ANE》
- ANEMLL 项目仓库
- Hacker News 讨论帖