异步运行时的性能瓶颈几乎从不在 Tokio 自身。问题绝大多数出在应用代码与调度器的交互方式上。开发者习惯将异步调度视为免费的系统福利。但在高性能场景下,公平性和批处理是一组必须显式支付的权衡。业务需要用让出执行权换取低延迟,或是用批量处理换取高吞吐。真正会一次性拖垮整个运行时的,是应用代码滥用互斥锁和阻塞池这类全局资源。
轮询指的是两个 .await 之间不交还运行时的执行代码。Alice Ryhl 在《What is Blocking?》一文中建议将这段时间控制在 10 到 100 微秒。在这个时间窗口内,工作窃取机制可以平滑地重新分配任务。但原作者观察发现,几乎每个真实应用的轮询时间都远超这个数字。最能暴露问题的是新增的调度延迟直方图指标。它记录了任务就绪到真正被执行的时间差。数据表明,绝大多数拥堵发生在分布式系统多组件的边缘,而非核心的异步循环。
贪婪读取会饿死连接,交出控制权换取低延迟
网络协议的拆包处理容易造成性能阻塞。Redis 风格的管道处理有一个典型的朴素实现。它会在接收缓冲区内连续读到多条准备就绪状态。只要缓冲区有数据,程序就会循环处理,根本不向运行时返回。这种贪婪的处理方式导致当前任务霸占工作线程。排在同一线程上的其他连接会被饿死。它们的请求被无限期推迟。
在每处理一条请求后显式插入 yield_now() 能缓解拥堵。测试数据显示,增加代码后该场景的延迟下降了约 10 倍。更好的做法是寻找平衡。开发者可以在连续 4 次无阻塞读取后再强行交出控制权。这兼顾了数据流的吞吐和多个连接之间的公平性。它把调度成本显式摆在了台面上。
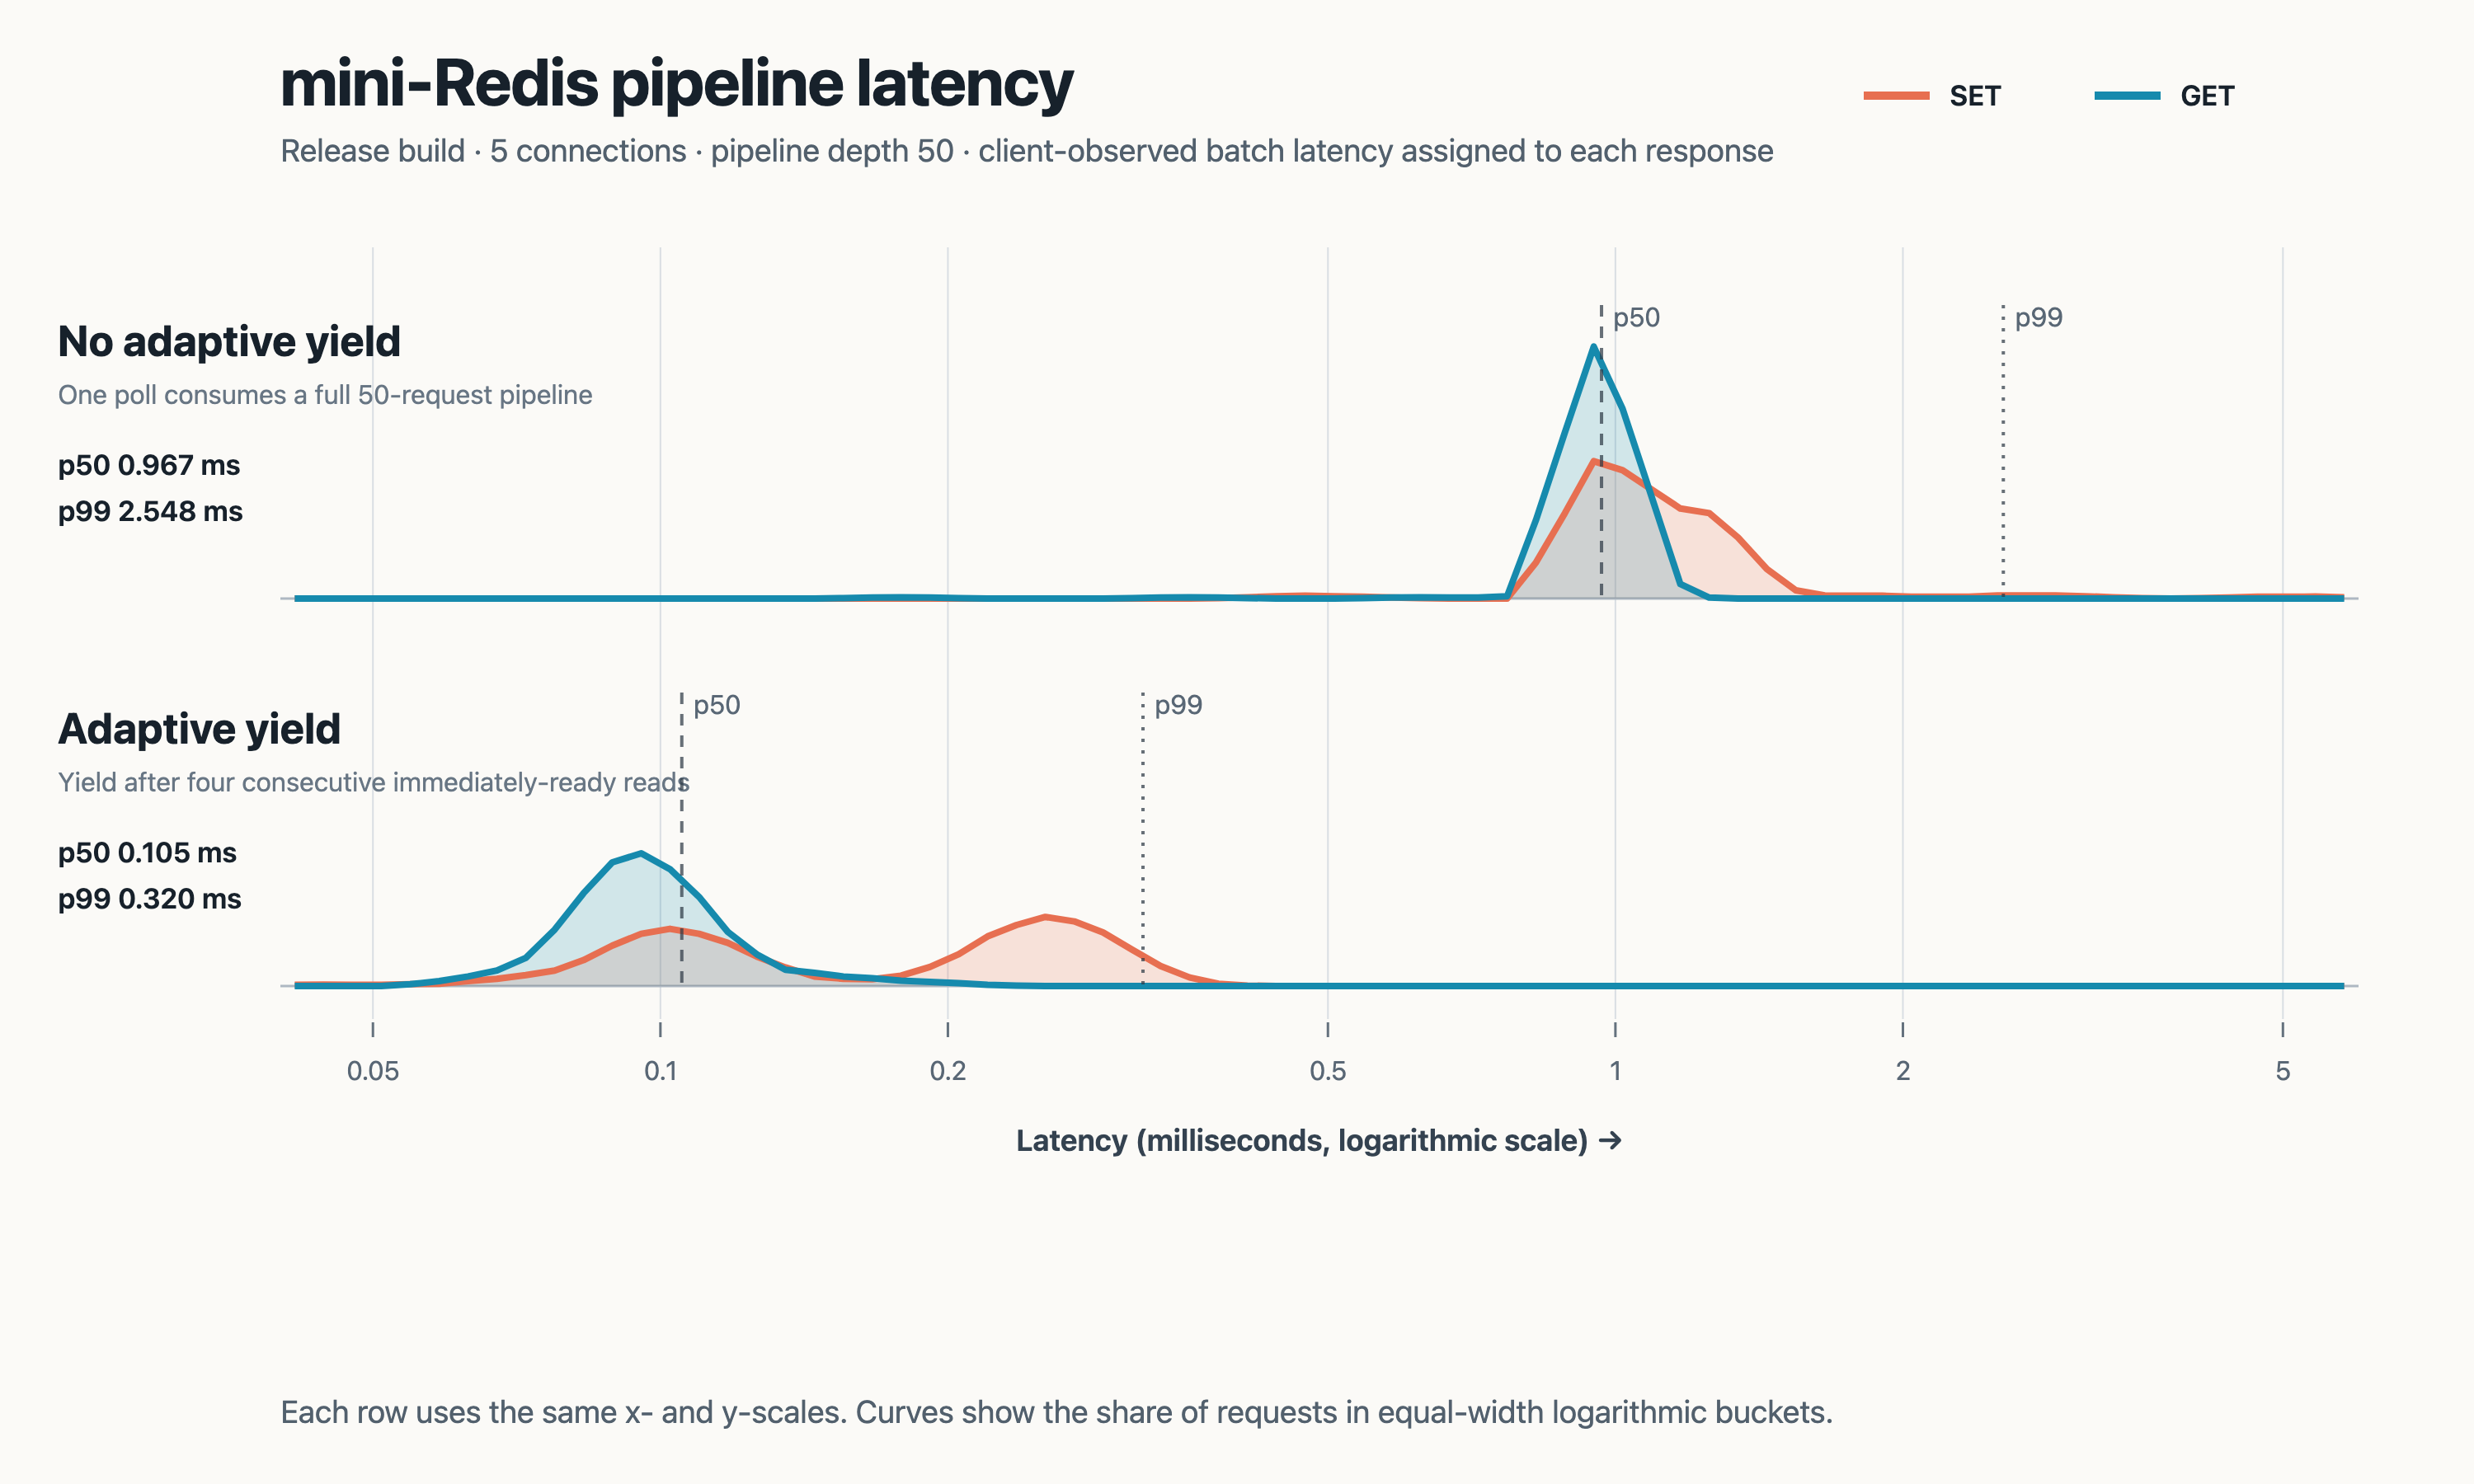 图:mini-redis 延迟分布:显式 yield 前后对比。来源:dial9
工作细碎化同样成本高昂。把一个仅需 10 微秒的工作抛弃成独立任务,上下文切换的开销远大于并发收益。这种过度拆分往往让调度器不堪重负。开发者最常见的翻车是扇出无上限的并发任务。比如一次扇出就打开 3000 个云存储连接。用简单的信号量限制并发通常就能解决问题。
文件操作打爆阻塞池,五万并发压垮全局资源
在缺乏 io_uring 支持的系统上,异步文件操作有隐藏代价。每次文件操作都必须走传统的阻塞池。spawn_blocking 派生系统线程本身有开销。原作者直言 tokio::fs 的独立调用往往是有害的。每次微小的读写都要付出同步成本。已知会做一串连续文件操作时,应该把它们合并成一个大的阻塞块。在部分密集的系统调用场景中,放弃异步调度并改用独占的操作系统线程反而跑得更快。
阻塞池目前是全局的系统资源。在 32 核主机上,大约每秒发生 50,000 个阻塞任务就会产生负面效果。Tokio 1.52.0 曾短暂上线分片阻塞队列。随后 1.52.1 版本发现可能导致挂起的回归问题并将其回滚。直到 PR #8337 合并后,分片队列才作为默认关闭的不稳定特性重新落地。
全局任务队列同样需要警惕。只有当本地队列溢出或外部调度工作时,任务才会落到这里。健康应用里该队列应当接近空状态。
互斥锁摧毁窃取机制,读写并发加剧底层争用
卡住一个工作线程最快的方法是在互斥锁上阻塞。像指标注册表这样挂载在读写锁背后的结构藏着风险。一次耗时的刷新操作持有锁之后,所有工作线程最终都会排队等待。因为线程被卡在底层的锁机制上,工作窃取机制随之失效。解决之道是保持临界区极短。比如仅仅更新一次哈希表。开发者不要在持锁期间执行读写或等待。
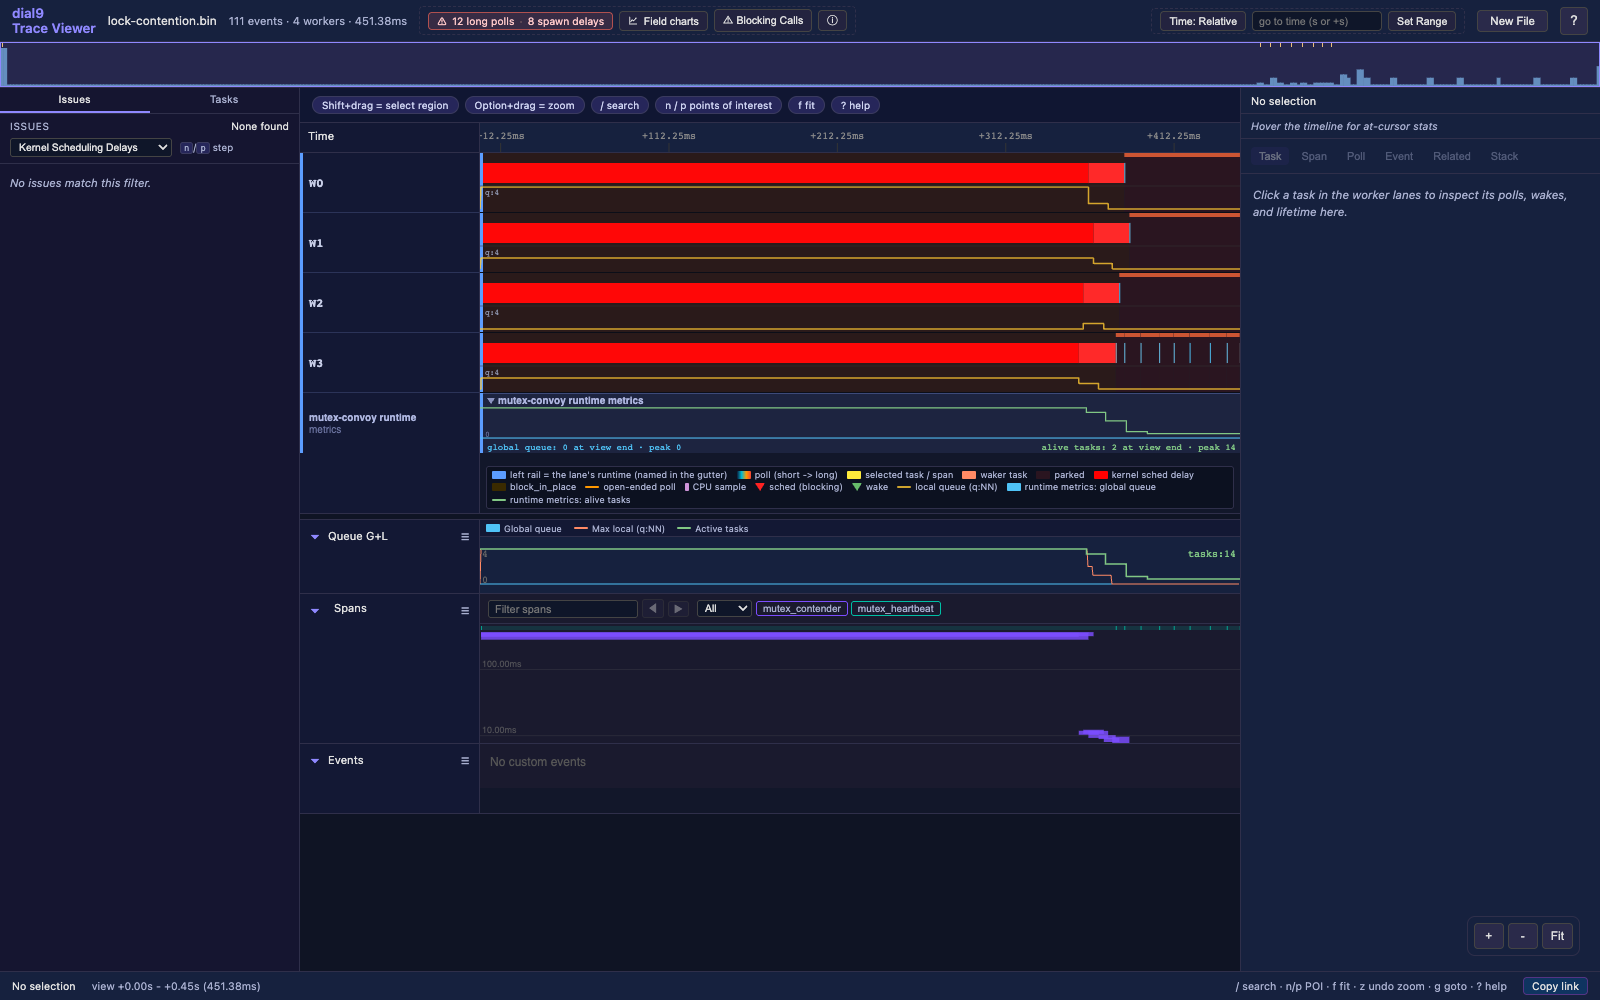 图:一把被争用的 mutex 让多个 worker 同时停摆的 trace。来源:dial9
读写锁几乎永远不是正确选择。读路径会在原子变量上引发争用,这在多核机器上同样昂贵。异步锁 tokio::sync::Mutex 只适合临界区长达毫秒级的场景。它不仅自身开销更大,还带来 Future 锁死的新问题。这是用一个问题换取另一个问题。
并发原语滥用也会导致阻塞。tokio::join! 和 tokio::select! 属于任务内并发。它们没有工作窃取机制的保护。在任务内阻塞就是真正的阻塞。这会以意外超时的形式在监控面板上表现出来。长轮询在轻负载下能被窃取机制吸收。但在运行时高负载或操作系统高负载情况下,长轮询会直接失效,导致大量任务被堆积。
内核调度引发随机抖动,绑定双核心成为标配
内核调度延迟会带来无法预测的抖动。在系统高负载时,内核可能延迟 10 到 20 毫秒才调度被唤醒的线程。原作者在亚马逊迁移 Java 到 Rust 时观察到反直觉现象。同驻一台机器的 Java 进程做的工作越少,Rust 进程跑得越快。
利用控制组把工作线程和其他代码钉在不同物理核心上,是抵御抖动的有效防守。后台日志写入程序有时会连续 100 毫秒霸占处理器。这会严重拖慢其他线程的唤醒。按优先级拆分多个运行时并绑定核心是一条出路。多数 TokioConf 演讲者得出结论,高并发应用最终至少需要两个运行时。
音频流处理中每 20 毫秒处理一次音频帧。系统重试机制不够用。程序必须每次手动排空累积的整帧数据。针对微秒级延迟场景,开发者可以故意自旋 50 微秒。代价是占据核心并影响相邻进程。
社区争论指向架构重构,锁和通道没有标准答案
这篇文章在 Hacker News 上引发讨论。争论从调度器调优转向架构设计。saghm 指出,半数以上的互斥锁瓶颈本该用通道或所有权转移解决。原作者回复会将此补充进文章。eru 对比了不同语言的通道实现。Erlang 发消息实质是复制字节,Go 在通道上传递的是共享可变对象。通道本身并不能解决所有架构设计问题。SwtCyber 总结,把状态所有权交给单个任务并通过通道通信,锁会自动消失。
技术选型分歧更加底层。dist1ll 提议引入专用网卡驱动榨干硬件性能。kev009 反驳称这属于轮询模式专用快路径,不适合通用构件。5ersi 主张高性能必须依赖忙轮询和环形缓冲。VorpalWay 认为该观点过于狭隘。高性能在嵌入式系统和交互式开发工具里的含义截然不同。
工程环境里没有放之四海而皆准的参数模板。将调度公平性视为可消耗资源,是写出高性能代码的前提。开发者需要理解代码背后的调度代价。真正的瓶颈始终在于应用层粗暴的独占逻辑。互斥锁和全局资源的滥用,永远比运行时的固有开销更致命。
参考链接:
- dial9: Principles for Fast Tokio Applications
- Hacker News 讨论