2026 年 9 月,逆向工程社区 Opcode Collective 拆解了 Intel 8087 浮点协处理器中一条冷门指令的完整执行流。FSCALE 指令负责把浮点数乘以 2 的 N 次方。从直觉上看,这仅仅是一个给浮点数指数部分加上某个整数的简单动作。但在 8087 的 3.3 KB 微码 ROM 里,这条指令足足消耗了超过 140 条微指令,甚至需要调用三层子程序。
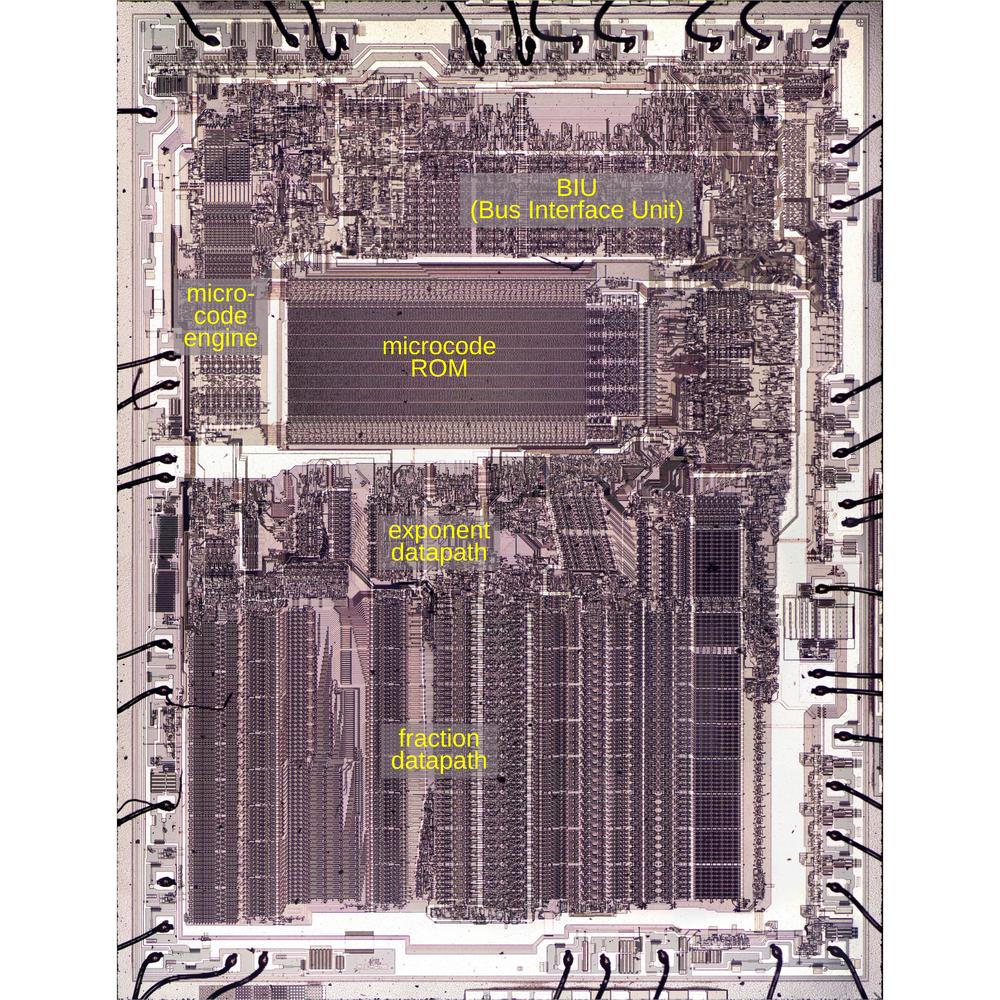 图:8087 裸片标注图,5mm × 6mm,中央是存放 1648 条微指令的微码 ROM。来源:Ken Shirriff,righto.com
1970 年代的浮点运算环境处于一片混乱之中。市面上充斥着十几套互不兼容的算术标准,大多数浮点实现围绕「硬件简单」而不是「数学严谨」进行设计,导致了严重的数值稳定性问题。8087 协处理器由数值分析专家 William Kahan 参与设计,其核心目标是即使在边角情形下也尽可能保持准确计算。这款芯片能装进 IBM PC,将电子表格到 CAD 的浮点运算速度提升最多 100 倍。今天被当成常识的浮点边界行为,并非单纯从抽象的数学推导而来。1980 年的那颗 5mm × 6mm 裸片里藏着无数次取舍,如今的 IEEE 754 标准不过是当年这些工程实现决定的直接集合体。
返回0比返回NaN少写逻辑
FSCALE 的微码执行路径非常繁复。微码起始于十进制地址 748。即使在没有遇到任何特殊值的最普通路径中,执行这套逻辑也需要走过约 22 条微指令。微码引擎首先把操作数从栈顶 st(0) 移动到临时寄存器 tmpA,并检查它是否为零。如果是零,系统会直接返回结果,造就了「0 乘以任何数都得 0」的底层基础。接着微码把第二个参数移到临时寄存器 tmpB,同样为零就直接返回,保证了「任何数乘以 0 保持不变」的逻辑。
随后的计算动用了底层的指数常量 ROM 和加法器。程序会读取常量 0x403e,这个数值来自指数偏置 16383。把浮点数转成整数需要右移 63 − (exp − 16383) = 0x403e − exp 位。加法器完成减法后,桶形移位器完成对应的移位操作,接着在 B 寄存器里得到整数形式的缩放量。最后加法器把 B 寄存器的值加到 tmpA 的指数上,并送入指数转换器检查是否发生溢出或者下溢,再写回 st(0)。
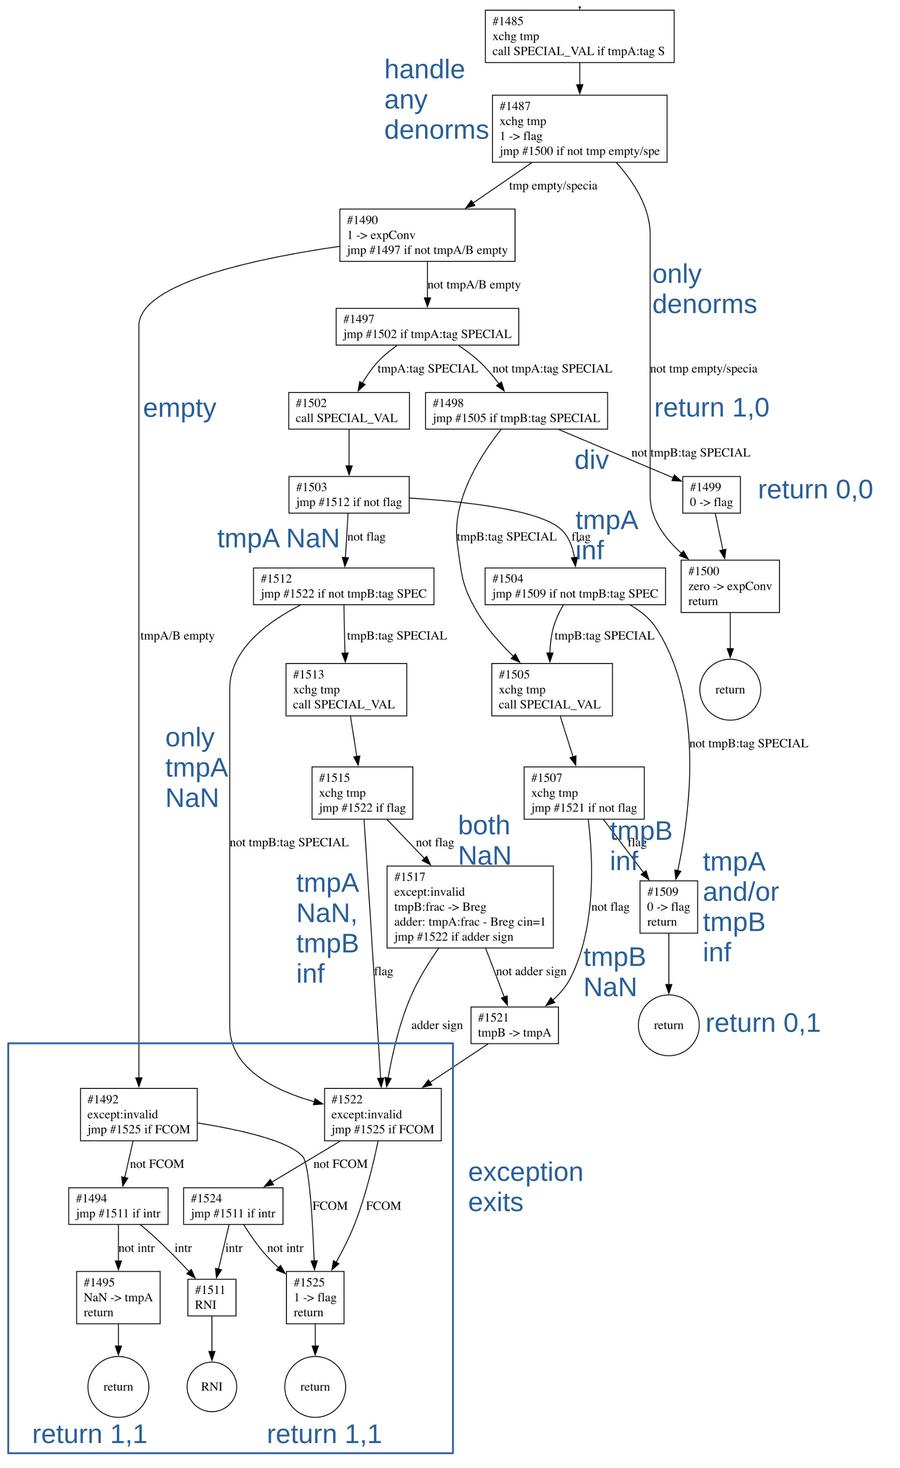 图:FSCALE 微码的控制流。来源:Ken Shirriff,righto.com
矛盾点出现在边界数值处理上。当测试 FSCALE(0, ∞) 时,8087 直接返回了 0。按照 8087 自己的规范,0×∞ 应当返回 NaN。一致性原则要求 0×2^∞ 同样返回 NaN,但硬件实现并没有这么做。作者 Ken Shirriff 的判断是,设计者在这里走了捷径,没有去追求数学意义上绝对正确的值。在面对冷门指令时,少写几行判断逻辑并省下一点 ROM 空间,比强行维护边缘情况的数学一致性更为现实。 其它算术指令在处理非规格化数和零值上的行为都有清晰文档,唯独 FSCALE 的异常情形被 Intel 漏掉了,这种疏忽本身就是工程妥协的直接证据。
16KB软件仿真敌不过3.3KB微码
处理浮点运算的真正成本,永远藏在那些边缘状态的特殊判断里。特殊值的处理由专门的 SPECIAL_TMPS 子程序负责。它不仅要把遇到的非规格化数(denorm)转回规格化数(unnorm),还要实时检查是否访问了空栈位置。一旦发生栈下溢或者上溢,程序就会立刻触发硬件级别的异常或者中断。随后程序会重新检查两个参数,只要任一参数为 NaN 就会引发异常。
在处理 NaN 时,8087 展示了一项反直觉的设计。当两个 NaN 同时参与运算时,8087 会通过地址 #1518 处的减法逻辑比较它们,并主动返回数值「较大」的那个。这项带有明确文档记载的特性赋予了 NaN 更多调试语义,程序员能够利用不同数值的 NaN 来标记计算链路中具体出错的位置。
溢出与舍入的处理则更加繁重。当出现下溢时,CREATE_DENORM 子程序必须通过反复移位操作造出一个非规格化数。结果精度由 ADJUST_PRECISION 子程序根据控制字里的设定进行干预。不论是 23 位的 short real 还是 52 位的 long real,微码都需要先左移产生舍入位,再右移截短,并在必要时额外加一进行舍入,最后左移对正。如果舍入进位不幸导致了溢出,微码只能返回无穷大。
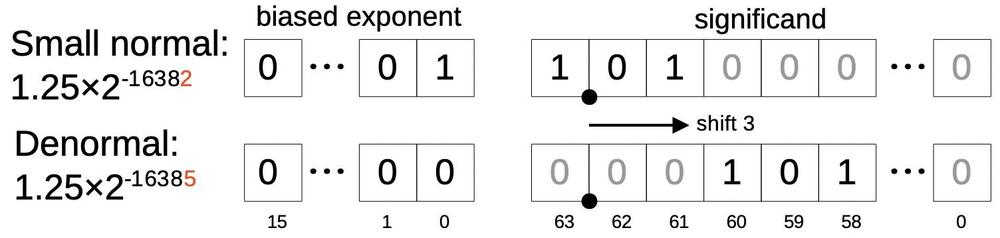 图:从规格化数生成 denorm 的过程。来源:Ken Shirriff,righto.com
当年 Intel 为没有购买 8087 硬件的用户提供过一套软件仿真库,用于模拟协处理器的全部指令。这套纯软件仿真器需要占用整整 16 KB 的 8086 代码空间。要知道在 1980 年,一个完整的 BASIC 解释器也才不过占用 8 KB 存储。8087 仅仅依靠 3.3 KB 的物理微码,就包揽了软件层面需要多耗费几倍体积才能处理的边界检查。同一批边角情形,软件要花 16 KB,硬件用 3.3 KB 微码就压住了。
有些行为过了7年才写进手册
硬件实现不仅决定了标准的形态,还在无意中留下了持久的历史包袱。在 FSCALE 的执行流末端,隐藏着一个带有「round up」条件的底层跳转指令。这个跳转动作带有一个未公开的副作用:它会更新程序员可见的条件码寄存器 CC1。该寄存器本用于记录运算结果究竟是被向上还是向下舍入,但对于 FSCALE 的这一操作,1980 年版的 8087 官方手册只字未提。
直到 1987 年推出的 387SX 处理器问世,Intel 才在时隔七年后把这个条件码动作正式补进了官方文档。标准从来都不是天上掉下来的真理。一些工程决定顺理成章地被写进了 IEEE 754 规范成为行业基石,而另一些副作用则被遗忘在硅片内部,直到数年后才给予合法地位。
浮点体系里的每一条边界逻辑,背后都有人替开发者做过物理层面的取舍。FSCALE 指令用 140 条微指令向我们展示了早期计算机先驱的艰难选择。3.3 KB 微码在处理常数加法时展现出的繁复度,本身就是前沿计算标准游戏规则的缩影。技术规范是工程师在晶体管预算、执行效率和数学正确性之间反复博弈出来的产物。
参考链接:
- Ken Shirriff《Microcode in Intel’s 8087 floating-point chip: the scale instruction》
- Intel Numerics Supplement
- 8087微码逆向工程仓库