在一次公路旅行中,三位乘客用恩德贝莱语、卡兰加语、葡萄牙语和恩道语轮流向手机讲话,中途无缝切到德语时,手机另一头的 AI 没有丢失任何话题线索。遇到绍纳语方言的细微差别时,它甚至会主动表达不确定并请求澄清,并且在被要求说那些无法掌握的方言时,会礼貌地说明自己做不到。这是社区里有用户反映的 Gemini 3.8 Live 真实体验。
在支持 97 种语言无缝切换的背后,Google 官方博客宣布发布两个面向实时语音对话的新模型。这两个模型定位存在显著差异:Gemini 3.8 Live 面向规模与成本效率,把对话智能与视觉接地结合;而 Gemini 3.8 Live Extended Thinking 面向高复杂度任务,强调多步推理能力。这也是 Google 在语音交互领域给出的最新工程答案。
让模型边想边说,延迟预算被重定义
语音 agent 过去卡在先想完再说的串行结构里,一旦任务的推理耗时稍长,就会触发用户的打断或放弃。Gemini 3.8 Live Extended Thinking 把推理和发声这两步操作并行了起来。在后台执行 API 调用或长程推理时,它会先抛出「Let me check that」这类早期口头线索,自然占住当前的对话轮次。
交互的延迟规则变了。在加入对多步后台任务的实时进度旁白后,语音交互的延迟预算从必须小于人类耐心,变成了只要能交代清楚正在做什么,推理进程就可以在后台从容运行。官方演示的餐厅预订场景里,模型可以一边与客户自然闲聊,一边在后台异步协调时段与桌位,保持整个对话毫不中断。除了这些基础交互,它还能通过自然语音现场生成完整的商业计划与营销工具包。
82.6分背后,复杂工作流跑进 Pareto 前沿
根据 Google 官方博客公布的数据,Gemini 3.8 Live Extended Thinking 在 Artificial Analysis 的 Speech to Speech Quality Index 中拿到整体第一的 82.6 分。在 Big Bench Audio 推理测试中,它取得了 97.7% 的成绩。在评估 agent 任务完成度的指标上,它在 τ-Voice 取得 68.6%,在 Sierra 的 τ-Voice-banking 取得 35.1%。基础语音模型跳出了简单的日常闲聊,已经具备切入企业级复杂业务场景的工程底盘。
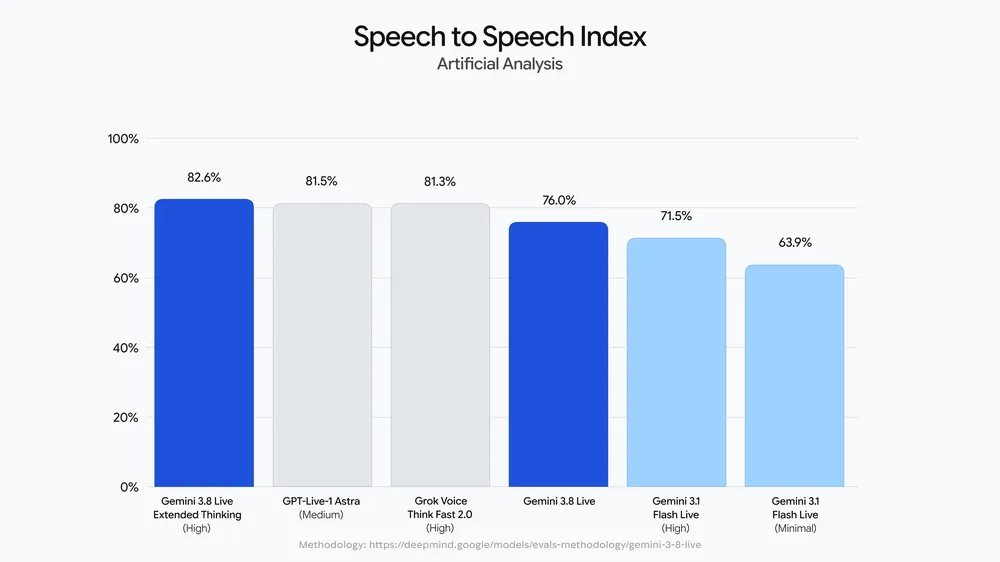 图:Artificial Analysis Speech to Speech 指数。来源:Google 官方博客
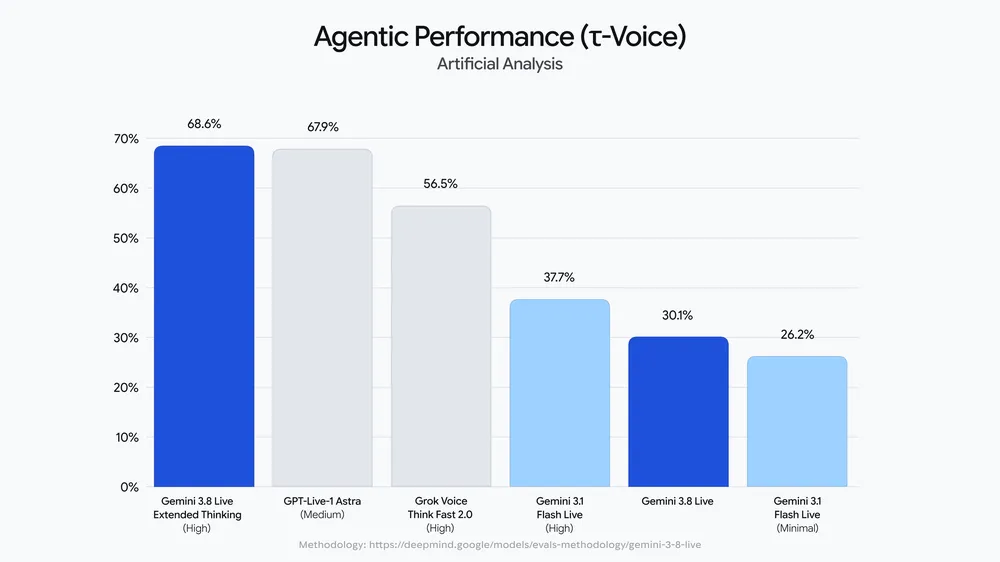 图:Artificial Analysis agentic 性能对比。来源:Google 官方博客
在 ServiceNow 提供的 EVA-Bench 评估中,官方指出这两个新模型推动了复杂工作流的 Pareto 前沿。企业客户能在近实时处理视觉输入的同时协调多项异步任务,从感知到执行的链路被一次打通。官方演示里已经出现这类用法:把手绘草图与近实时的语音反馈直接转变成可用的 React 组件,以及在员工 onboarding 场景中实时用视觉上下文回答提问。
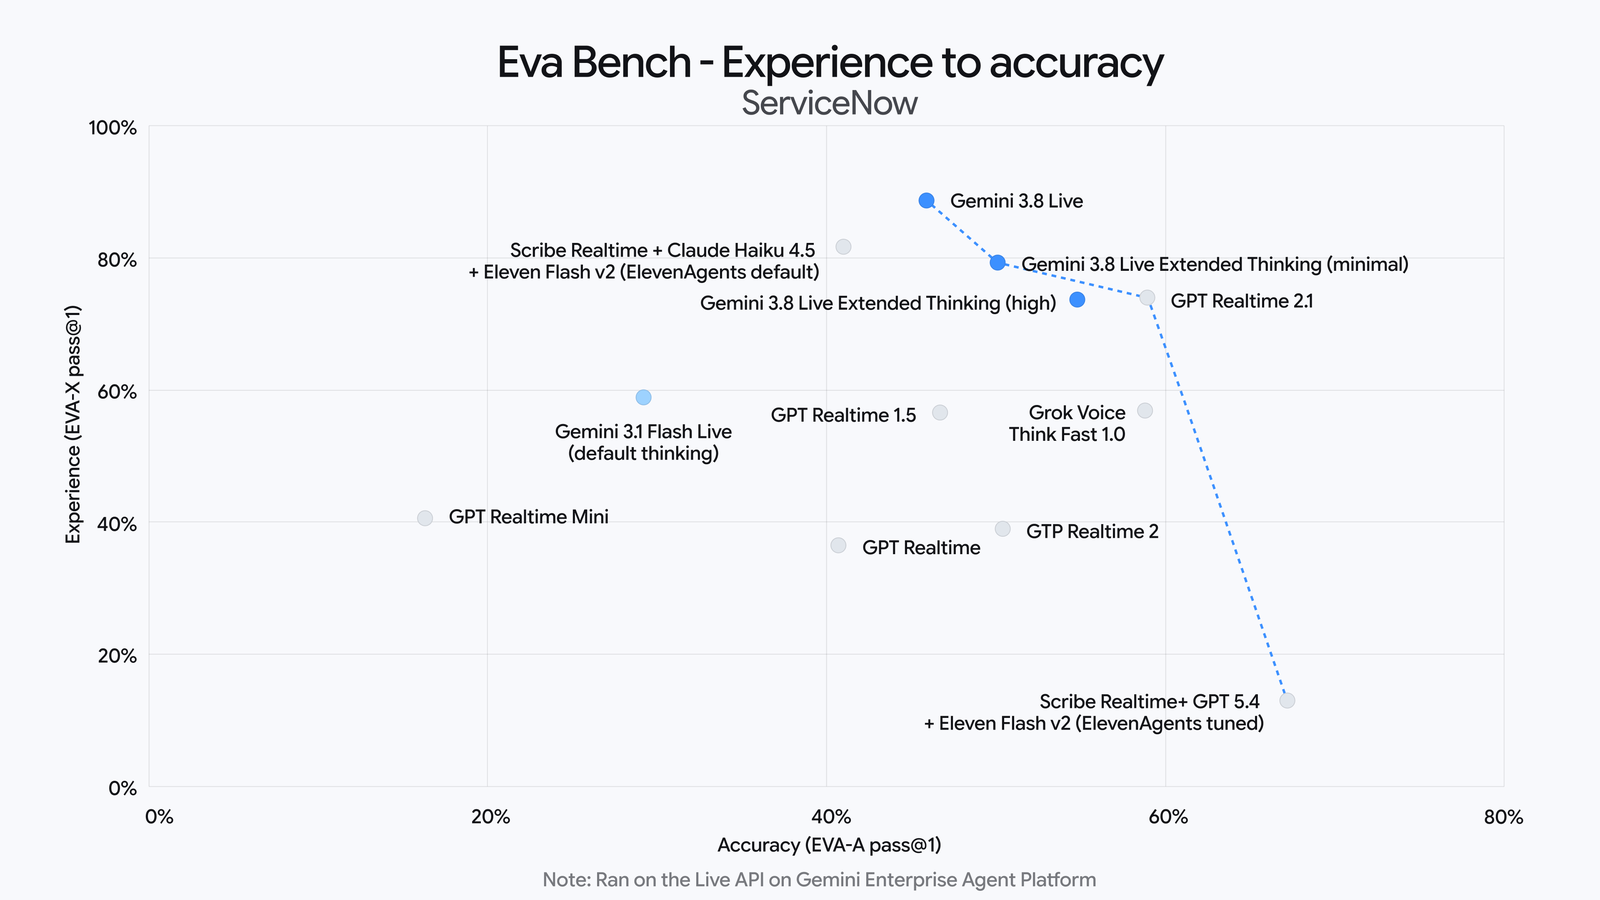 图:ServiceNow EVA-Bench「体验 × 任务完成度」Pareto 曲线。来源:Google 官方博客
推送至 3 大端点,分发渠道全面铺开
模型在研发层面的突破,最终要靠工程落地的覆盖面来兑现。在这波更新中,新模型的能力被迅速分发到了三大关键渠道。面向开发者,Gemini API 与 Google AI Studio 已经全量接入 Live API。面向企业端,Gemini Enterprise 开启了私有预览,针对客户体验的专属版本也即将上线,而 Extended Thinking 能力则被直接推向 Google Workspace,服务于更高阶的商业客户。
面向普通用户,部署版图同样庞大。除了 Search Live 和基础的 Gemini app,Extended Thinking 被深度整合到了用户最高频的工作流里:在 Docs 里它面向 Google AI Pro 和 Ultra 订阅者开放,而在 Gmail 和 Keep 中则覆盖了所有级别的订阅用户。这套多管齐下的分发策略,让语音模型的接触面扩大到了常规的工作生态中。
社区争议不在模型,在工程落地质量
围绕模型本身的体验,社区里有用户反映 Gemini 和其他付费前沿模型存在明显差距。反驳方的用户则表示,付费版 Gemini 是非编程任务的首选,他们更看重其响应速度,倾向于把复杂的软件架构与规划留给 Claude。这场争议呈现了两极分化的用户习惯,不同前沿模型在不同场景的优势已经被切分得越来越细。在 Speech Agent Arena 的用户偏好盲测中,Gemini 3.8 Live 依然排在了第二位。部分表现不佳的印象,源于有些用户把免费模型的表现等同于整体水位。
相比于模型层面的分歧,批评更多集中在终端的集成质量上。比如在 Android Auto 里语音导航到某家超市时,系统会导向 10 公里外的另一家门店。App Connector 在 Google 自家生态外的表现也常常受限,无法稳定工作。模型在跑分测试里的成绩再高,只要落地的工程集成存在缝隙,用户感受到的就是整个工作流的中断。
方言切换构成比跑分更直观的壁垒
多语言能力是这次发布中被频繁提及的生活方式级体验,它甚至被视为一种新型的教育场景。除了前文提到的多语种混说,有住在国外的用户用它作为日常口语与即兴语法课的语伴,家人听到它讲南非荷兰语时大为惊讶。有家长对比后指出,用了几年 Duolingo 仍没法真正开口说,它更像一款成瘾性的游戏,而拥有加泰罗尼亚语哄睡级别能力的语音模型才是有效的语言训练。
此外,社区里的方法论探讨也揭示了一个重要现象。有评论者指出,同一批模型在切换语言后的行为差异,往往大到像换了一个全新的模型。当基准测试的语言偏差逐渐被社区重视时,小语种的细微方言识别能力,成了检验模型泛化水平的一把真实尺子。
Gemini 3.8 Live 把发声和推理并行的设计,本质上是一种绕过算力延迟瓶颈的工程解法。它放弃了对单次生成速度的执念,直接用并发机制和占位反馈,化解了人类在对话中的等待焦虑。只要模型能在开口前想好第一步,多步任务的漫长执行过程就能被藏进自然聊天的缝隙里。
参考链接:
- Google 官方博客
- Hacker News 社区讨论