2026年9月,官方工具链终结内核语言断层
2026年9月8日,NVIDIA 通过开发者博客正式引入 CUDA Rust,提供 cuda-oxide 和 cutile-rs 两条原生编译到 PTX 的开发轨道。在这之前,虽然 Nova Linux 驱动和 NVTX 等基础设施已经大规模切向 Rust,但最核心的 kernel 层依然需要借助 C++ 编写。补齐这最后一块拼图后,开发者可以直接在宿主环境里完成端到端的 GPU 逻辑构建。
AI 系统的底层设施正经历一场不可逆的语言迁移,推理引擎、驱动和系统运行时都在向 Rust 靠拢。CUDA Python 和 CUDA C++ 已经是成熟的企业级工具,但它们无法在编译阶段提供内存安全的强保证。NVIDIA 将 CUDA Rust 的演进路线规划到了 2027 年及更远,官方不再只做技术探索,而是为下一代算力基础设施准备备用引擎。
过去要启动一个 kernel,往往是对外部二进制文件的包装调用,宿主程序对设备端发生的内存问题一无所知。CUDA Rust 直接介入了 PTX 的生成流程,通过社区 Pliron IR 框架拦截并转换代码逻辑。将设备代码与宿主代码放在同一个语法检查器下,彻底消除了跨语言交互时的黑盒状态。
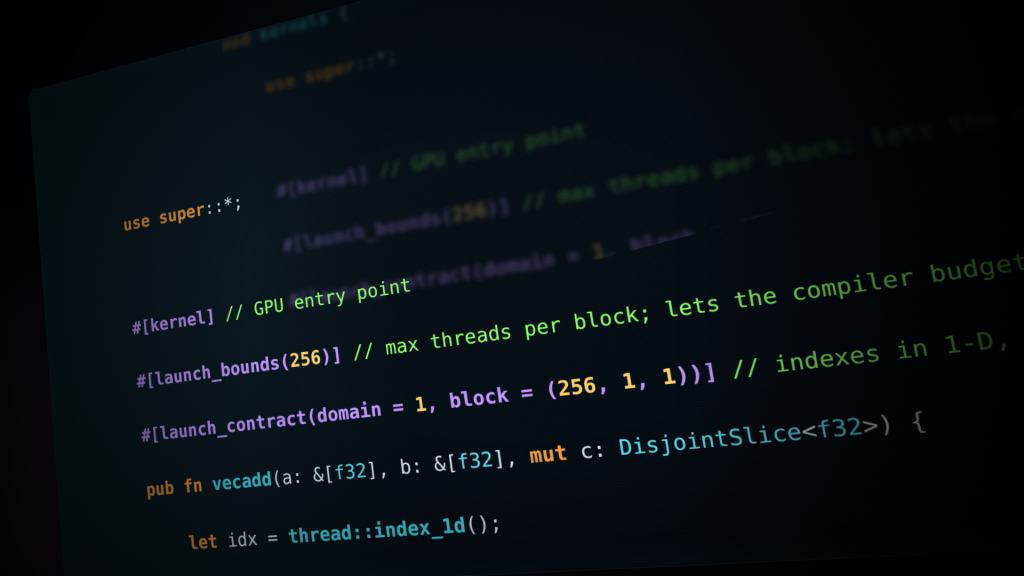 图:官方博客正文插图,SIMT 轨道 vecadd kernel 的签名与 launch 属性特写。来源:NVIDIA 开发者博客
借用检查器接管 1024 个并发线程
在官方提供的一个 1024 元素逐元素加法测试中,两条轨道的 kernel 都成功输出了全对的结果,但背后的安全论证逻辑发生了根本转变。SIMT 轨道没有使用常规的 &mut [f32] 引用,因为数百个线程同时请求可变借用会直接被编译器拒绝。开发团队引入 DisjointSlice<f32> 将一份大借用安全切割成每线程独占的内存块。编译器在编译期拦截了多线程数据别名错误,程序员不需要在运行期处理内存崩溃。
传统的 CUDA 越界访问往往会导致静默错误或者迟来的程序崩溃,排查成本极高。在 cuda-oxide 中,thread::index_1d() 返回的是一个强类型索引而不是普通整数。读取数据时,c.get_mut(idx) 会强制返回一个 Option 类型。越界处理变成了代码层面的一个显式分支逻辑,开发者必须在敲击键盘时处理好边界条件。
NVIDIA 同样将 kernel 的启动配置纳入了类型系统的监管之下。#[launch_contract] 声明将一维索引和 256 线程块的规格固化下来,宿主代码比对设备的实时限制并颁发启动凭证。没有凭证的裸启动会暴露为 unsafe 操作,运行时环境拒绝信任不受约束的参数输入。如果一个内核试图把自己的输出缓冲当作输入,语法检查器会精准抛出对象正在被借用的底层错误。
放弃线程控制权换取零开销抽象
相比于紧贴底层的 SIMT 轨道,Tile 轨道提供了一种更高层的抽象策略。cutile-rs 让每个 tile block 作为单个逻辑线程运行在一个子张量上,剥离了底层的线程分配细节。宿主机对数据执行 partition 操作后,交出去的是物理隔离的张量块。不同 tile 之间没有访问重叠,可变引用的独占性在架构层面自然成立,开发者不再需要手动管理复杂的并发锁机制。
这种高层抽象带来了显著的工程红利,仅需单行代码调用就能同时完成网格尺寸计算、张量独占划分并提取计算参数。输入的张量形状中可以使用 -1 作为维度哨兵,真实尺寸留到启动时才从数据里动态读取。内核不需要因为输入尺寸的改变而重新编译,静态安全机制下依然保留了动态运行的弹性。
Tile 轨道也付出了失去精细硬件控制力的代价。编译器独占了共享内存和线程索引,开发者无法像在 SIMT 中那样实施极限的寄存器级优化。目前 SIMT 轨道保留了对共享内存的控制权,但必须使用 unsafe 代码块来绕过安全检查。追求绝对安全就得让渡硬件控制权,这是所有内存安全语言在接触底层开发时必须面对的工程取舍。
所有的计算任务在调用 .sync_on(&stream) 之前都处于惰性状态。程序的构建、张量的分配以及内核的启动被串联成一条执行单链,只在最后保留唯一的同步点。这种惰性求值模式大幅度减少了 CPU 与 GPU 之间握手带来的延迟消耗。
生产可用前仍有工具链锁链要挣脱
目前两条轨道都处于早期测试阶段,距离真实的生产环境可用还有很长的路要走。SIMT 轨道不仅要求特定版本的 libclang 工具链,还被死死绑在了 nightly 编译版本上。深入编译后端的系统改造超出了标准编译器的支持范围,高度定制化的编译环境拉高了这项技术的接纳门槛。
走在更前面的 Tile 轨道则展现出了优异的生态兼容性。cutile-rs 只需要 stable Rust 1.89,并且已经作为标准依赖发布在了 crates.io 仓库。HuggingFace 的 Grout 推理引擎和 mistral.rs 已经开始在业务项目中尝试接入。不依赖自定义后端让它避开了工具链绑定的困境,也赢得了第一批试水的核心用户。
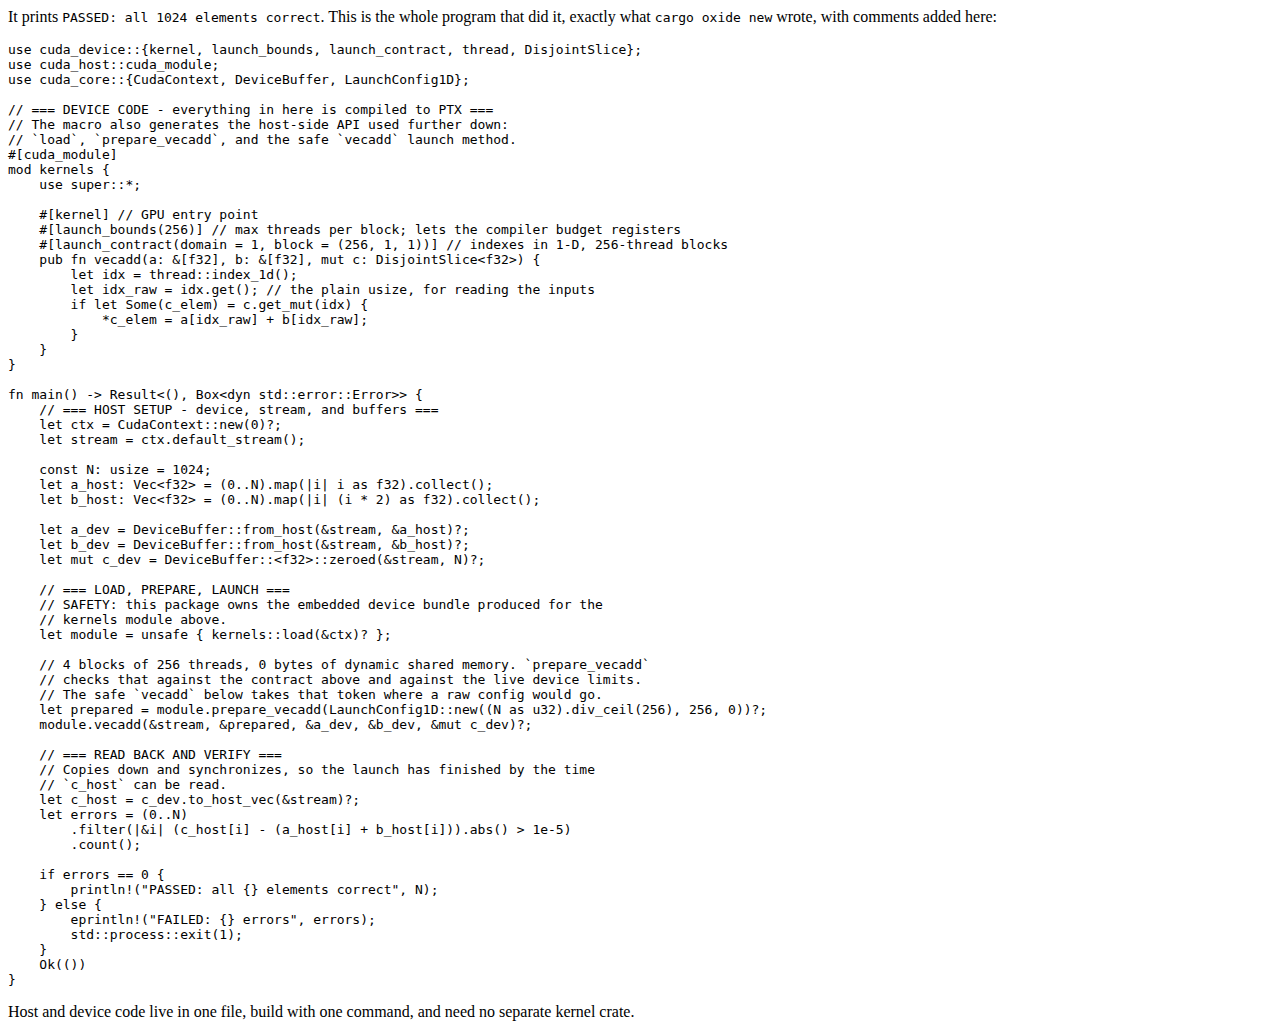 图:官方博客中 cuda-oxide 的完整 vecadd 程序,host 与 device 代码同处一个文件。来源:NVIDIA 开发者博客
NVIDIA 并没有试图用官方封闭方案一统天下,在代码库里不仅使用了开源框架,还致谢了 rust-cuda 和 rust-gpu 等社区先行者。该 GitHub 仓库在短短数月内积累了 3.4k star 和过千次代码提交。官方技术栈与开源社区的协同并进,远比单纯抛出一个闭源工具更容易催生出健壮的系统生态。
社区争论撕开 DSL 与底层语言路线分歧
这项技术在 Hacker News 上引发了激烈讨论,焦点直指 GPU 编程范式的发展方向。反方认为内核根本不需要用底层语言重写,高层次的 DSL 已经能够很好地抽象分块尺寸,继续在底层语言上做文章属于方向性跑偏。正方则站在工程实用角度反驳,指出原生编译器让宿主程序和设备端共享了结构体定义,直接切断了多语言维护下的数据状态不同步隐患。
多重编译栈叠加带来的排错成本是社区普遍担忧的隐患。开发者警告,一旦内核在运行中发生崩溃,工程师将很难分辨异常到底源自 cuda-oxide、Rust 编译器本体还是底层的硬件抽象。图形接口领域的开发者也指出,现有系统默认不支持直接加载 PTX 着色器,强行引入会破坏跨平台渲染管线的统一结构。
但 AI 辅助编程正在大幅缩短新语言的普及周期。开发者实测证实,利用大模型可以快速将现有的 C++ 内核批量移植到新环境,并且能把执行性能磨合到相当水平。代码生成的速度补足了新方言在初期的熟练度短板,让架构选型的重点从语法规则学习转向了内存安全设计。
CUDA Rust 把 GPU 编程中最容易出事的错误从运行期搬到了编译期。尽管 nightly 版本的限制和依然欠缺的覆盖率阻碍了它立刻上产线,但通过借用检查器静态约束多线程并发访问的范式已经确立。
参考链接:
- Introducing CUDA Rust: Two Tracks for Writing GPU Kernels
- HN 讨论区