2026 年 9 月的一天,一个叫 OpenJev 的项目登上了 Hacker News 榜首,拿下 521 分、235 条评论。按常理,这应该是一次成功的产品发布。但翻开评论区,前十条顶楼评论里没有一条在讨论它的产品功能——所有人都在骂它的网页。
521 分和 235 条评论,全花在骂网页上
顶楼评论的原话很直接:「一次性用 AI 生成的站点永远是视觉灾难:塞不完的废话文案、随处可见的空话、不考虑可用性。」第二条评论把比喻拉到了校园:现在的 AI 输出像焦虑学生写的期末论文,本该删减得聚焦清晰,实际却反方向操作——把尽可能多的细节塞进去,假设读者没有别的选择只能读完。
分数和评论内容之间的错位,就是这件事最值得看的地方。521 分说明流量没问题,但评论区集体无视产品本身,火力全打在「看起来像 AI 做的」上。有人翻出老派企业网站做对比——伯克希尔、McMaster-Carr、Craigslist。McMaster 的纸质目录本身就是分类学教材,他们把这套哲学原封不动搬上了网页。也有替 OpenJev 说话的声音:做成极简风格,你又会抱怨「讲了半天不知道在做什么」。
但争论的焦点已经不在某一个站点的好坏。521 分帖子下面藏着的真正议题是:AI 让产出形式变得接近免费之后,「看起来像个产品」还值多少钱。
形式成本归零,信号就失效了
一个精致的网页、一段通顺的文档、一份漂亮的报告——过去,这些形式传递一个信号:背后有人认真做过事。制作成本就是信号强度的担保。AI 把形式的生产成本打到接近零,担保消失了。精致的外观不再区分「认真做的」和「随便生成的」。它变成了噪音。
同一天,另外几件事在技术社区同时发酵,指向同一个判断。McSweeney’s 发表了一篇讽刺文《We Must Create the Shit Machine》,在 Lobsters 拿到 89 分。它模仿科技公司发布会的语言,把「造一台会拉屎的机器」讲成人类必然需求,附赠只能挡住一部分的挡屎伞,条款里声明免责一切后果。评论区顶楼只回了一句:「什么叫『必须』造?我们早造出来了。」第二条评论更短:「屎机器永远写不出这个。」
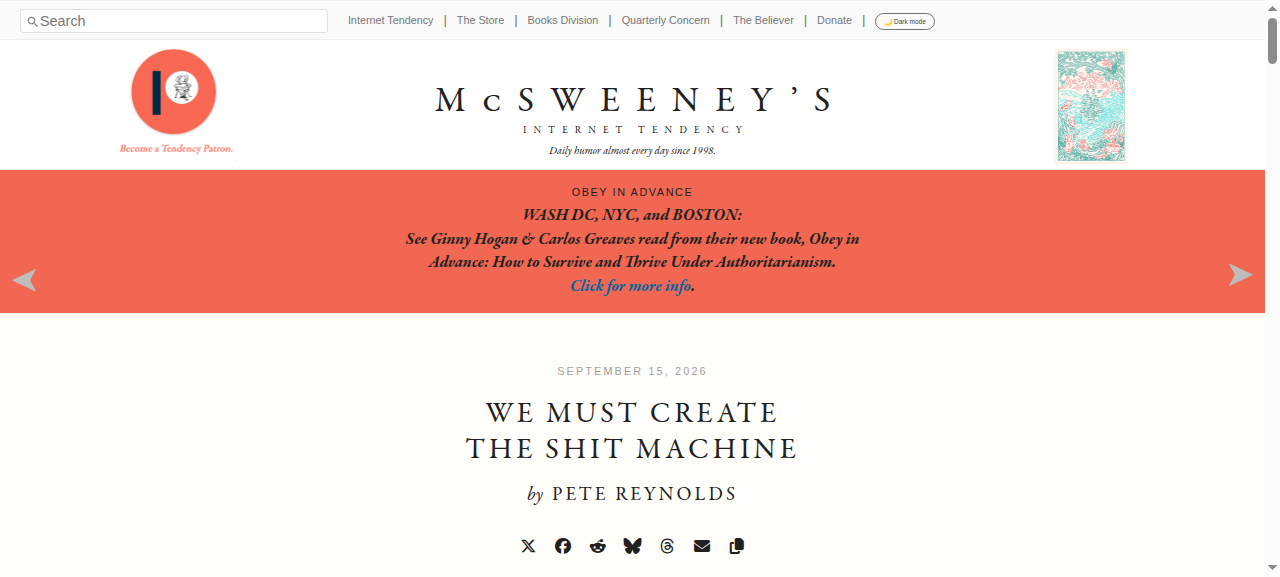 图:McSweeney’s 讽刺文页面。来源:McSweeney’s Internet Tendency
讽刺之所以成立,是因为它精确击中了社区的共识:大家不缺 AI 能生产什么的认知,缺的是一个出口来说「够了」。
350 分写作课教了一条规矩:不许用模型给你的词
同一天还有一篇文章拿了 350 分、238 条评论——一位资深系统工程师写的《How to Write with an LLM》。文章的核心判断足够尖锐:「读者能检测出 LLM 写的词,精度到万亿分之一。不管你花多少功夫打磨、拟人化,一段 LLM 生成的文字在大多数读者眼里不算写作,算输出。」
作者给出两条规则。第一,不得使用 LLM 建议给你的任何一个词,哪怕它更好。第二,避免模型的鼓励——夸奖会让你加倍下注初稿冲动,而你本该改写、重想、替换段落。原文用了一个词:那些重想才是你个人风格里「承重」(load-bearing)的部分。他的用法是:先自己写完,再让模型当校对。只让它指出问题,不让它挑词。
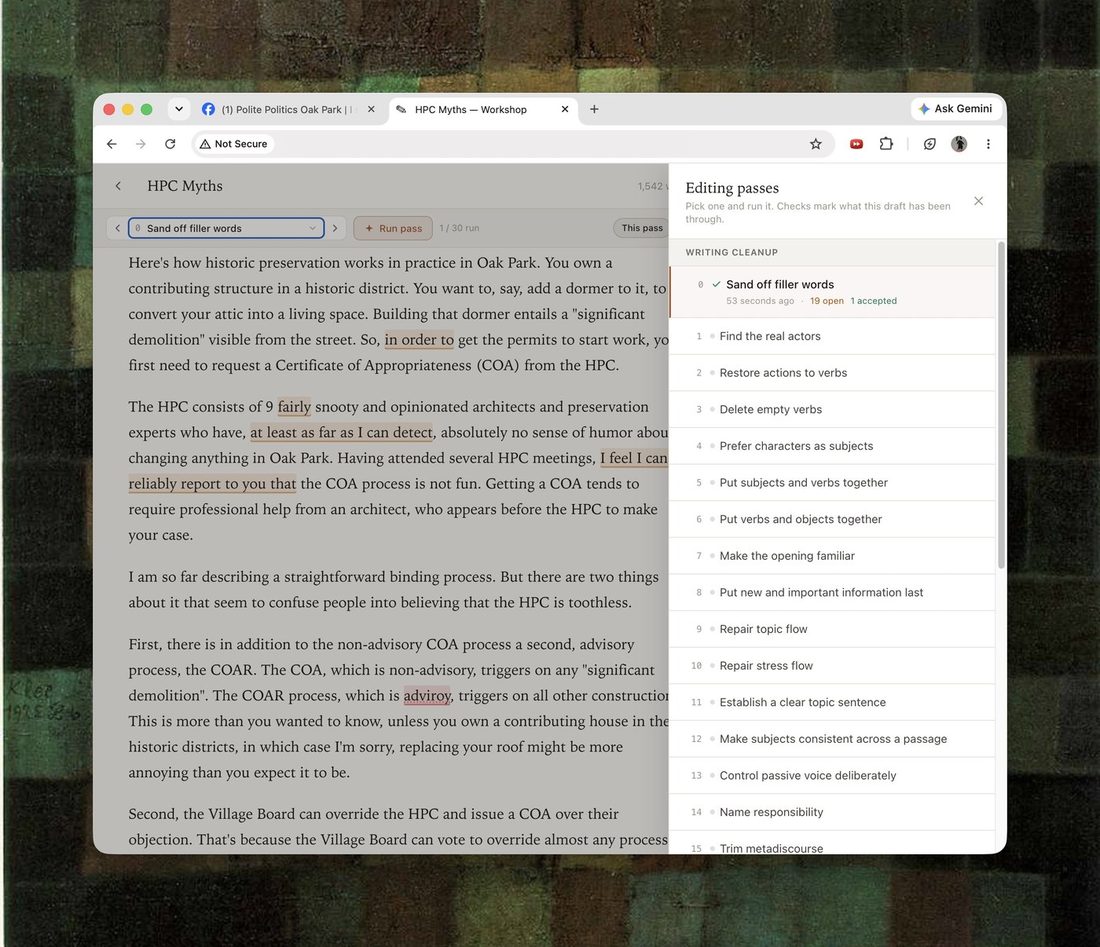 图:作者为管理逐字校对流程而造的工具界面。来源:sockpuppet.org
评论区的讨论把这套方法论推到了更务实的层面。有人说写完让 LLM 做质量复检是个巨大的时间陷阱:「改到最后变成忒修斯之船,还不如自己写。」有人说给一份样例风格指南比笼统说「写简洁专业点」有效得多,然后逐句问「这句能删吗」。最实用的一条把动机说破了——很多时候读者自己也在拿 AI 读你写的东西,所以你该用同一个视角先审一遍自己。
这条评论揭示了一个对称结构:写的人在用 AI 写,读的人在用 AI 读。双方都在把认知劳动外包给模型,但核验成本并没有被模型承担,只是被转移了。
75% 工作时间拿去处理 AI,乐趣被剥夺了
一位资深安全工程师在个人博客写了一篇《Everybody’s Lost Their Minds》,登上 Lobsters 头名,191 分、63 条评论。他的原话:每天有 75% 以上的时间直接或间接在处理 AI 相关的事,「剥夺了我大部分的工作乐趣」。他注意到同事们的邮件读起来像 LinkedIn 网红的帖子,用的是那种单句成段的写法。
他还指出一个更具体的现象:前沿模型公司争相发布各自的安全研究「项目」和公开信,几十名高薪安全工程师把全部优先级切过去做 AI 漏洞挖掘,花掉的是「上千万美元级别」的工程小时。而发现漏洞从来不是信息安全的瓶颈——修复和部署才是。资源的调配方向和实际瓶颈之间出现了错位。
Lobsters 评论区的一条高赞观察了社区本身的分裂:反 AI 情绪在 Lobsters(成员多为经验丰富的从业者)形成得很快,而 Hacker News 走向了相反方向。紧接着一条评论把机制说清楚了——一个社区把与主题无关的内容当离题处理,另一个是大机构的公告板、自家创业公司享有推荐位,两边面对的筛选压力天然不同。
幻觉情报差点出事,AI 证明改写了「证明」定义
同一天 Hacker News 上,美军因 AI 生成的幻觉情报报告差点出事(342 分、275 条评论,当日评论数最高)。Dan Abramov 的《我用 vibe 证了康威猜想》(197 分、174 条评论)讨论的是同一个问题的另一面:数学证明的可信度来自人能复核,如果把复核环节也交给模型,「证明」这件事的定义就变了。
这两件事和前面所有讨论指向同一个结构:**AI 压低了生产成本,但核验成本没有跟着降。**一份情报报告的生产成本接近零,但验证它是否是幻觉的成本和过去一样高。一段数学证明生成只需几秒,但确认每一步逻辑正确仍需要人类数学家的时间。一个精美的网页几分钟就能生成,但判断它背后有没有真东西,读者还是得自己花精力。
生产端的效率提升,在消费端变成了审查负担的转移。谁来付这笔核验的账,目前没有答案。有人认为这是 AI 工具需要解决的下一个问题;也有人——比如 danluu 同一天上榜的文章标题所说——「没有哪个时间点可以让你关掉脑子」。
这场发生在 2026 年 9 月的集体反弹,真正的内核不是「AI 有害」。它揭示的是一个更冷的事实:形式贬值之后,注意力正在按「谁做的、谁负责」重新定价。
参考链接:
- Hacker News 讨论(OpenJev)
- sockpuppet.org《How to Write with an LLM》
- McSweeney’s Internet Tendency《We Must Create the Shit Machine》
- netmeister.org《Everybody’s Lost Their Minds》
- Lobsters 讨论
- danluu 博客
- Dan Abramov《我用 vibe 证了康威猜想》


