2026 年 9 月,TypeSafe AI 带着非自回归决策模型 Jev 高调入场。其创始人 Diogo Almeida 以每百万 token 0.042 美元的低定价,向开发者推销这款决策组件。几天后,ConvAI Innovations 创始人 Nandakishor Mukkunnoth 开源了同构方案 Laya,并放出详尽的对比基准。Mukkunnoth 宣称自己在 2025 年 3 月就已经发表并开源了核心方法,直指 TypeSafe AI 抢占了技术署名权。这场围绕架构首创性与工程边界的冲突,把讨论推上了当日 Hacker News 榜单前列。
33毫秒单次前向重构延迟预算
让生成式大模型执行分类、分流与判断任务,在工程上是一种严重的算力错配。自回归模型必须逐字生成 token,每一次前向传播的延迟下限都被显存带宽死死卡住。非自回归决策模型抛弃了文本生成,转而要求模型在给定的选项列表中,直接输出每个选项的校准概率。这种架构剥离了生成逻辑,换取了处理速度。Laya 的 typed-decisions 421M 权重在单问题测试中,跑出了 32.8 毫秒的 P50 延迟。作为对比,Jev 的延迟落在 236 到 276 毫秒区间。
在更高并发的工程链路中,无生成架构的吞吐量优势被进一步放大。当对 10 个问题进行批处理测试时,Laya 的总耗时仅为 72.3 毫秒,折合每个问题 7.2 毫秒。相较之下,Jev 处理同样的批次需要约 1500 毫秒。将意图识别、路由分发和安全护栏等反射式任务从千亿参数的大模型手里剥离出来,智能体工作流的延迟结构发生了根本反转。系统开发不再需要为简单的逻辑分支支付高昂的自回归计算成本。
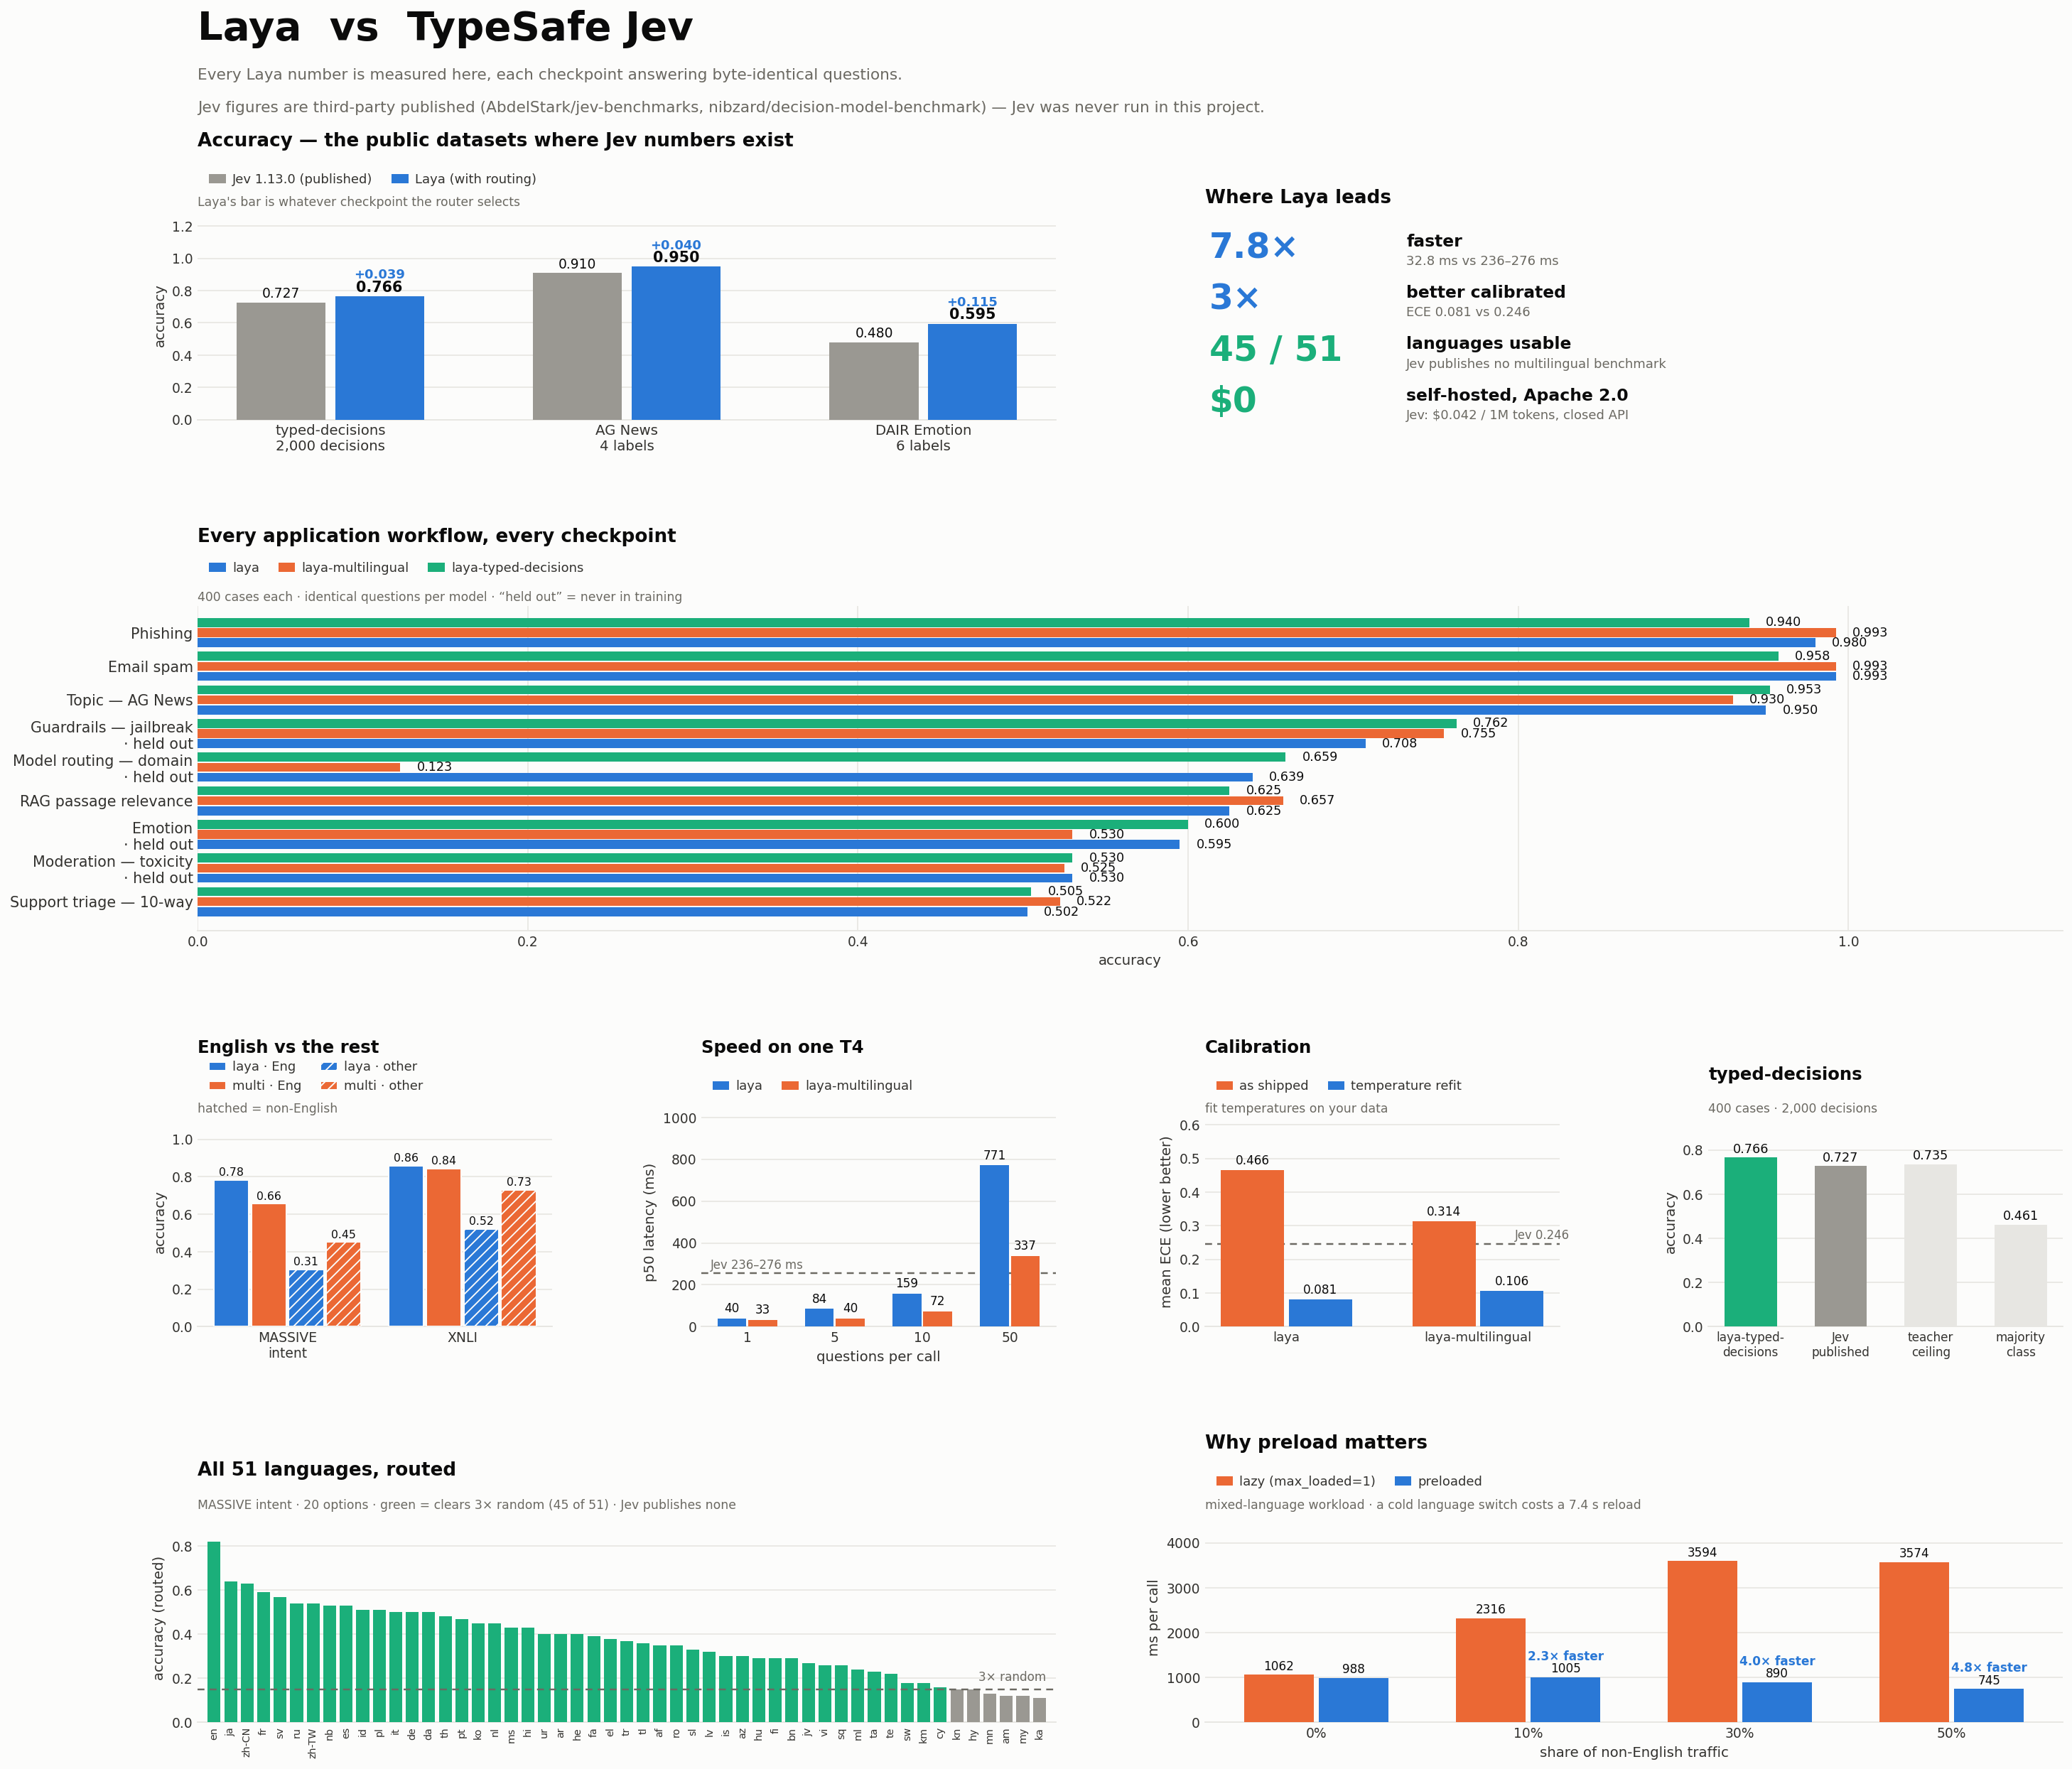 图:Laya 与 Jev 在延迟、多语言与多分类任务上的详细数据。来源:ConvAI Innovations
截取原始模型的输出概率往往存在误导性。Laya 的原始 logits 期望校准误差高达 0.466,此时模型在高度自信时给出的判断依然有接近一半是错的。开发团队针对不同问题类型引入标量温度进行校准后,将期望误差压降到了 0.081,低于 Jev 的 0.246。业务层可以直接将校准后的概率作为硬性拦截阈值。在 ToxicChat 越狱护栏测试中,Laya 跑出了 0.762 的准确率,配合 50% 的选择性覆盖阈值,准确率直接攀升至 0.931。
英文分词器切碎了多语言概率
架构层面的速度红利,在面对非拉丁语系时遭遇了严重的底层阻击。Laya 底座采用的 ModernBERT-large 依赖于 5 万 token 的 BPE 词表。这种以英文为主的切词逻辑,遇到复杂的小语种时会直接将语段切得支离破碎。切完之后,模型就丧失了语义感知能力。在涵盖 51 种语言的压力测试中,系统给高棉语打出了 0.000 的准确率,但模型对其判断的平均置信度却依然高达 0.952。亚美尼亚语的准确率仅为 0.050,等同于抛硬币,其输出置信度也达到了 0.885。
全语种扫描测试暴露出这类概率决策模型的一个致命盲区。测试数据显示,在面对几十种不同语言时,英文 checkpoint 的平均置信度从未跌破过 0.885,无论其真实准确率是优秀的 82% 还是垫底的 0%。分词器在输入端破坏了文本结构,后置的置信度门控根本无法拦截这些伴随高概率输出的幻觉错觉。
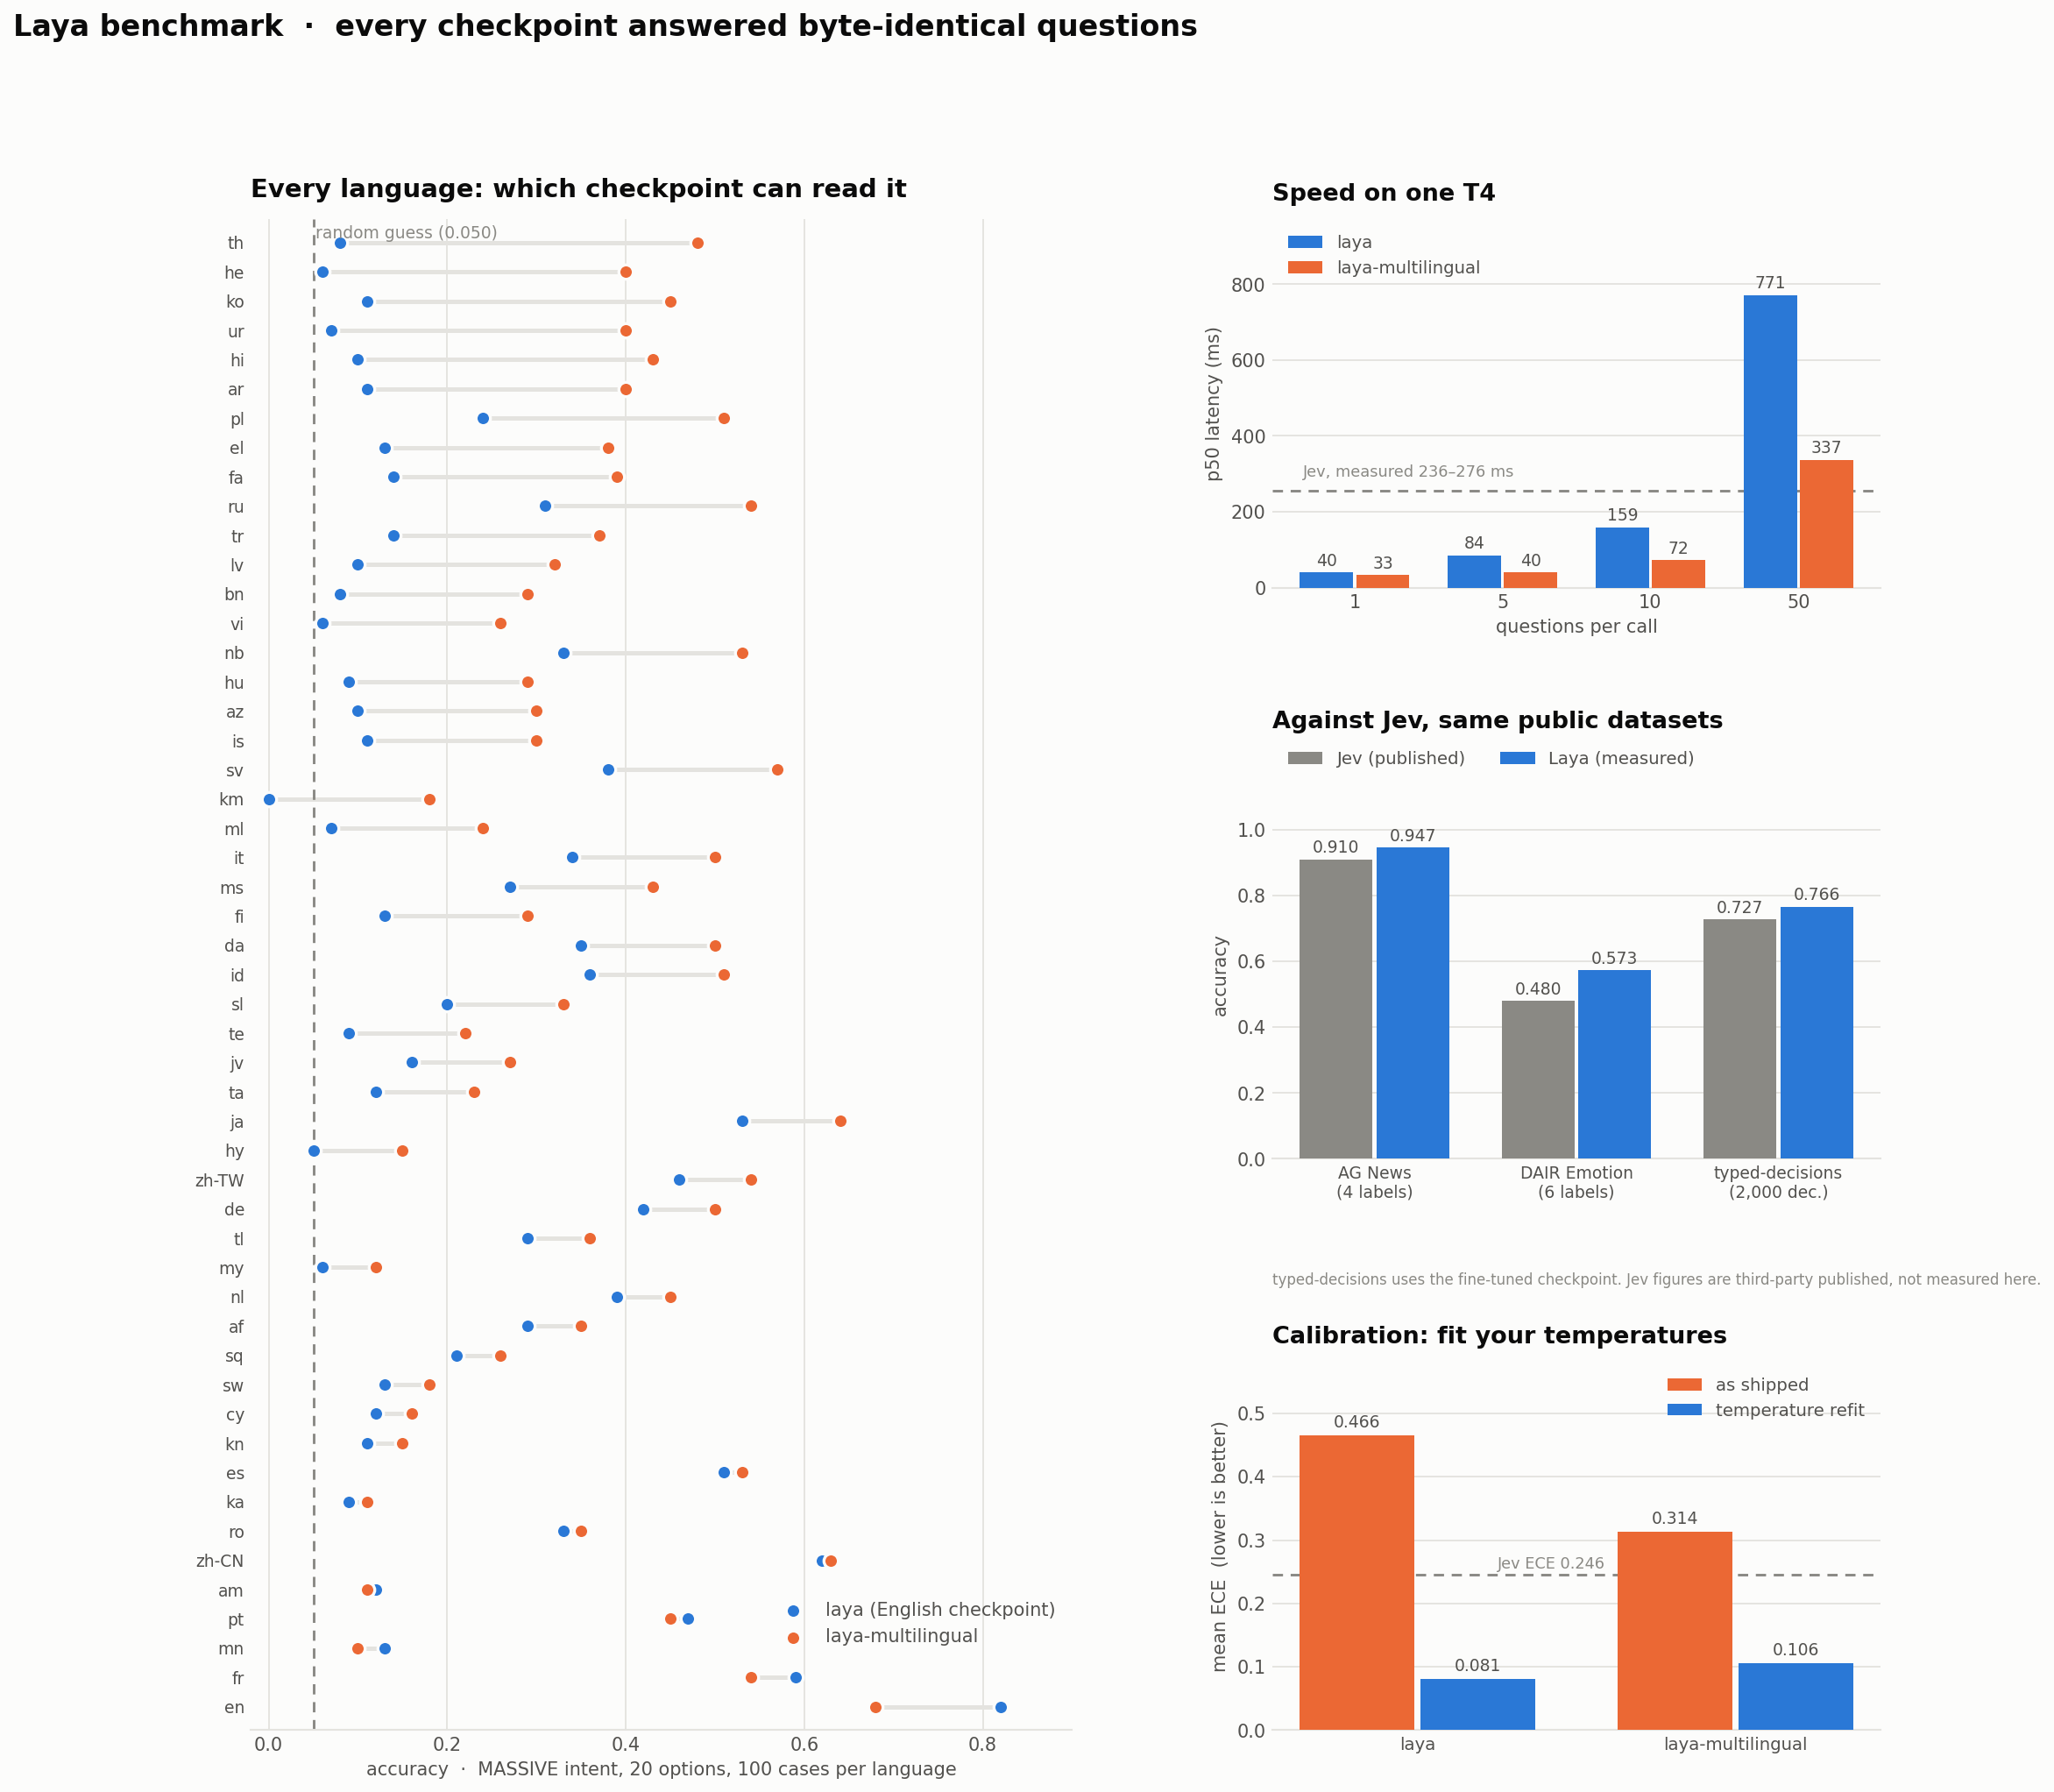 图:Laya 在多项分类任务与延迟基准上的表现。来源:Laya 开源仓库
工程团队必须在推理主链路之前硬塞入一套拦截网。Laya 内置了一个覆盖 22 种文字的 Unicode 脚本路由器。这个前置组件检测英文只需 0.09 毫秒,处理天城文或印度系文字耗时 0.54 毫秒,解析 200 行嵌套 JSON 也只需 0.73 毫秒。相对于 33 毫秒的模型前向传播,路由器的开销被控制在 2% 以内。不在数据进入模型前完成清洗,针对概率的微调补偿都缺乏实际工程意义。
长程规划与大标签空间暴露架构物理极限
剥离生成能力换取处理速度的硬币反面,是决策模型向复杂逻辑领域延伸时遭遇的性能天花板。在处理包含 77 个分类类别的 Banking77 意图测试集时,Laya 的准确率大幅跌落至 0.425,闭源模型 Jev 维持在 0.870。开源模型在广阔标签空间内的溃败源于其架构设计的资源瓶颈。对于 Laya 而言,77 个候选项必须共享 192 到 256 个 token 的总输出预算。平均计算下来,每个候选项仅能分配到 3 到 4 个 token 的位置。受限的上下文物理容量锁死了模型应对复杂分类任务的上限。
当非自回归模型被投入连续性决策场景中,架构脆弱性暴露无遗。在 Lobsters 社区的讨论中,有开发者将经典的 2048 棋盘状态输入给 Jev,仅允许模型在上下左右四个动作中做出抉择。实测表明,模型在 18 局游戏中的表现与随机游走没有差异。区区十几局的样本量远不够评估基准的收敛性,真正的长程规划测试需要成百上千局的分布验证。
非自回归决策模型在本质上只是一段高速反射神经。开箱即用的零样本情况下,这类模型的准确率往往在 0.35 左右徘徊,只有经过垂直基准数据集的深度微调,才能将准确率拉升至可用的 0.760 以上。一旦任务脱离了单步直觉判断,进入需要多步逻辑推理、状态观察与长效奖励规划的领域,依赖概率输出的捷径行不通。
讲清工程场景远比抢占发布时间困难
社区对署名权的争夺很快演变成了对技术演进路径的复盘。Mukkunnoth 详细列出了他在 2025 年 3 月的工作轨迹,包括使用 PPO 在序列表示上进行训练、在 Hugging Face 开源权重,以及在 Reddit 上发布技术帖。他当时对外宣传的核心切入点是「预测销售转化概率」。这种垂直场景的叙事,很难让工程受众联想到它在通用智能体架构中作为独立路由层的价值。TypeSafe AI 直接将相同的概念封装为智能体的 System 1,这种精准的工程抽象包装击穿了开发者的认知壁垒。
开源社区的反向审查也没有放过先发者。分析人员指出,Mukkunnoth 在 2025 年公开的训练脚本中存在目标泄漏,脚本在处理数据时将期望结果作为了模型的输入。第三方检测工具的报告也显示,原项目的说明论文高度疑似 AI 生成。面对 Jev 的商业化推进,开发者普遍认为非自回归的网络结构不是机密,真正难复制的部分沉淀在未公开的结构化训练数据与后训练清洗流程中。
同一技术直觉被不同团队独立实现是行业常态。单纯争抢开源时间的先后缺乏实际意义,技术落地的决定力量在于将其包装成具备泛化能力的可用组件。用强化学习调优模型并输出分类概率并不是学术创举,把这个机制稳定塞进千百种杂乱的生产流中,才是检验工业级产品的唯一标准。
非自回归决策模型在特定环节下的优势客观存在。把路由分发、意图识别和安全拦截从庞大的大模型中抽离出来,系统的成本与延迟获得了量级提升。但这类模型无法胜任深度的意图分类,也无法主导长期的状态规划。署名权的口水战终将被时间消化,谁能先用小规模参数在多语种与庞大标签空间中做到不崩溃的精准分发,谁才站得住。
参考链接:
- 论文 arXiv:2503.23303 与 arXiv:2510.01237
- DeepMostInnovations/sales-conversion-model-reinf-learning
- Non-autoregressive decision models HN 讨论
- Kicking tires on Jev: TypeSafe’s System One (Lobsters)