2026 年 8 月 25 日,OpenAI 正式发布首款自研 AI 加速器 Jalapeño。这款 4-bit 算力最高达到 13.4 PFLOPS 的芯片,搭载了 232 GB 的最先进内存。它的内存带宽更是被推至 15.4 TB/s 的行业高位。OpenAI 引用的基准显示,相比现在依赖的 Nvidia GB300,Jalapeño 将端到端延迟(从提示到最后一个 token)最多降低了 3.6 倍,并且功耗表现更为出色。硬件指标固然强悍,但这套系统的核心冲击力在于其反常识的开发节奏。从首次架构概念雏形到首颗硅片回厂,整个周期不到 20 个月。传统先进制程芯片从立项到流片,通常需要耗费三到五年的漫长跋涉。硅谷的硬件工程师早已习惯了慢工出细活的节奏,因为流片失败的代价动辄以千万美元计。但 OpenAI 此次用事实证明,硬件开发的铁律出现了松动。
更为夸张的数据是,从第一版 RTL 代码敲定到最终流片,他们只用了 9 个月时间。在这个庞大的工程里,硬件负责人 Richard Ho 确认全程平均不到 100 人。这个百人团队至今还在同时推进第二代和第三代架构的设计。这个人数包含了系统设计、软件以及供应链等所有角色,但不含合作方 Broadcom 的人。传统硅谷芯片大厂动辄千人规模的团队建制,正在被一种全新的杠杆率无声解构。
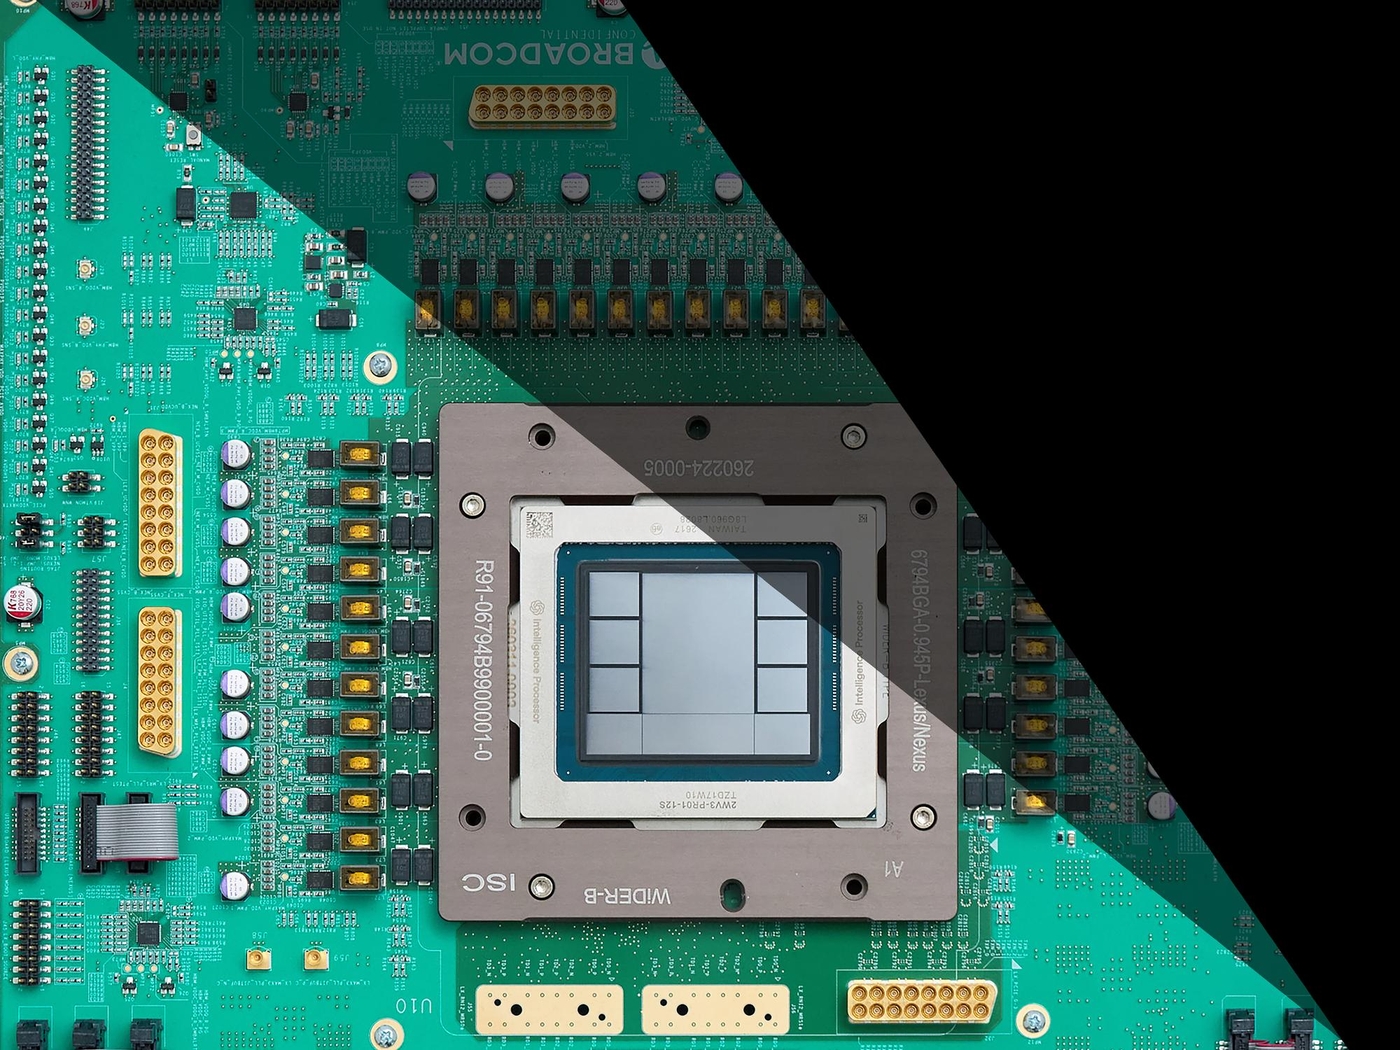 图:Jalapeño 封装近景,计算 die 配六堆 HBM4 加一颗 I/O chiplet。来源:IEEE Spectrum / OpenAI
逻辑综合工具成为模型培养皿
在传统的 IC 设计周期中,逻辑综合与验证环节是吞噬人力的最大黑洞。OpenAI 团队跑出这种速度的动作要领,是将前端设计全面转入高维软件化流程。他们把前端工作流建立在 Google 开源的高层综合工具 XLS 之上。设计者使用受 Rust 启发的领域语言 DSLX 和 C++ 编写逻辑,随后由 XLS 转换为 Verilog。XLS 的核心理念是通过高级综合,将复杂的硬件逻辑转化为类似常规软件编译的过程。这种思路在过去属于学术界的长效探索,但在大语言模型时代才真正释放出强悍的生产力。项目团队里的 Chris Leary 当年在 Google 恰好就是 XLS 项目的发起人。把硬件描述语言抽象到高级编程语言的维度,使得前端验证可以直接挂载软件工程的自动化跑道。
这种抽象层级的提升,精准命中了大型语言模型的代码生成射程。在项目刚启动的 2024 年 10 月,团队使用的是 o3 模型。这款模型直到 2025 年 4 月才对公众发布。到了项目收尾阶段,他们已经切换到了 GPT-6 Astra 的前身模型。要知道 Astra 直到 2026 年 9 月 3 日才正式公开。新一代模型不再必须通过 XLS 作为中间件进行代码转换。它可以直接手写并输出底层 Verilog 代码,甚至已经接近能自主操作复杂的专有芯片设计工具。只要硬件设计流程被降维成结构化的文本文件,算力集群就能以高频次将其吞噬并重构。
为了展现这种生产力跃迁的细节,我们可以比对两代模型的工程应用纵深:
| 生产力切面 | o3 周期介入深度 | Astra 前身周期介入深度 | 工程演进启示 |
|---|---|---|---|
| 硬件描述生成 | 依赖高层综合工具 XLS 进行翻译 | 跳过中间层直接输出 Verilog 代码 | 抽象编译链条正在被端到端模型直接折叠 |
| 设计语言偏好 | 主要编写 DSLX 与 C++ 逻辑代码 | 多语言混用并直接操作底层 RTL | 语义理解能力的进化大幅压降了人工干预率 |
| 专有工具掌控 | 仅提供基础代码转换的辅助建议 | 逼近可直接操控复杂的芯片设计工具 | 行业标准 EDA 工具的传统使用门槛急剧塌缩 |
| 团队协同负荷 | 需要人工处理层间接口的数据一致性 | 系统自动串联各层级代码的重构验证 | 沟通内耗不再跟随系统工程的复杂度线性暴涨 |
前端工作流的换血,重塑了硬件工程师的时间观念。UCSD 教授 Andrew Kahng 认为这个速度大概是当今最好的水平。他回忆起 2016 年的一场设计自动化研讨会上,当时还在 Google 的 Ho 就把设计周期定义为团队一天能完成多少次迭代。现在,这支小规模队伍借助模型的全天候高频输出,把迭代频次推向了人类工程师体力的生理盲区。评估一支芯片团队的综合战斗力,已经从清点资深工程师的人头数,变成了计算每天能跑通多少次全链路仿真验证。
四十小时推平理论性能天花板
如果前端代码生成速度还在行业推演范围内,那么回片后的软件调优则打破了原有的开发常识。首颗芯片在 5 月回片后,团队立刻将内部专用的微调模型指向了基准测试软件。在针对 DeepSeek 的多头潜在注意力(MLA)kernel 的基准测试中,他们在几十个小时内完成了性能的极限爬升。初始跑分状态下,硬件性能仅仅摸到了由算力和内存带宽决定的理论天花板的 0.31%。但在接下来的 40 小时里,模型自动主导了代码重写与实机编译,将这个数字稳健地推到了 88.94%。
这种算子压榨速度在过去等同于天方夜谭。芯片流片回厂,以往不过是底层驱动团队连续数月熬夜加班的起点。大量的时间被耗费在汇编级别的指令抠索与手工排错上。多头潜在注意力机制是新一代模型架构里的关键算子,它的运行效率直接决定了推理集群的吞吐量上限。传统的开发路径是,算法工程师给出理论公式,底层程序员对照着冗长的硬件手册,一行行手写汇编指令进行调度磨合。Ho 明确表示这个 40 小时跑通优化的结果可以复现。从流片回片到量产爬坡这个最为耗时的窗口期,因此被强行截断了。底层硬件性能的释放瓶颈,不再取决于系统程序员敲击键盘的速度。机器正在以每秒千万次的频率与新出炉的硅片进行底层交互。
 图:Jalapeño 部署形态,包含 2048 颗芯片的 pod。来源:IEEE Spectrum / OpenAI
物理设计网表后的明确边界
尽管前端生成与后端软件调优势如破竹,但在跨越门级网表进入物理设计阶段时,OpenAI 划定了严格的能力边界。在 Jalapeño 面向包含 2048 颗芯片的 pod 部署形态中,团队的职权范围被严格收束在端到端系统设计。这些工作涵盖了推理加速器、内存层次以及复杂的网络互连架构设计。而从门级往后的物理设计这类重资产硬仗,则全部交接给 Broadcom 处理。物理布局布线要处理时序、功耗控制和电磁干扰,这条路依赖工程经验与工艺库的长期积累。Broadcom 凭借数十年的定制硅片量产底蕴,负责带芯片避开制造流程中的各种暗礁走向量产。不碰自己不擅长的制造深水区,是这套极速流程能够落地的核心保障。
模型在物理后端的收益客观存在,但远未达到前端那种压倒性的优势。在 IEEE Hot Chips 2026 峰会上,Ho 和 Leary 亮出了具体的收益数据。通过 AI 辅助的物理设计优化,矩阵乘法单元面积比人工优化的基线再减少 10%。这确实削减了不菲的硅片制造成本。但在一次流片动辄数千万美元的容错红线前,10% 的面积收益并不足以让决策层交出后端的控制权。Verkor 联合创始人 David Chin 认为这套时间表确实可信,但这其中 Broadcom 的深度介入是决定性因素。如果换一家从零起步的初创团队,绝无可能按时交出成品。
这种清晰的边界认知同样映射在管理层的公开发言里。团队并不认为芯片设计能够被全自动完成。Ho 更是直白表态,不是说谁都能用 Codex 造出前沿的计算加速器。但同业对此显然有不同视角的评估。同在 Verkor 公司的 Ravi Krishna 认为 OpenAI 的后端做法偏向保守。在他眼中,2026 年 4 月之后的模型已经能更好地处理这类物理层任务,今天重新起盘一个类似项目绝对会更快。这种对立的业界判定证明,大语言模型深入物理后端的进程依然是处于摸索期的深水航道。
与主流目光聚焦在硬件指标上不同,Hacker News 上的社区讨论展现出更隐秘的技术忧虑。部分声音怀疑 OpenAI 大张旗鼓地宣讲这段硬件开发史,骨子里依然是在推销自家模型的强大代码能力。这种做法也引爆了业界对芯片设计核心知识产权外流的深层恐慌。更有敏锐的开发者捕捉到了流程本身的时序倒挂。等芯片回厂再编写底层软件这种天然串行的开发顺序,已经被模型极速手写算子内核的能力当场解构。也有人担忧,整个被大幅压缩的时间表,本质上是悬停在下一代模型肯定会更强这个具有赌博性质的高风险假设之上。
不难看出,这场由智能算力主导的造芯竞速并没有越俎代庖去操作硅片代工厂里的光刻机。大模型真正接管的,是那些披着硬件外衣却长着软件骨架的逻辑推演层。用开源的高级转换工具拉平前端语法门槛,用海量的自动化代码生成覆盖算子的性能优化,才是这二十个月奇迹的底层驱动力。在这套循环里,计算力并没有造出全新的物理法则。它只是用充沛的算力资源,把人类在工程设计中妥协于生理极限的软件工序,高效地重新跑通了一遍。
参考链接:
- IEEE Spectrum 报道
- OpenAI GPT-6 Astra 发布页
- Hacker News 讨论