把 10 张参考图喂给一个参数量只有 70 亿的视觉模型,它给出的文本渲染效果,在实测中盖过了商业级的 gpt-image-2。2026 年 9 月 20 日,阿里通义在 GitHub 以及诸多开源平台同步释放了 Qwen Image 2.1 图像生成与编辑统一模型,做到了这种体积与能力的倒挂。这不仅是一次简单的版本号迭代,它把开源图像模型能做到什么这条线,结结实实地推到了闭源商业产品的边界内。
视觉组件只留七十亿参数,出图渲染胜过商业竞品
上一代 Qwen-Image 1 的视觉组件参数量足足有 200 亿,而新发布的 2.1 版本直接把这个数字砍到了 70 亿。对于大多数深度学习工程来说,参数量减小三分之二通常伴随着明显的性能退化,但新模型在社区测试里交出了反直觉的成绩单。
在拥有 148 条评论的 Hacker News 热门讨论中,运行提示词到用户界面设计站的开发者 jjcm 给出了一份实测结论。他放出 gpt-image-2 与 Qwen 2.1 的并排对比图,评价后者的文本渲染好过开源权重市场上的所有竞品。能在画面里把字母拼对,是图像模型从玩具走向实用工具的一道坎。
社区用户 trains39472 把测试范围扩大到了排版更为复杂的中日韩文字。他的实测情况反映,这个 70 亿参数的扩散模型在渲染东亚文字的效果上甚至好过微软 Windows 系统的默认表现。这种精确到像素的把控,打破了参数规模决定论的刻板印象,训练数据里优化过的排版范式发挥了真正功效。
首帖作者 vunderba 拿它跑了 15 项基准测试,顺利通过了 7 项,对比上一代仅仅通过 4 项的成绩,进步幅度肉眼可见。分数跃升映射到具体场景里,就是出图的可用率从碰运气变成了有底气的预期。
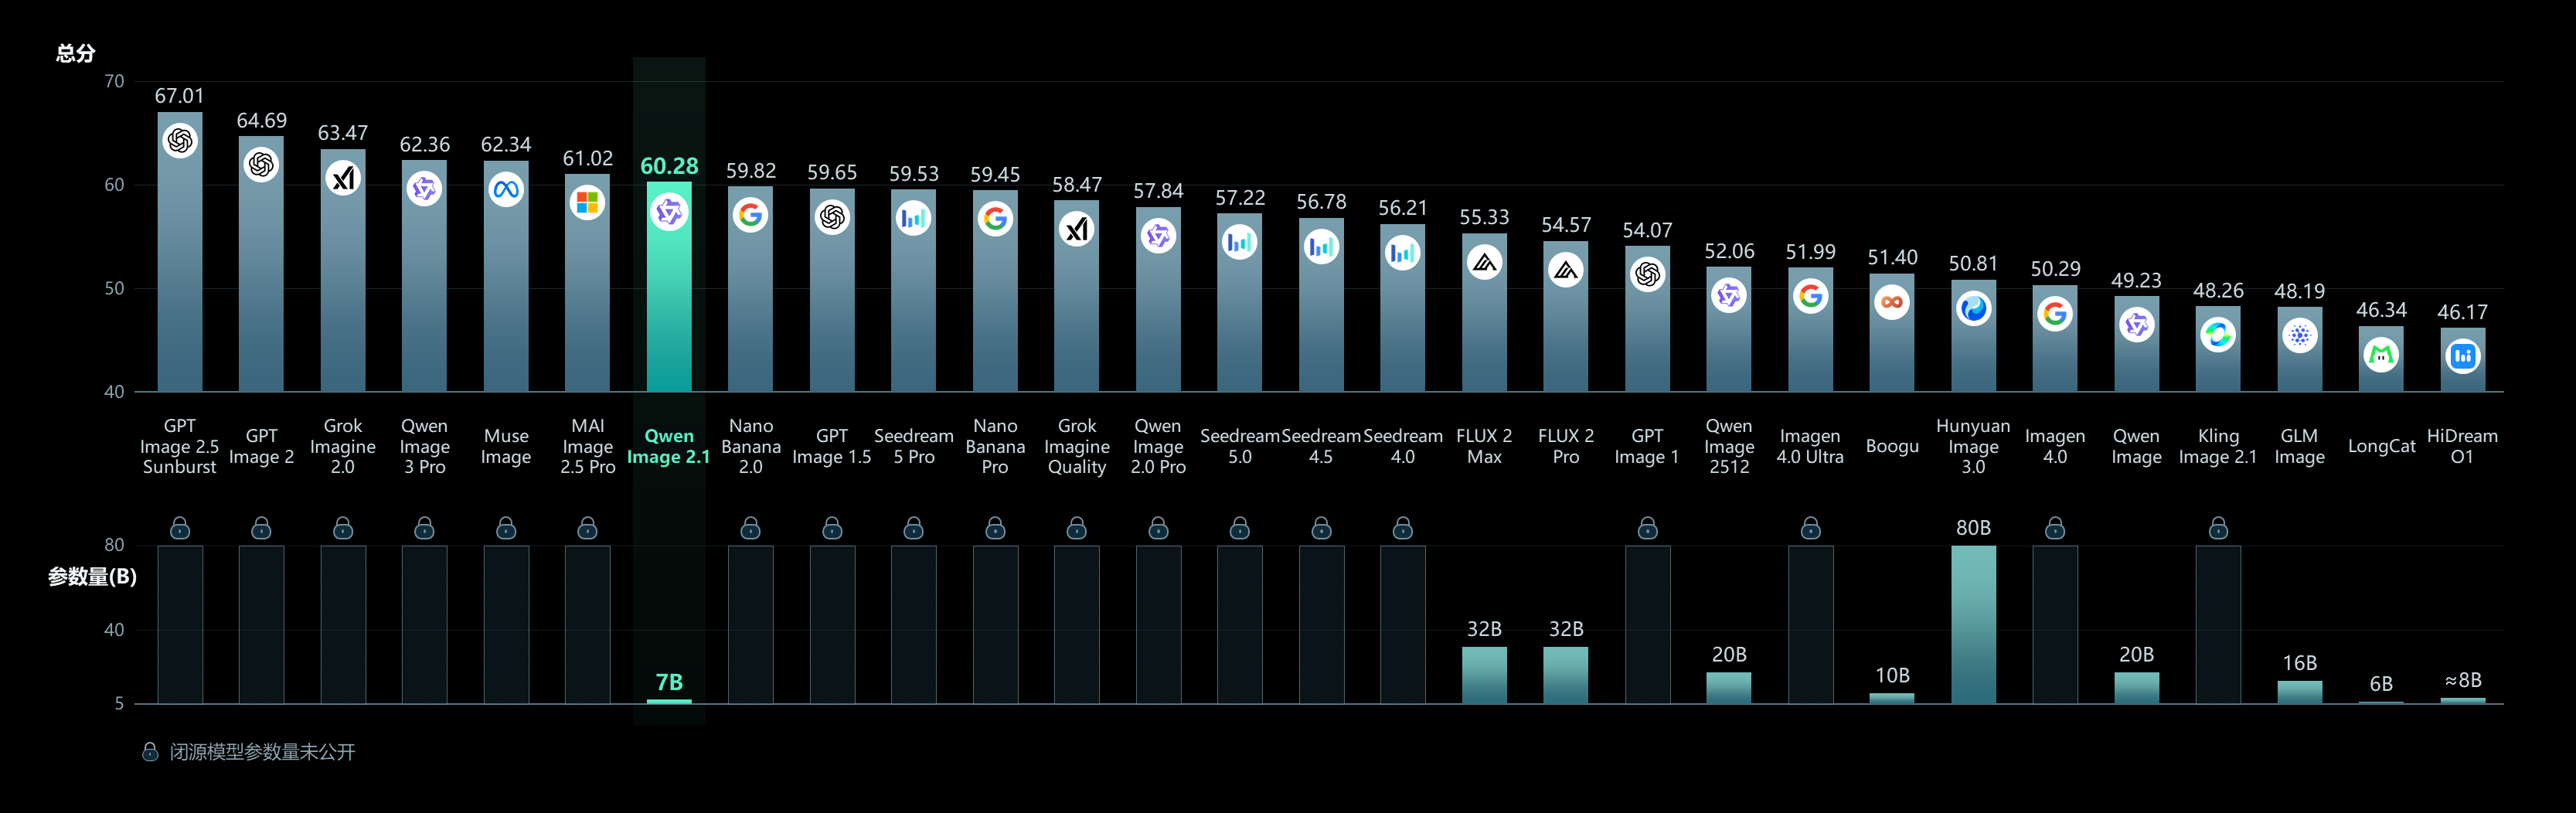 图:Qwen-Image-Bench 上开源/闭源模型的对比图。来源:通义千问官方博客
拆解混合粒度注意力机制,把算力花在刀刃上
70 亿参数的 32 层单一数据流架构能够打出这种效果,得益于底层推理逻辑的重新分配。研发团队在 Qwen Image 2.1 里引入了混合粒度注意力机制。
文本提示词、系统前缀和编辑指令使用 token 级别的因果遮罩,确保对语言指令的细粒度理解;而对图像生成任务,则切换到分块级别的遮罩。针对不同模态套用不同颗粒度的计算尺,直接避免了把算力浪费在无效的高清像素关联计算上。
更巧妙的优化在于键值缓存的复用机制。模型把输入的参考图和编辑指令当成静态上下文,在第一步计算完成时就把它们缓存下来。当后续生成步骤需要重复参考这些条件时,引擎直接从内存里读取计算好的结果,避开了反复提取特征的冗余过程。
这种克制且精确的硬件资源调度,让本地跑图不再是一种对显卡的残酷压榨。社区开发者 fishfasell 分享了他的日常体验,本地开源图像生成现在只要几秒钟就能出图,甚至比本地代码生成更早一步跨入了顺畅无感的成熟期。
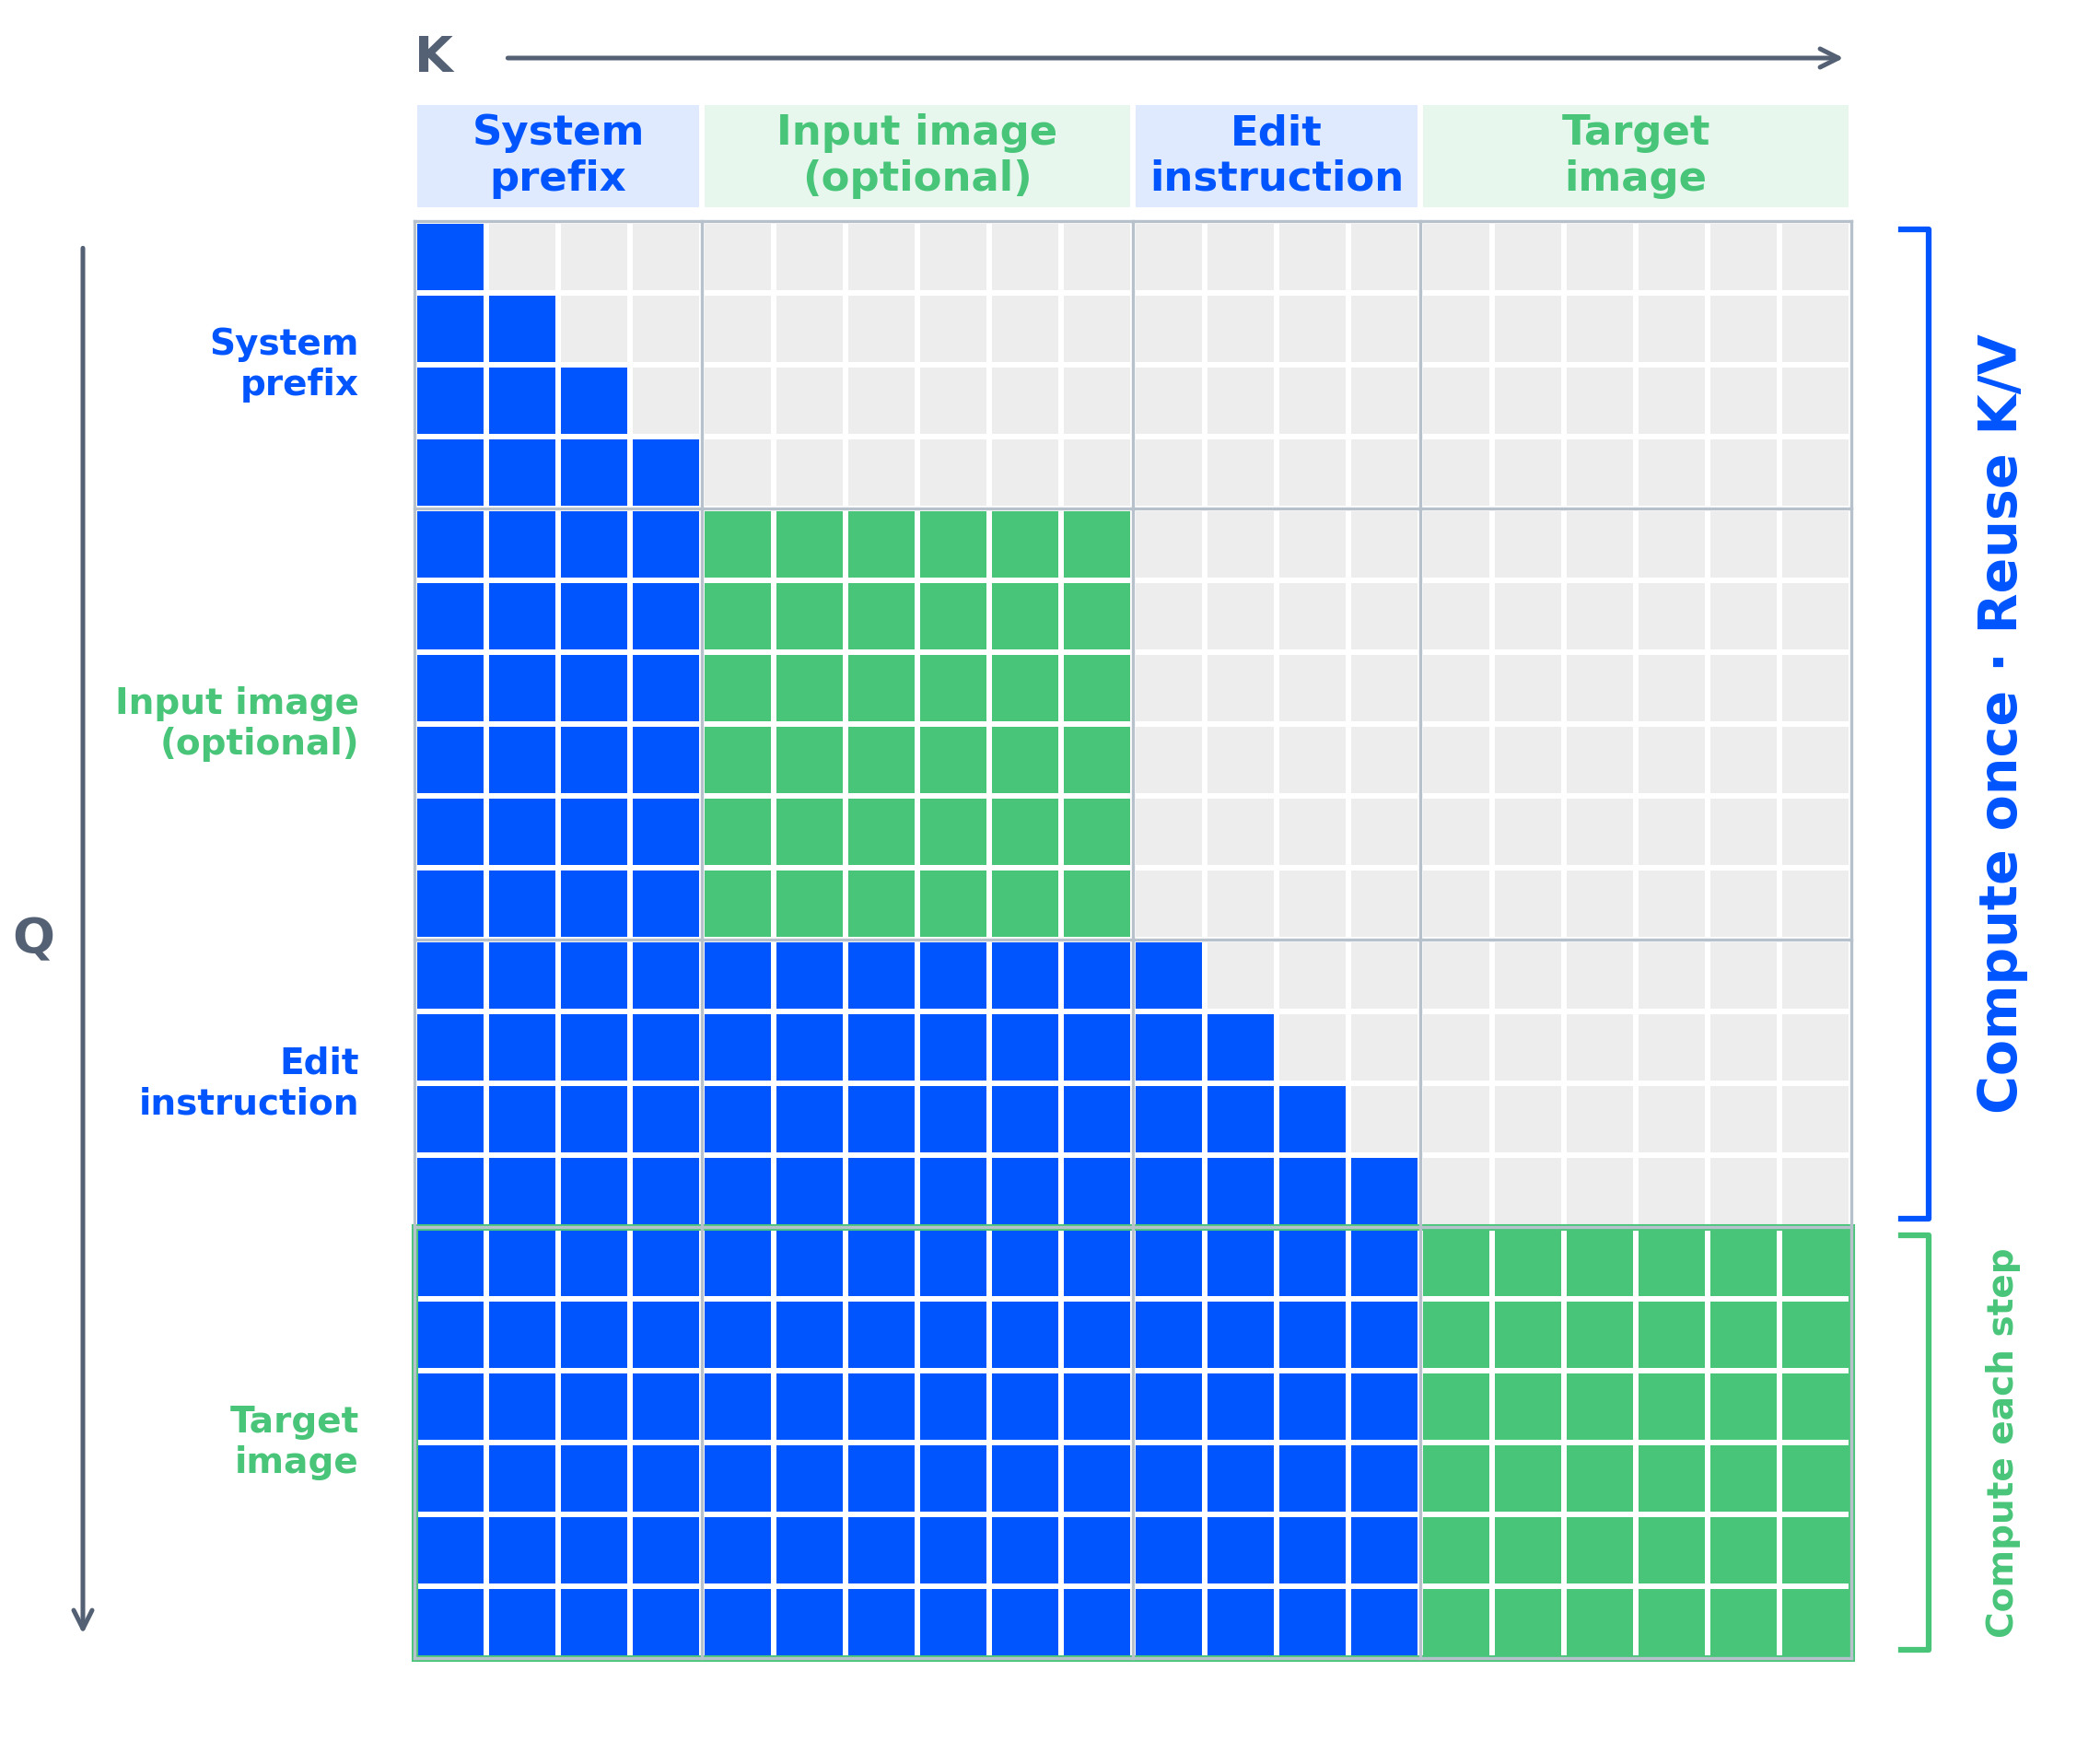 图:混合粒度注意力架构示意。来源:通义千问官方博客
原生支持输出透明通道,交互方式补齐工业短板
模型在工业界吃灰,很多时候受限于输出格式无法直接插入现有的工作流。Qwen Image 2.1 将 2025 年 12 月的 Layered 能力整体并入了统一模型中,做到了原生支持透明通道输出。
用户只需要在提示词里多加一句指令,模型就能决定是否输出带透明度信息的 RGBA 图层。官方博客展示的文生透明图样例里,主体直接以免抠素材的形态呈现,从一张背景复杂的 RGB 照片里直接抠出主体并生成透明层,把原本需要多款软件协同的抠图工作变成了一句话的步骤。带着透明通道输出图片,才是真正贴合设计业务实际场景的产品逻辑。
 图:文生透明图示例,主体直接以免抠素材形态输出。来源:通义千问官方博客
为了让局部编辑变得可用,开发团队一次性给出了三种交互方式。用户可以通过画面圈选、涂抹标注,或者是单独叠加遮罩来指定需要修改的区域。官方示例里,一句指令要同时处理三处改动:蓝色圈里的金属手表要摘掉,红色圈里的头发改成黑色,绿色圈里的白 T 恤换成灰色短袖亚麻家居服——三种颜色的圈选各自为政,模型逐一执行互不干扰。
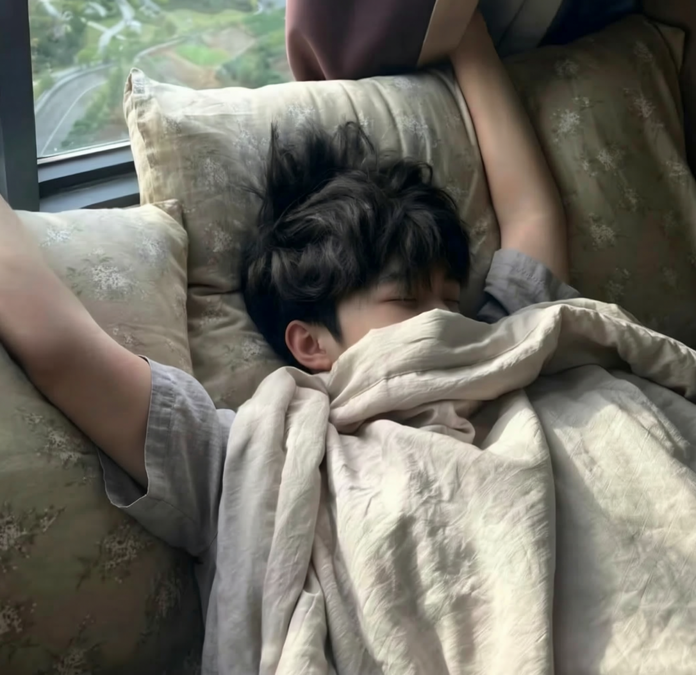 图:彩色圆圈标注的局部编辑输入,左为标注图右为结果。来源:通义千问官方博客
配合最高支持 10 张参考图的上下文窗口,使用者能够把多角度的光影信息一次性喂给系统。官方放出的合影示例里,六张单人人像参考图被合成进同一张新场景的合影,六个人的面部特征各自保真,服装姿势和光线则全部重新编排。交互维度的补齐把图像模型从单一的自动抽卡机,改造成了响应操作指令的数字画笔,把对画面的控制权重新交回到了人类手里。
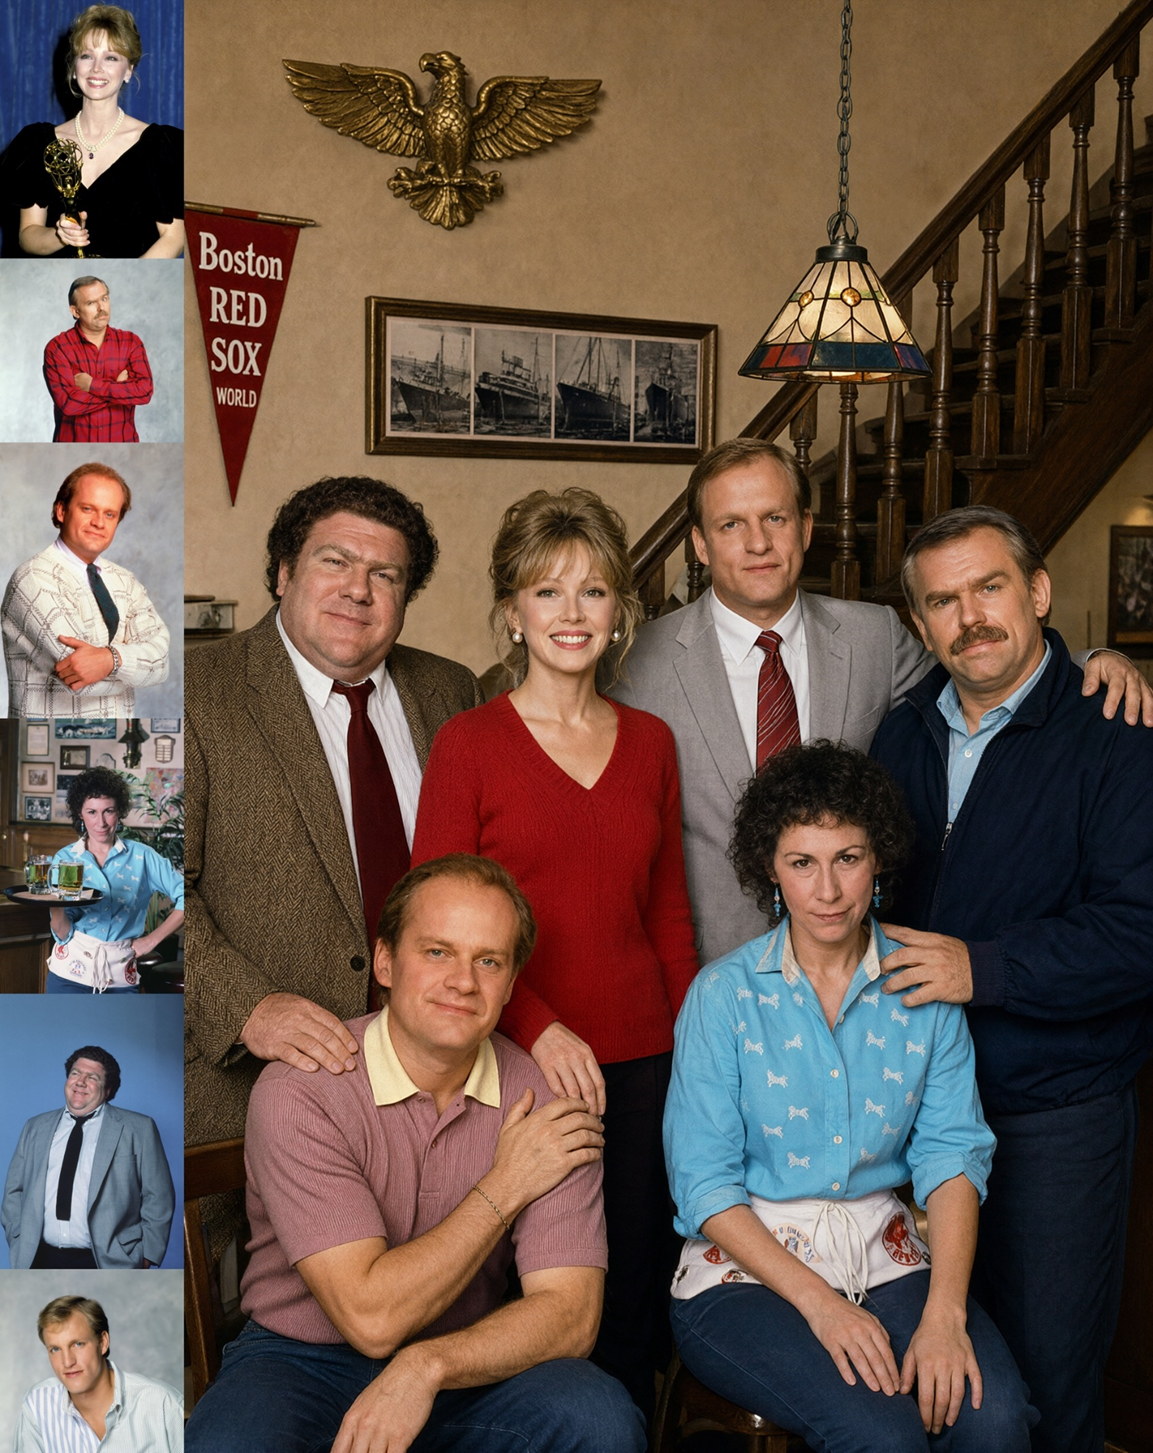 图:六张人像参考图(左)合成为同一场景合影(右)。来源:通义千问官方博客
 图:透明图层上的表情编辑:左输入右结果。来源:通义千问官方博客
官方博客还展示了从一张普通模特照直接扩展成整版中文信息图的效果:个人档案、服饰色卡、五维雷达图、场景推荐全部一次生成,汉字渲染接近可商用设计稿的水准——这正是文本渲染能力最直观的落地演示。
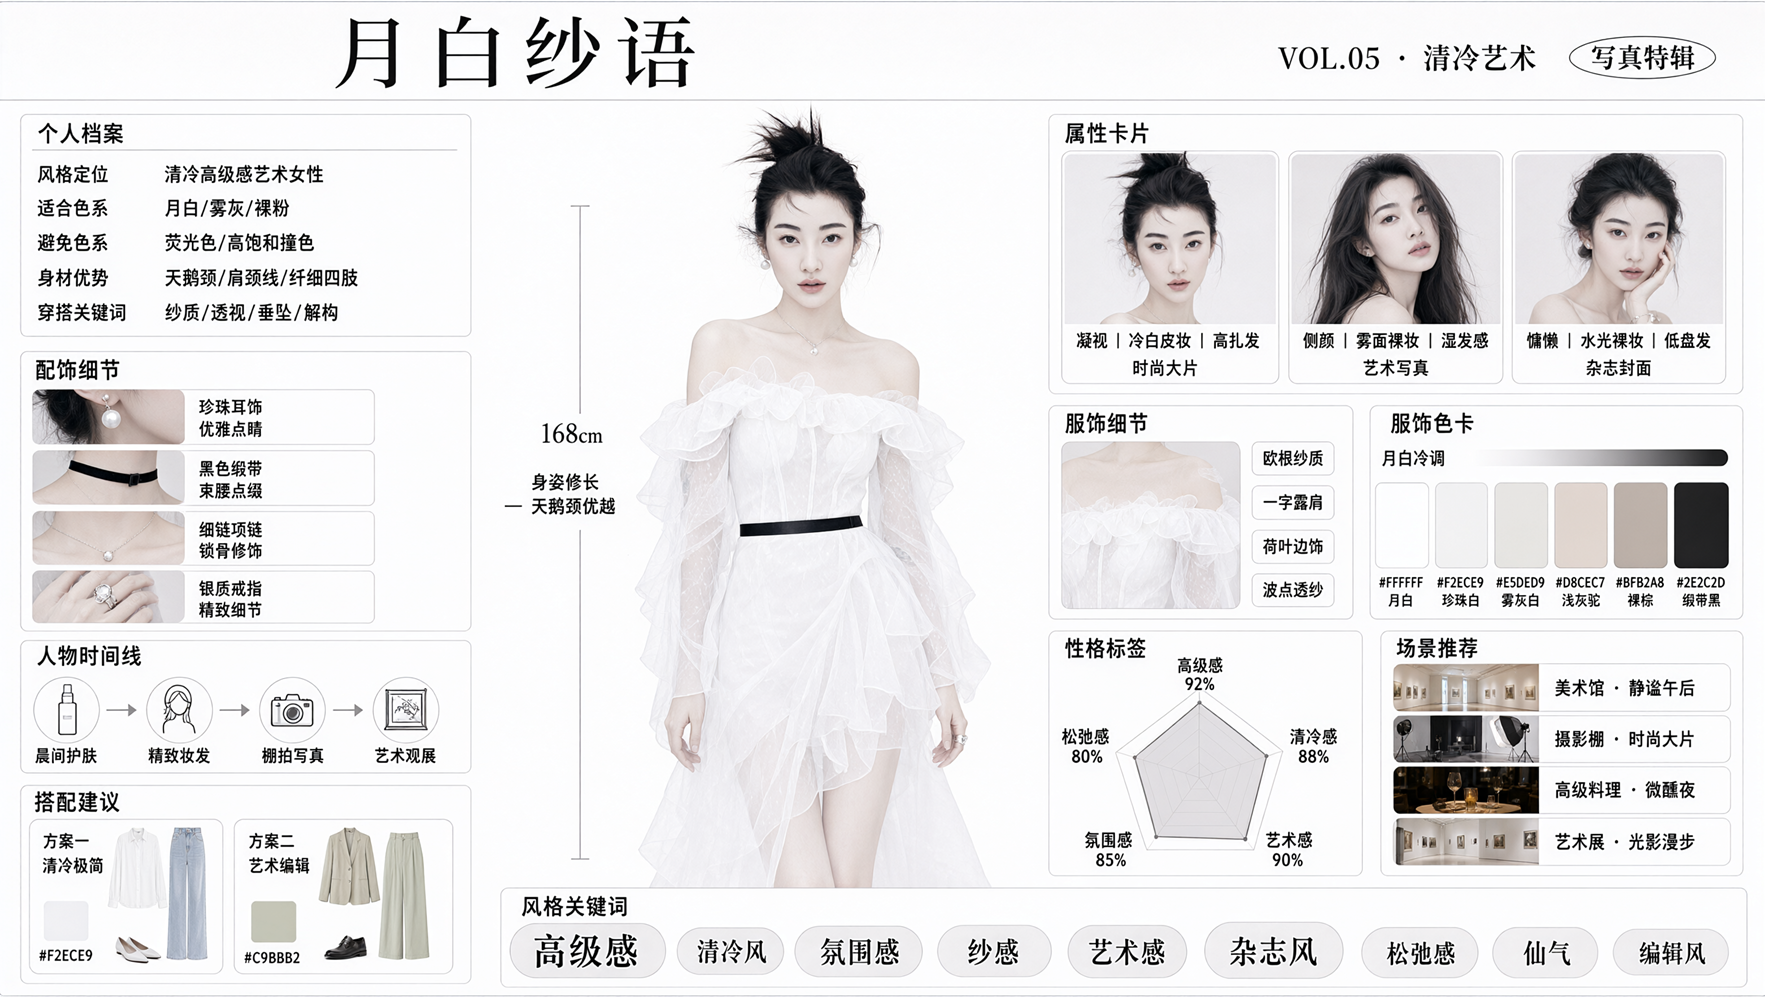 图:由一张模特照片扩展生成的完整中文信息图。来源:通义千问官方博客
社区实测挑出偏见漏洞,能力升级换来许可收紧
工程产品的落地总是伴随着妥协和细节处的裂痕。用户 Epitaque 在基准测试中抓出了一个明显的漏洞:当提示词里写了「拿环击打坩埚」时,模型画出了毫无关系的铁砧,依然被系统判定为测试通过。
vunderba 承认像铁匠、锤子这类高频词汇把模型的联想路径带偏了。基准测试终究无法覆盖所有的语言关联偏差,提示词在可见的未来依然是一门需要人类微调的手艺活。另一个反馈来自 trentor,他发现虽然之前被诟病的 VAE 组件得到了修复,但异常现象并未根绝,画面中间调仍然残留着微小的点状图案。
训练数据分布带来的倾向性同样刻在了模型的输出结果里。rickreynoldssf 在测试中发现,人像生成存在严重的东亚面孔偏向,哪怕给足了高加索人种的参考图,渲染出来的五官依然有着明显的东亚特征。这是所有区域性团队训练模型时都要面对的本土化特征绑定问题,破除这种隐性偏见需要重塑整个数据飞轮。
伴随模型能力的跃升,法律边界也变得清晰且冰冷。jfoster 查阅代码仓库里的文件后指出,这一代的许可证比历代惯用的 Apache 协议更严格。天下没有零代价的商业前沿模型,开源社区享受到了闭源级别的性能体验,同时也必须接受商业公司对使用场景和衍生权利的严厉框定。
Qwen Image 2.1 的意义,并不仅仅停留在那些越级战胜对手的测试分项上。当 70 亿参数的架构可以在端侧毫无阻碍地输出透明通道、实现复杂文本渲染时,追求千亿规模和暴躁算力的旧有路径被撬开了一道缝隙。把能做的事情做好,用巧劲替代暴力美学,或许才是下一代模型真正要走的路。
参考链接:
- 阿里开源 Qwen Image 2.1,7B 视觉组件引热议 - HN (item?id=49775499)