价格与效率双降,音视频推理跨过成本红线
2026 年 9 月 18 日,阿里通义千问正式上线 Qwen3.8-Omni-Flash 原生全模态模型。新模型在 29 项核心多模态评测中超越上一代 Qwen3.5-Omni-Plus 平均达 25%。核心变量在于底层定价重构:官方音频输入单价直接下调超过 98%。若以 720p 分辨率、1fps 帧率且按两分钟素材成本的 30 倍来测算,音视频综合输入每小时的时价降幅超过 93%。1M Token 窗口不再是摆设,一小时源文件终能跑在后台常驻进程里。
在 HN 讨论帖中,开发者将 Gemini 系列高昂的计费表拉出对比。Qwen3.8 给出了百万 Token 输入 0.15 元、输出 0.47 元人民币的报价。这种量级的单价下杀,把全模态模型从前沿实验室的演示台,直接拉进了企业可以核算投入产出比的常规生产线。
 图:官方博客顶图,标榜全模态感知与代理式交付能力。来源:Qwen 官方博客
放权自主检视,用策略控制冗余画面吞噬
此前多模态基座读取视频通常采用流水线式的逐帧遍历,画面总长与算力消耗成正比。Qwen3.8-Omni-Flash 在 OmniVideoBench 长视频代理理解测试中暴露了新的运行机制:它把单次查询的平均 Token 消耗从 145,736 强行压缩到 79,117,耗用减幅达到 45.7%,同时查询准确率逆势从 63.4 升至 67.8。模型拿到了信息摄取的主动权,通过先建立粗粒度框架再进行多轮细粒度取证,自己去决定哪些分段值得深挖,直接绕开了无效画面对计算资源的挤占。
代理评测数据验证了这套机制的实效。基座在 WildClawBench-MM 取得 36.5 分的增幅,在 AgenticVBench 和 UniClawBench 分别拿到 22.3 分的增长与 69.6 的绝对高分。文本处理性能也没有因为叠加多模态架构而受损,基本持平同等体量的纯文本模型。赋予大模型这种自我调节检视颗粒度的能力,是防止长程视听任务陷入代理死循环和运算闲置的关键防御机制。
剥离多说话人声纹,结构化输出接管会议流水账
人声重叠与声纹混淆一直是音频管线灾区。AliMeeting 评测数据记录了 Qwen3.8-Omni-Flash 在复杂人声环境下的表现:DER(Diarization Error Rate,说话人分离错误率)从 88.11 坠降至 3.35,多说话人连接字错率 cpWER 也从 89.61 降至 17.18。一整段杂乱无章的会议录音,可以直接在单一模型内部完成声纹剥离、文本转写与人员身份匹配。以往需要多个专精小模型串联才能勉强拼凑的语音清洗链路,现在被一个大型神经网络一次性接管。
在 LongAudioSpan 取得 8.3 分涨幅,让模型在长达一小时的多人会议场景中具备了业务黏性。这种重构的价值不仅在于产出高精度的转录文本。拿到准确的分离数据后,代理可以当即生成带有人员指向性的会议纪要、排查项目执行的潜在风险。根据识别出的特定讨论结论,它还能直接调用下游工具发送邮件或新建代码任务。让音频数据真正成为触发后续工程动作的可靠输入源,补齐了办公自动化引擎缺失的重要环扣。
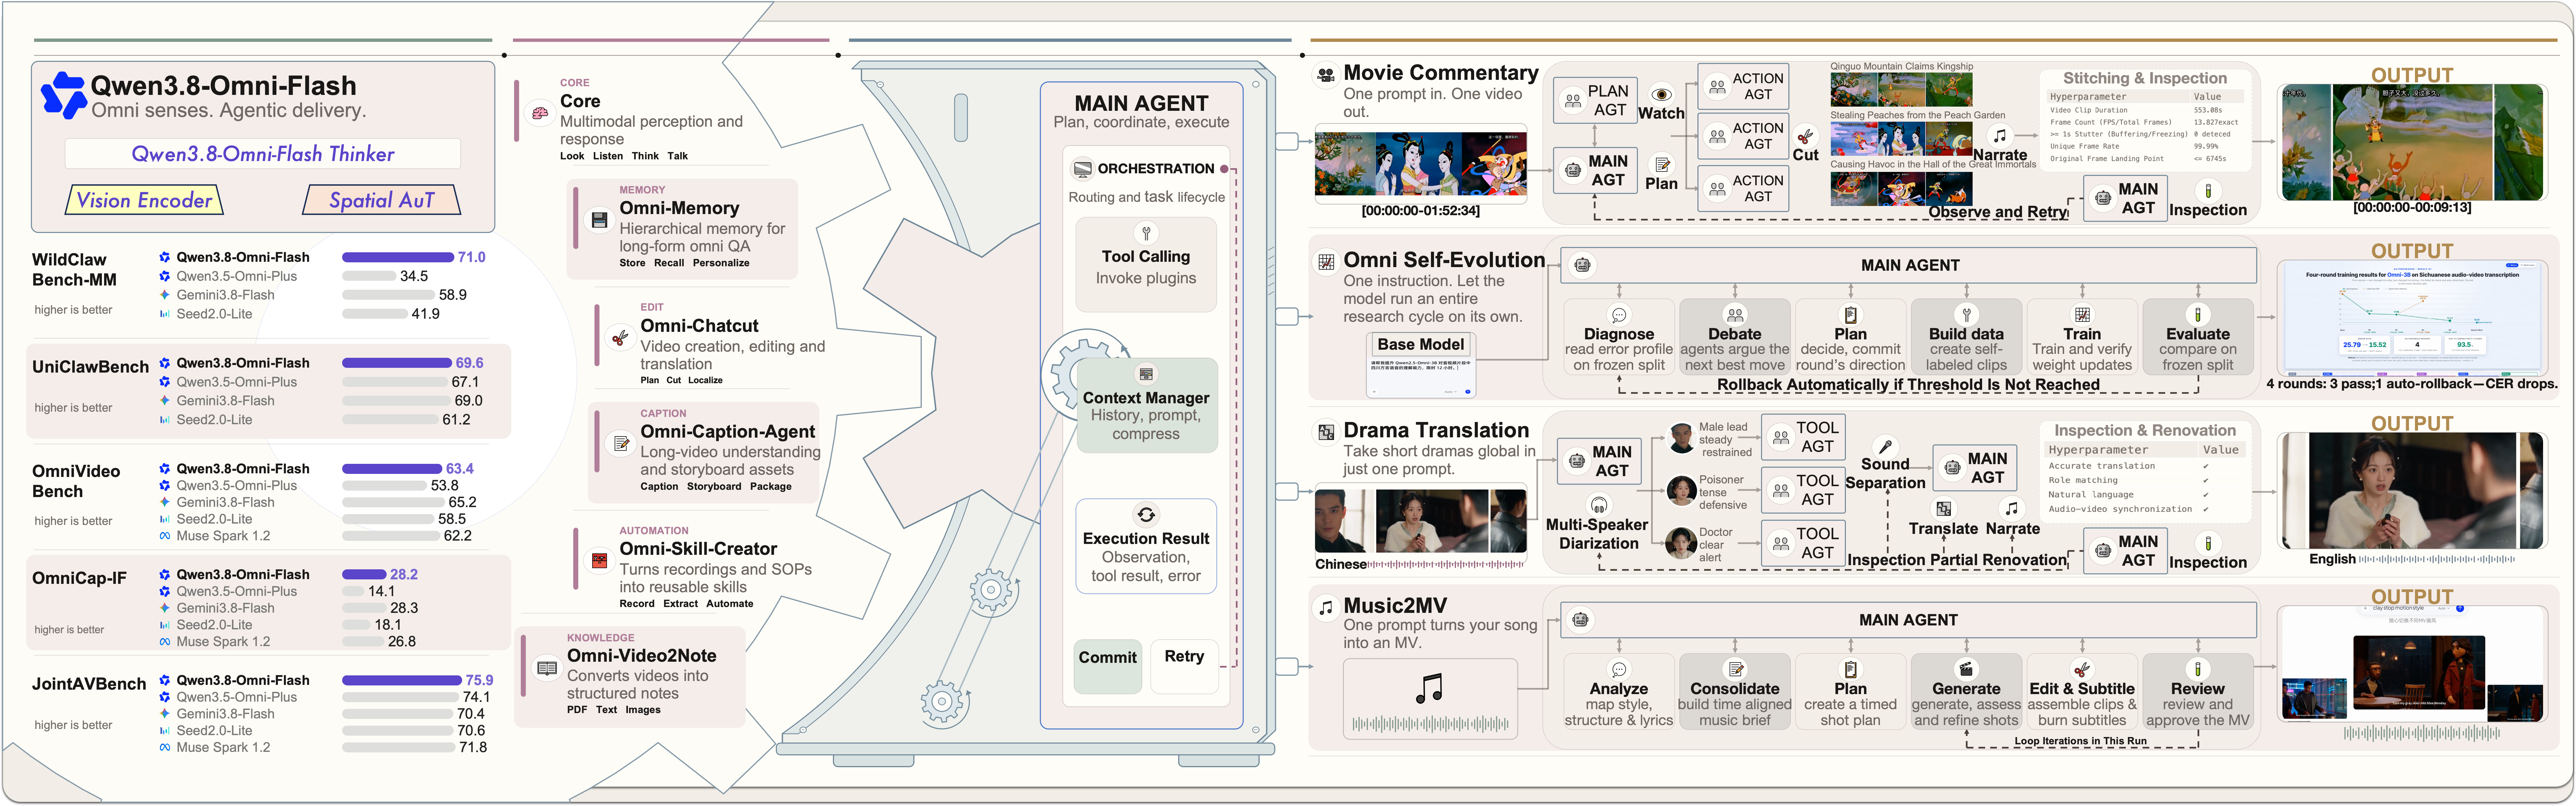 图:生产场景应用总览,展示全模态模型在视频摘要、实时对话等场景的落点。来源:Qwen 官方博客
补齐代理外围组件,从终端对话窗走向后台执剑
为了承接新增的音视频处理能力,阿里在工程件配套上给出了完整方案。专门应对长视听数据与动作接驳的 Qwen-MM-Plugins 上线,开源的 Qwen-Live Harness 更是让开发者只需一条 npm install -g qwen-live-harness 命令就能完成环境初始化。这个组件内部包揽了任务委派分发、多轮主动交互与长期记忆管理。搭配 Realtime 接口,代理终端能在接收流的同时无缝完成响应和工具调用。
组件打包交付的思路反映了国产基座生态建设的推进速度。第三方开发者已将新系列视作测试基准面,同日冲上 HN 热榜的 Bonsai 2 27B 即基于 Qwen3.8 27B 权重压缩。在可控音视频描述任务 OmniCap-IF 中,针对 CSR 与 ISR 指标分别拿下 8.5 和 14.1 分的增益,也证实了其精准图文匹配能力的工程可用性。
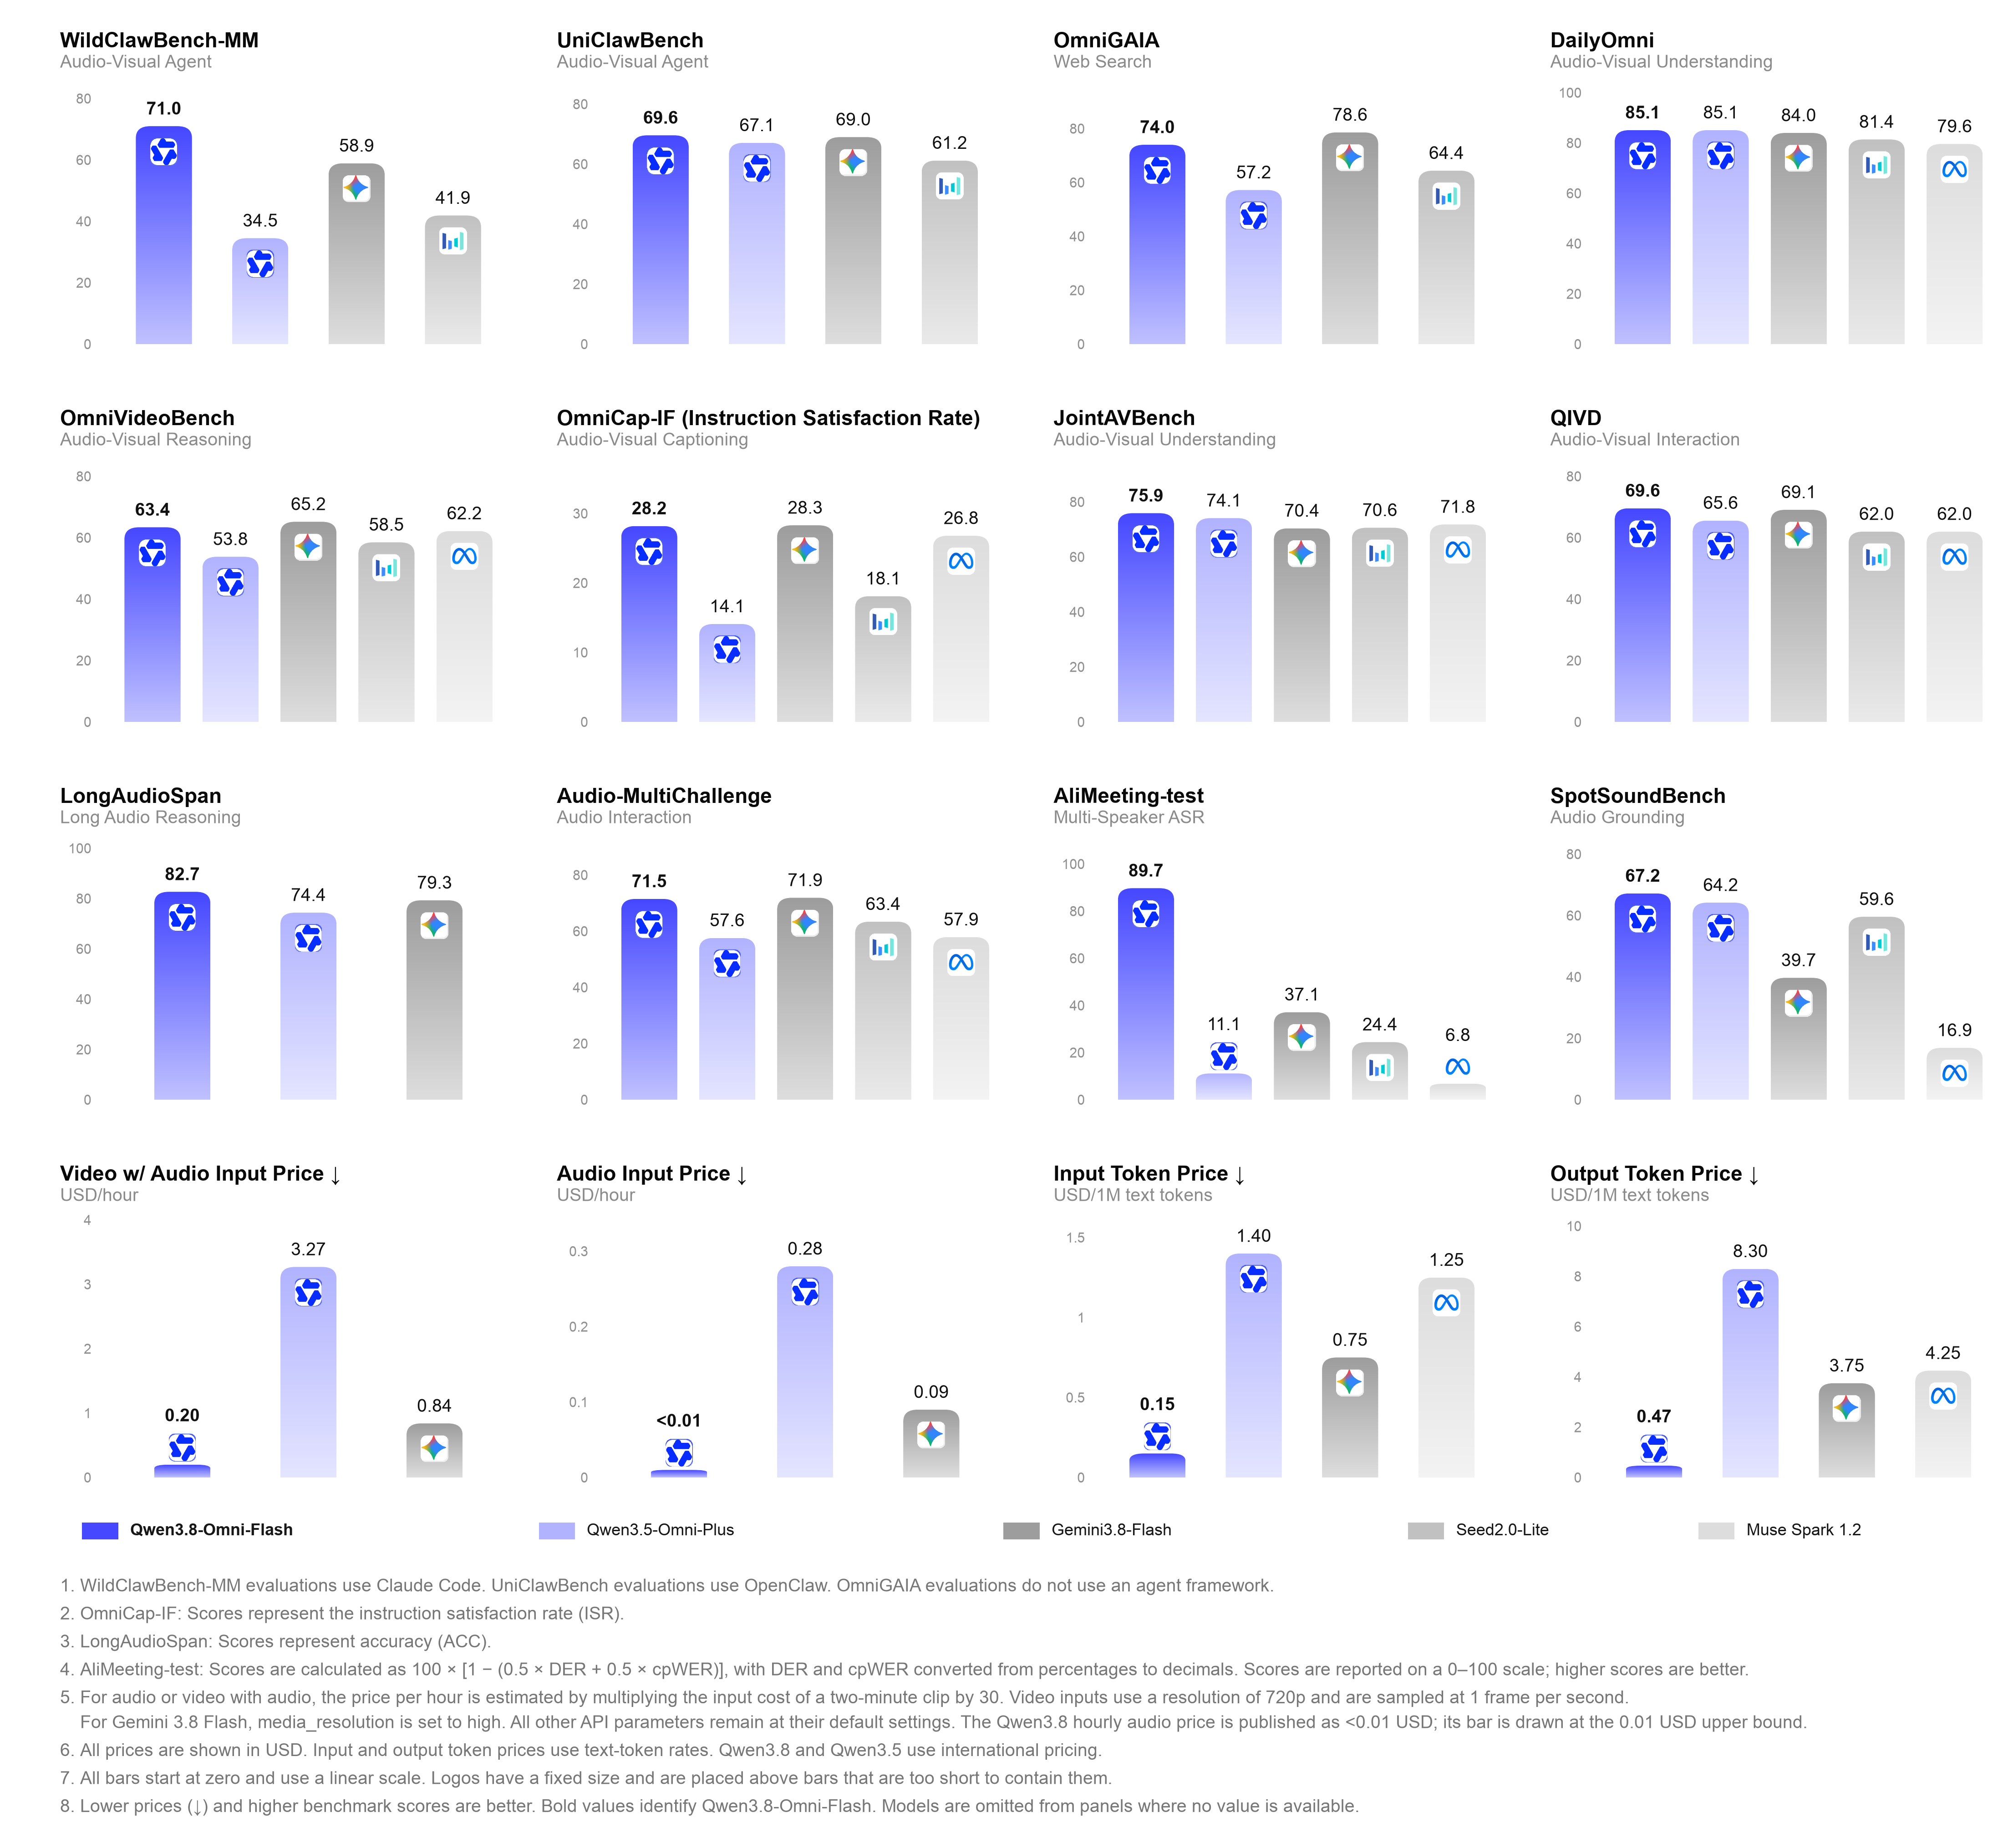 图:官方价格与基准测试成绩对照图表。来源:Qwen 官方博客
账单博弈与实际损耗,幻觉式调用仍是部署雷区
账单数字的狂欢很快迎来了技术社区的实地复核。在 501 分的讨论贴里,开发者直言官方宣称的能力若属实,将严重冲击 Gemini 在多语言音频处理上的主场阵地。不过这种兴奋很快被落地的具体问题冲淡,部分用户反映官方博客中新 Harness 的代码仓库链接在发布初期抛出了 404 错误。技术人员也指出,单次查询的极低标价不足以反映工程全貌。长上下文频繁触发的缓存读写成本与命中率波动,才是计算总成本的真正大头。
实机测试反馈进一步暴露了模型落地的摩擦成本。多位测试者提出,即便在使用 Qwen3.8-Flash-Next 系列时,模型偶尔会在两次工具调用之间抛出「用户没给我任务」的幻觉式自言自语。部分用户怀疑这是量化损耗或服务端侧配置不当引发的参数漂移,但即使换用官方提供的 NVFP4 配方,这种异常表现依然偶发。在一个不受人工干预的全自动代理链条里,几句无意义的幻觉可能导致整个循环崩溃或产生海量废弃 Token,这是工程上线前必须排查清楚的故障隐患。
从看懂像素到核算成本
全模态模型的竞争重心已经从能不能看懂视频,移到了每小时推理开销能不能塞进企业的日常预算表。Qwen3.8-Omni-Flash 把音频单价打下 98%,依靠按需检视策略少消耗近半的 Token。这两件事合在一起,才让几十分钟的会议录像真正变成了可并发的自动化流。跑分追平乃至在局部超越 Gemini 3.8 Flash 是前沿模型拿得出手的敲门砖,但真正让它立住脚跟的,是把原先昂贵的多模态认知打造成了一件称手且低价的批处理组件。
参考链接:
- Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery.
- Hacker News 讨论贴:Qwen 3.8 Omni Flash