2026年9月17日,PrismML 发布了 Ternary Bonsai 2 27B 模型,将拥有 270 亿参数的 Qwen3.8 27B 塞进了一张 8GB 显存的 RTX 3070 显卡里。总体积仅为 5.9GB 的权重包,在综合基准测试中跑出了全精度版本 98.2% 的成绩。PrismML 团队脱胎于加州理工学院,在 Khosla Ventures、Cerberus、Google 和三星的资金支持下,他们在模型压缩领域给出一份工程化答卷。这份答卷用数据划定了一条新边界:本地运行大模型的物理门槛已经转移,生态兼容性成为了部署的拦路虎。
5.9GB体积保留98.2%核心能力
Ternary Bonsai 2 27B 的核心压缩机制是三值权重配以 FP16 分组缩放。这种方案将每个权重的平均存储开销压缩到等效 1.76 比特,同时让语言模型端到端保持极低位表示。这是参数量级与物理内存占用的直接脱钩。模型体积相比全精度基座缩小了九倍以上,留给用户的可用上下文长度依然达到 262K token。
在综合基准得分上,Bonsai 2 27B 拿到 83.9 分,全精度基座模型 Qwen3.8 27B 为 85.4 分,上一代 Qwen3.6 27B 全精度版本是 83.6 分。牺牲九成体积换取跑分持平上一代全精度基座,这种资源交换在受限物理设备部署场景中有明确的工程价值。在具体指标里,Bonsai 2 27B 的 Agentic 与工具调用能力录得 77.57 分,基座为 79.74 分;编码能力 81.58 分,基座为 82.17 分。
该模型在部分指标上表现逆势。其指令遵循能力拿到 82.66 分,反超全精度版本的 81.25 分。视觉任务 78.59 分和知识推理 83.95 分有轻微下降。
纸面数字无法掩饰极限压缩导致的部分知识点丢失。在开发者社区高频测试的”背诵 Jabberwocky”语言挑战中,全精度的 bf16 版本勉强可以通关,该三值权重版本与 fp8 版本均出现明显的文本生成失败。开发者指出同一参数尺寸的两个不同量化版本,在部分私有测试集中表现落差高达 50%。工程跑分面板的平均分优秀,在高度依赖精准字符记忆的单点对抗性任务上却显得脆弱。
吞吐量对标与真实功耗账本
根据 PrismML 披露的实验室数据,该模型在 NVIDIA 旗舰计算卡 RTX 5090 上的吞吐量达到 143 token/s,在苹果高端芯片 M5 Max 上录得 46.8 token/s。跨越 CUDA 与 MLX 双计算架构平台的自研低位并行算子是支撑数字的基础。不同硬件平台的原生架构特性,设定了低比特推理算法在边缘设备上的每秒输出上限。
在能效控制和运行功耗方面,RTX 4090 跑满该模型给出的能耗记录为 0.714 mWh/token。研发团队指出这一功耗比运行全精度 8B 级别参数模型省电 40%。大参数模型在便携移动设备或受限电源环境下的全天候高频调用变为可能。
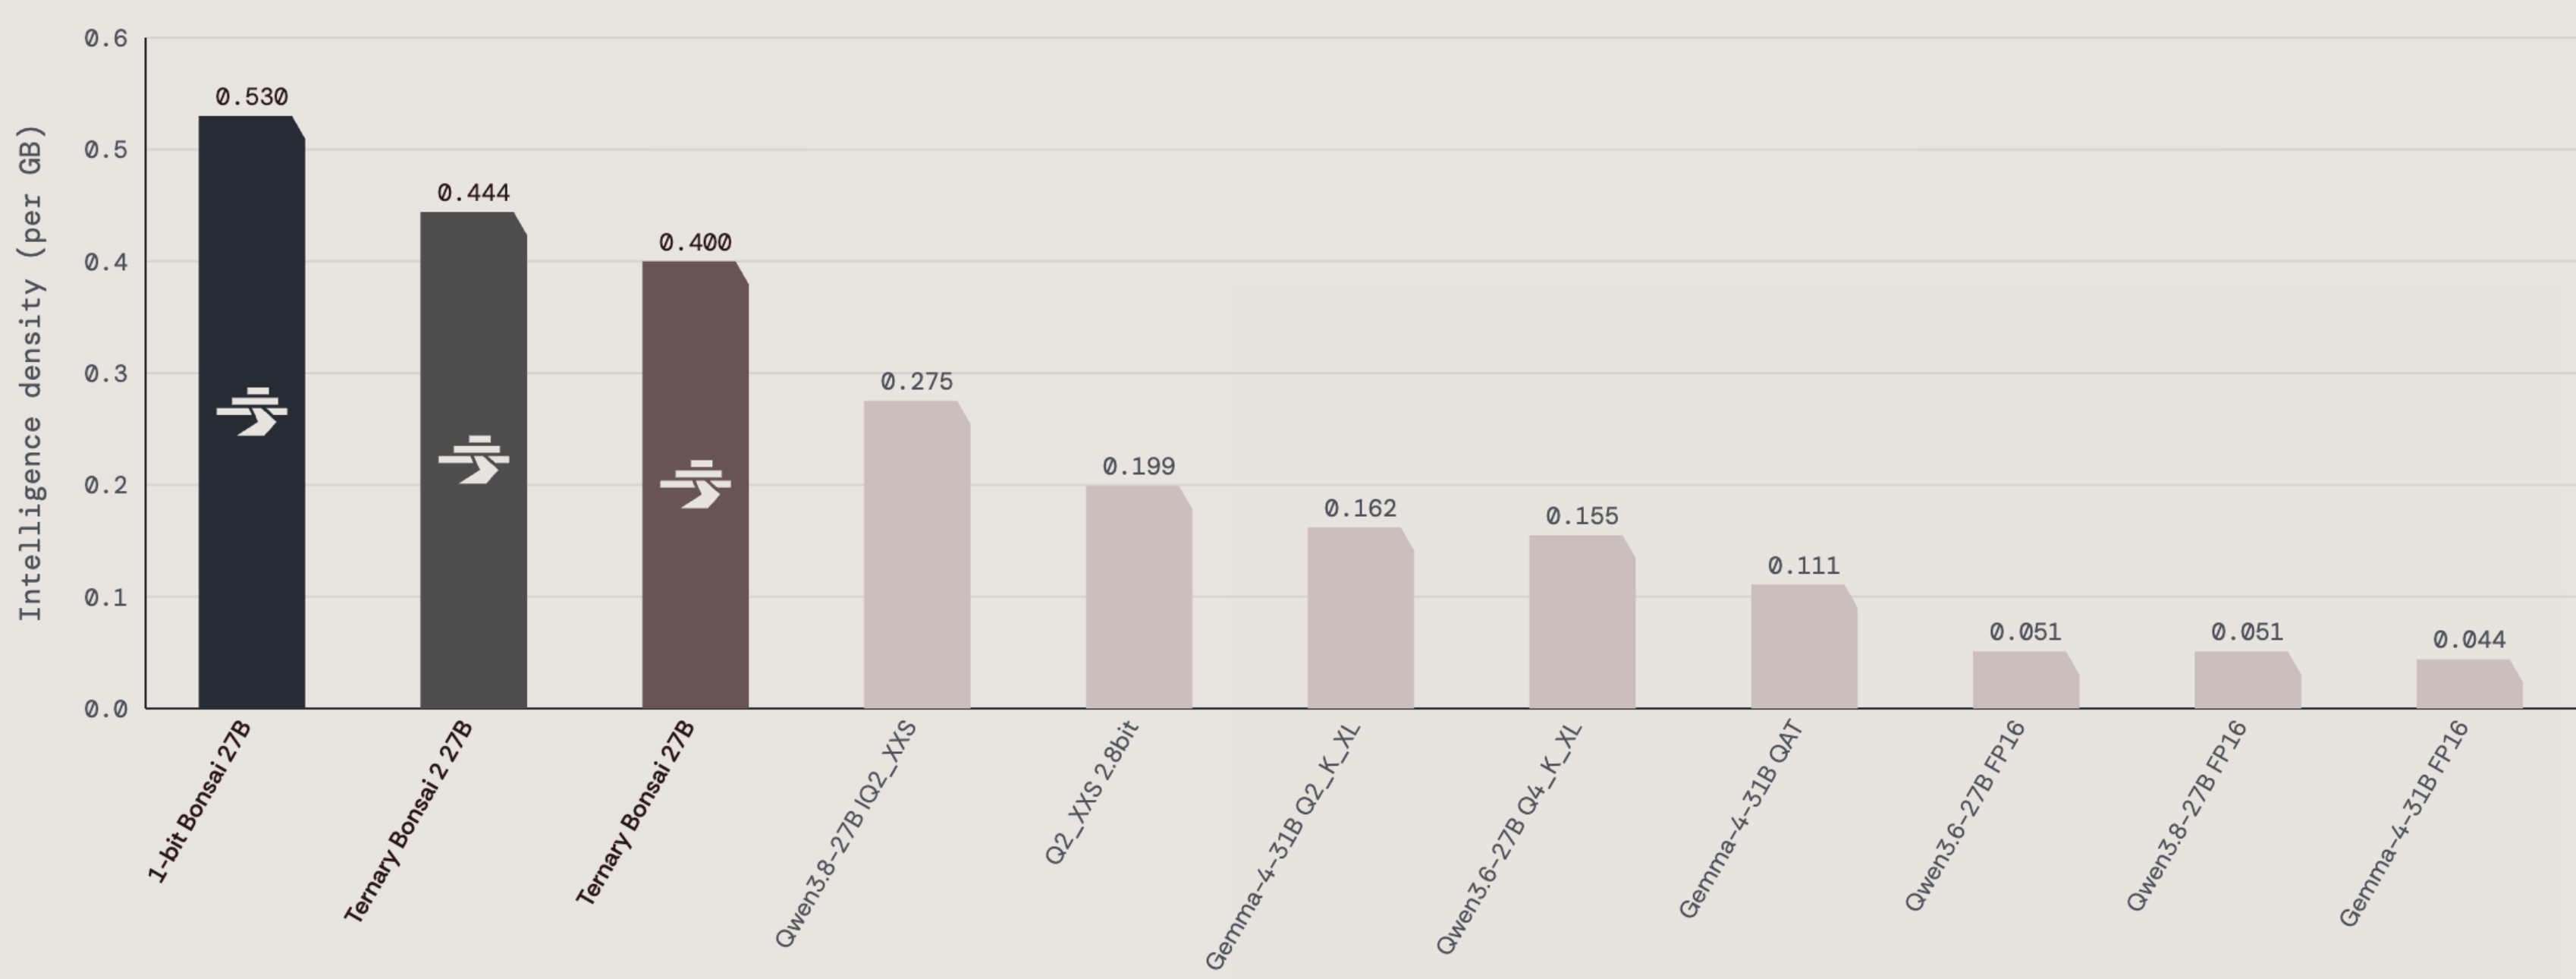 图:Bonsai 2 27B 与同参数级模型智能密度对比。来源:PrismML 官方博客
三星电子对该初创团队的持续战略投资逻辑在此显现。当移动端芯片的主板内存总线通讯带宽增长陷入停滞时,通过底层的算法降维切断显存海量搬运功耗,是智能手机系统集成商绕开硬件传输物理上限的高效路线。
生态脱节制造终端分发死结
存储空间的物理屏障被算法击穿,开源软件主干分支的组件兼容性迅速顶了上来。部署链条第一步就卡顿了。Hugging Face 上提供的 GGUF 权重文件,无法在主线版本 llama.cpp 核心框架中直接拉起。开发者必须强制指定拉取 PrismML 独立维护的特定分支,即带有 prism-b10685-7dffb15 标签的版本库。
外部代码提交者在技术论坛定位到了私有分支刚修复的适配错误。主线 llama.cpp 在启动探测阶段编译内部 matmul2d 计算内核直接报错,因为苹果 Metal 框架的 tensor 解析头文件硬性要求编程语言版本号达到 4.0。早期发布的 ggml-metal-device.m 遗漏了 MTLCompileOptions.languageVersion 的参数设置。微小的配置缺失切断了三值模型在所有 Mac 平台产品线上的硬件加速通道。
底层兼容修复动作直到私有分支继续提交了 49 个 commit 才被合并。官方说明文档与 release 标签、压缩包文件名之间,存在页面级的信息不同步。针对底层算子的激进优化不可避免衍生出平台特异性门槛。跨社区形成的代码隔离孤岛,拖慢了前沿算法向普通研发大众分发的速度。
实验室基准遭遇实测数字落差
在 Hacker News 社区的技术版块中,开发者 Simon Willison 给出了一组未经修饰的物理设备实测跑分数据。他使用该模型及其绑定的指定分支框架,尝试生成描述”骑自行车的鹈鹕”的矢量 SVG 图像代码,整个单次推理请求响应过程耗时达到 18 分 20 秒。
 图:PrismML 官方模型宣传图。来源:PrismML
在苹果 M1 Pro 笔记本设备上,有效的端侧生成吞吐速度录得 14.22 token/s。该测算数字大约只摸到官方公关稿件中基于定制 M5 Max 测试环境运算数字的三分之一。跑分表上的纸面性能指标与物理体感延迟时间之间,存在一道落差鸿沟。
依靠单一创业团队自研特定算子指令集来强行支撑运转的三值压缩体系,现阶段更像是一个只能放在无尘实验室玻璃罩下的精密仪器,在面对外部复杂碎片环境组合时容易频发兼容报错。
Ternary Bonsai 2 27B 用数据证明了 1.76 比特的压缩极限在数学和工程上都是可行的。它的商业瓶颈已经脱离算法验证范畴。当 270 亿参数的网络能被压缩进 5.9GB 且保住 98.2% 的能力分数时,本地部署的显存门槛已经退位。今天挡在极低比特模型普及道路前面的屏障,不再是塞不进硬盘的权重文件,而是未被上游开源项目合入的私有分支代码,以及跨硬件平台间直接暴降的体感落差。
参考链接:
- Ternary Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint
- Hacker News 讨论:Bonsai 2 27B