2026年9月17日,一个反常识的现象打破了算力焦虑的定式。当天,z.ai公开披露了他们在10万块以上中国产AI加速器组成的庞大集群上,从零搭出完整生产级推理服务的过程。不仅跑通了,目前GLM-5.3-Flash的全部生产推理流量都结结实实地承载在这套非英伟达体系的系统之上。最关键的是速度,从大模型在新硬件上第一次跑通,到能够稳定扛住生产环境的真实洪流,整个部署周期被压缩到了短短两周之内。
14天吞下62万亿真实请求
在正式向公众公开之前,GLM-5.3-Flash经历了一场满载压力测试。它披着Ox-Alpha的马甲,在OpenCode与OpenRouter两个开发者社区匿名上线。随后短短6天时间内,模型处理了超过62万亿个Token,瞬间登顶了两个平台的使用量榜单。这个庞大的并发数字,在最真实的业务场景里验出了国产基础设施的承载能力。
庞大的并发并没有让系统崩溃,反而逼出了底层硬件的巨大潜能。仅仅两周的调优期内,整个集群的端到端吞吐相对初始的基线标准提升了大约3倍。这种跃升让硬件利用效率发生质变,单Token的推理成本直接被拉到了与目前主流英伟达GPU架构相当的水平。成本结构的平齐表明,通过软件工程补齐生态短板之后,国产加速器同样能够在严苛的商业化逻辑里建立正向循环。
在这场大规模攻坚战中,发挥核心作用的是由GLM-5.3自身驱动的Infra Agent。模型自身直接下场,亲自参与构筑并持续优化了运行自己的物理基础设施环境。用强大的推理模型去修复底层的算力瓶颈,在10万块芯片的真实网络中变成了可以复现的工程操作。
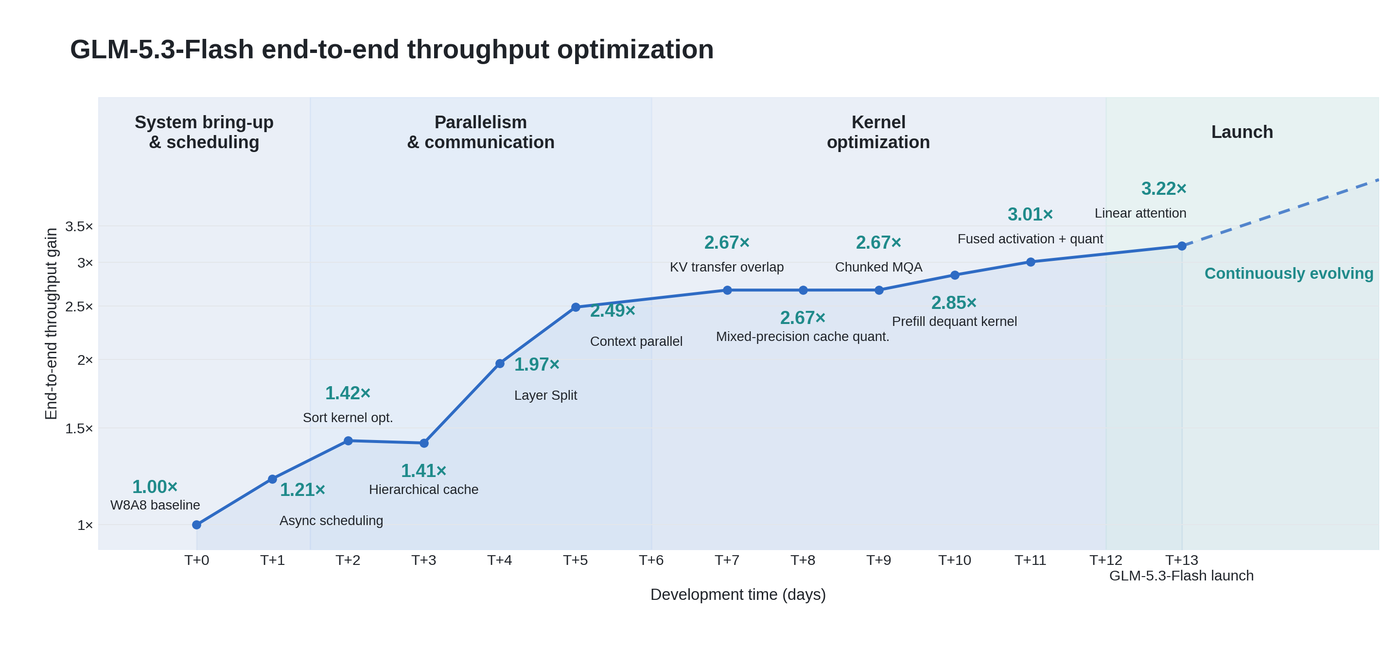 图:GLM-5.3-Flash 端到端吞吐演进曲线。来源:z.ai 官方博文
算法修补硬件容量天然缺陷
官方并未回避起步阶段恶劣的工程条件。这批用于组网的国产芯片在内存容量与数据带宽上有着明显的天然短板,与之配套的软件生态十分荒芜,系统内核层面的支持甚至充满漏洞。在很多关键的技术节点上,开发者亟需的底层文档全面缺失,团队只能依靠工程直觉进行猜测与繁复的逆向工程尝试。
为了跨越这些硬件层面的阻碍,基础设施团队堆叠了一套庞大的软件优化技术栈。他们在架构上激进地启用了线性注意力与LM Head的节点内张量并行机制,同时引入了ReplaySSM来控制状态。在降低内存占用方面,团队全面部署了W8A8量化策略,并结合INT8、FP8与BF16的混合精度KV Cache量化手段。最后配合Layer Split技术以及整体的Encode-Prefill-Decode分离架构,依靠细致的算力调度把计算损耗一点点挤压了出来。
这些看似繁冗的工程组合拳,目标全部指向了内存与带宽瓶颈的突围。当单张芯片的显存无法装下巨大的参数模型,当片间通讯的带宽物理上限锁死了数据交换速率,工程师选择用精细到微秒的底层切割与算力调度来进行弥补。算力基础设施的不成熟不仅没有压垮项目,反而倒逼出了一套脱离CUDA惯性依赖的解题思路。
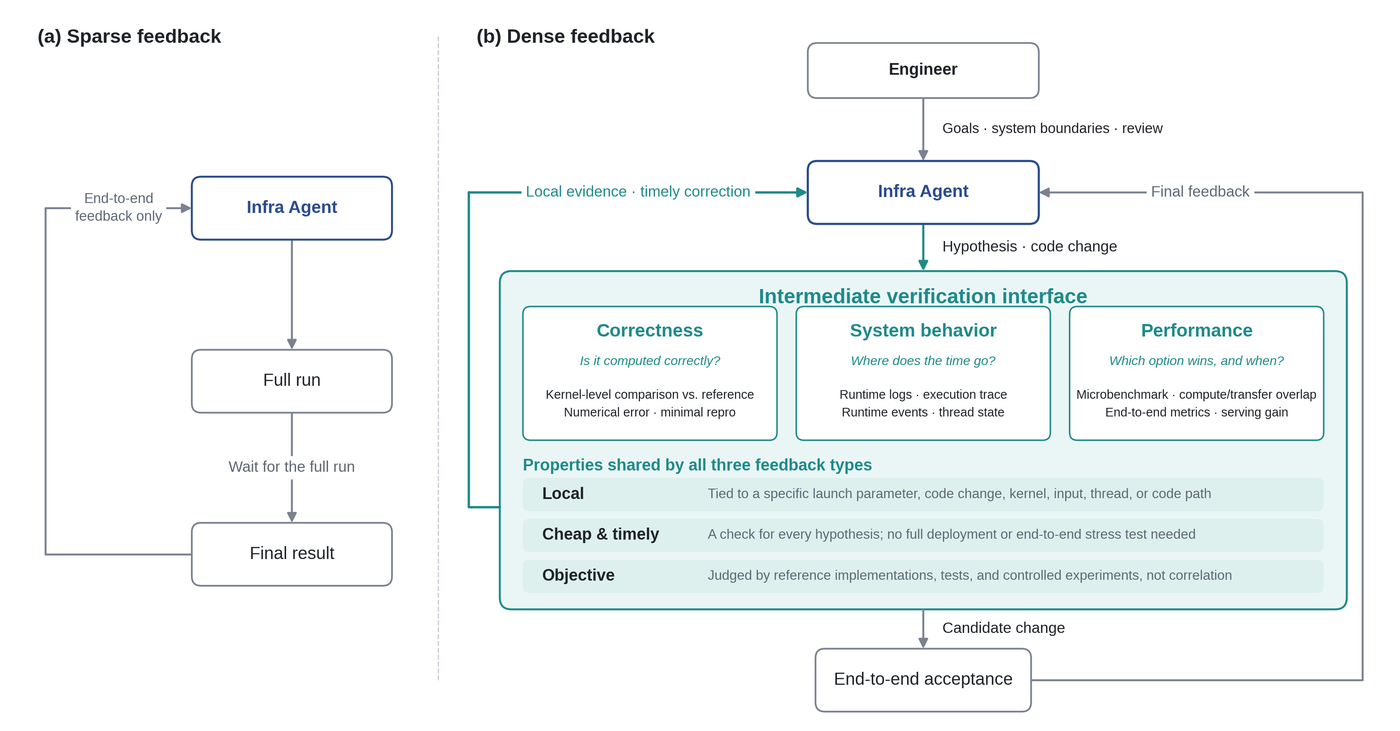 图:稠密反馈与优化循环示意。来源:z.ai 官方博文
切碎黑盒建立稠密反馈网络
能够在14天内完成底层代码重构,最大的支撑力量是一套被称为「稠密反馈」的核心方法论。在包含10万个异构节点的集群里进行系统调试,最令人恐惧的灾难就是性能发生不明原因劣化。把庞大系统里一句简单的报错,精准转化成「问题发生在哪一层、为什么会变差、下一步应该测什么」的可执行归因,构成了调优效率的基石。
为了穿透底层黑盒,优化团队确立了三条刚性的反馈机制原则。首要条件是系统反馈必须高度局部化。监控体系必须能够穿透硬件层,精准定位到具体执行的Kernel单元、特定的环境触发条件乃至微秒级的执行区间。巨型算力集群的不可预测性被拆分,化作一个个局部可知、可控的状态切片。
获取这些反馈的数据成本必须压到极低,且反馈链路必须足够短平快。凡是能够通过Kernel层级的单元测试或者本地微基准测试来解答的性能疑问,就坚决拦截在开发阶段,绝不推送到全量部署环境中试错。更重要的一点是,所有的优化动作必须具备可客观验证的属性。每一次底层代码变更都建立在严谨的对照实验之上,严禁仅凭运行时信号的表面关联性就草率推导调优结论。
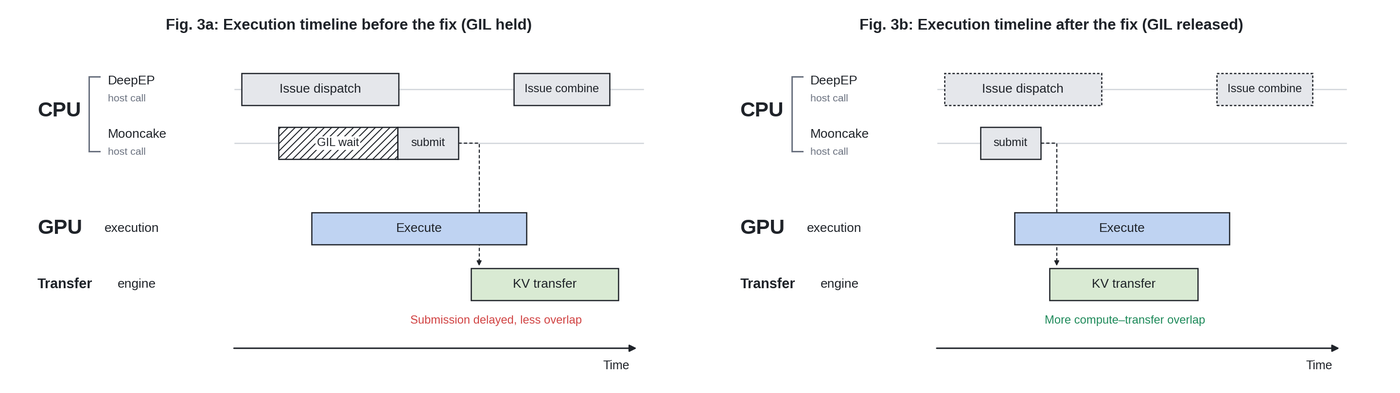 图:推理系统优化流程示意。来源:z.ai 官方博文
完美账面数据在实测中跌落
官方发布的长文中那条惊艳的吞吐演进曲线,并没有成功说服所有的技术实践者。在Hacker News社区多达数百条的激烈讨论中,明显呈现出严重的体验割裂。一部分从业者对如此庞大的国产集群在短时间内完成算力重构感到震动,另一部分开发者则拿着自己的接口调用日志,发起了针锋相对的数据反驳。
有真实环境下的用户反馈,在涉及复杂上下文的业务场景里,通过接口调用GLM的响应速度慢得惊人,且官方下发的并发限流策略异常严苛。当开发者试图让模型自动执行跨越整晚的长程推理任务时,系统往往连几个小时都撑不到,就会因为网络或算力配额问题引发报错中断。这种状况暴露出官方实验室环境下的测试基准数据,在面对复杂多变的真实网络波动以及边界条件时,不可避免地产生了体验落差。
技术社区的讨论甚至超越了代码层面,直接延伸到了对模型安全叙事的审视上。有评论者犀利指出,文中那种将AI描述得强大到具备某种自主危险性的论调,与他们在真实调用中感受到的脆弱服务能力大相径庭。同时,也有海外开发者发出了截然不同的追问:如果十万块基础素质落后的芯片,仅仅依靠算法创新和Agent调度就能摸到算力及格线,为什么手握充沛资金与顶配GPU的北美巨头团队,至今也没有做出同等量级的软硬件融合优化动作。
迭代速度重构硬件竞争基线
负责研发的架构团队将这一次以Agent为主导的工程实践,明确定义为递归自我改进的早期形态。模型本身开始具备阅读、理解、分析并动手修改承载其自身运行环境的基础设施代码的能力。团队保持了一定程度的克制,承认在这个自我迭代的过程中,选择具体的优化目标、划定代码修改边界以及评估潜在的安全风险,依然要由人类工程师来牢牢掌握主动权。
这套历经两周高压打磨的系统向整个行业传达了一个确定性的信号:「国产算力不行」这个长久以来的底层认知,今天起已经过期了一半。在内存容量捉襟见肘、数据通讯带宽毫无优势的弱势硬件平台上,研发团队靠着不断堆高反馈密度、将繁复的试错代码动作转交给大模型处理,最终把单Token的云端推理成本硬生生压到了主流GPU厂商的水平线上。
硬件生态的鸿沟不会因为一次两周的优化就消失,真正的变量是反馈颗粒度细化之后,从报错到修复的循环能压缩到多短。这套系统给出的是一个上限:在内存和带宽都不占优的芯片上,迭代速度可以部分替代硬件规格。能替代到什么程度,目前只有一家公司的两周数据可以参照。
参考链接:
- z.ai 官方博文
- HN 讨论