Le 17 septembre 2026, une annonce est venue bousculer les certitudes entourant la pénurie mondiale de puissance de calcul. z.ai a dévoilé en détail la manière dont l’équipe a bâti un service complet d’inférence en production, à partir de zéro, sur un cluster massif de plus de 100 000 accélérateurs d’IA fabriqués en Chine. Il ne s’agit pas d’un simple démonstrateur : la totalité du trafic d’inférence en production de GLM-5.3-Flash repose aujourd’hui sur cette infrastructure non-NVIDIA. Le plus frappant réside dans la vitesse d’exécution : entre la première exécution réussie sur ce matériel inédit et l’absorption stable de la charge réelle en production, le cycle complet d’ingénierie a été ramené à deux petites semaines.
62 000 milliards de tokens réels traités en 14 jours
Avant d’être officiellement dévoilé au public, GLM-5.3-Flash a traversé une éprouvante phase de test de résistance en charge maximale. Déployé sous le pseudonyme « Ox-Alpha », le modèle a été mis en ligne de manière anonyme sur deux plateformes de développement de premier plan : OpenCode et OpenRouter. En seulement six jours, il a traité plus de 62 000 milliards de tokens, s’emparant instantanément de la première place des classements d’utilisation sur les deux services. Ce volume d’appels simultanés a constitué un banc d’essai impitoyable pour mesurer la robustesse de l’infrastructure matérielle chinoise face à des charges opérationnelles authentiques.
Loin d’effondrer le système, cette charge massive a révélé le potentiel latent du matériel sous-jacent. En seulement deux semaines de réglages intensifs, le débit de bout en bout de l’ensemble du cluster a été multiplié par environ 3 par rapport à la référence initiale. Ce saut d’efficacité a bouleversé l’utilisation du matériel, ramenant le coût d’inférence par token à un niveau parfaitement comparable à celui des architectures GPU modernes de NVIDIA. Cet alignement des coûts prouve qu’en compensant les lacunes de l’écosystème par un travail d’ingénierie logicielle rigoureux, des puces non-NVIDIA peuvent s’inscrire dans une logique commerciale pérenne et rentable.
Le véritable catalyseur de cette percée a été un agent d’infrastructure (« Infra Agent ») piloté directement par GLM-5.3. Le modèle s’est impliqué lui-même sur le terrain, participant activement à la construction, au débogage et à l’optimisation continue de l’environnement physique qui assure sa propre exécution. L’usage d’un modèle de raisonnement de pointe pour éliminer méthodiquement les goulets d’étranglement de bas niveau s’est ainsi transformé en une pratique d’ingénierie reproductible sur un réseau de 100 000 puces.
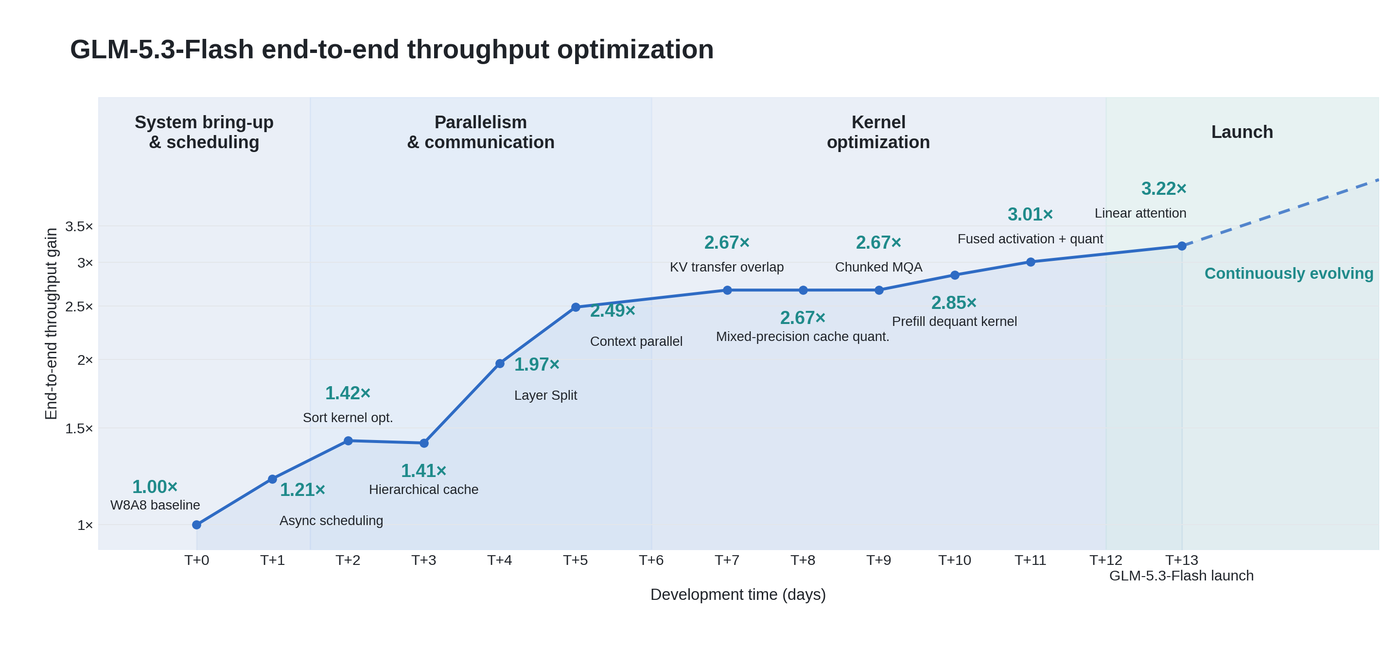 Figure : Évolution du débit de bout en bout de GLM-5.3-Flash. Source : blog officiel de z.ai
Le génie algorithmique face aux contraintes physiques du silicium
L’équipe d’ingénieurs n’a pas cherché à dissimuler l’austérité des conditions initiales. Les accélérateurs utilisés souffraient de limites physiques nettes en matière de capacité mémoire et de bande passante inter-puces. De surcroît, l’écosystème logiciel associé était quasi embryonnaire et le support des pilotes au niveau du noyau truffé d’anomalies. À plusieurs étapes architecturales décisives, la documentation de bas niveau indispensable aux développeurs faisait totalement défaut, contraignant l’équipe à s’appuyer sur son intuition technique, des hypothèses empiriques et un travail fastidieux de rétro-ingénierie.
Pour surmonter ces obstacles matériels, l’équipe d’infrastructure a déployé une imposante suite d’optimisations logicielles. Sur le plan architectural, ils ont mis en œuvre un parallélisme tensoriel intra-nœud pour l’attention linéaire (Linear Attention) et la tête LM (LM Head), tout en introduisant ReplaySSM pour maîtriser les états internes. Côté mémoire, une politique de quantification W8A8 a été généralisée, associée à une quantification de cache KV à précision mixte combinant INT8, FP8 et BF16. Enfin, grâce à des techniques de découpage par couches (Layer Split) et à une architecture désagrégée Encode-Prefill-Decode (EPD), un ordonnancement chirurgical a permis d’extirper les pertes de calcul cycle après cycle.
Cet ensemble de techniques visait prioritairement à contourner l’engorgement de la mémoire et de la bande passante. Quand la mémoire vidéo d’une puce ne peut contenir l’intégralité d’un modèle gigantesque et que les limites physiques des interconnexions plafonnent les débits de transfert, les ingénieurs ont compensé par un découpage temporel à la microseconde et une planification rigoureuse du calcul. L’immaturité de l’infrastructure matérielle, loin de faire échouer le projet, a au contraire forcé l’émergence d’une démarche d’ingénierie affranchie des réflexes du monde CUDA.
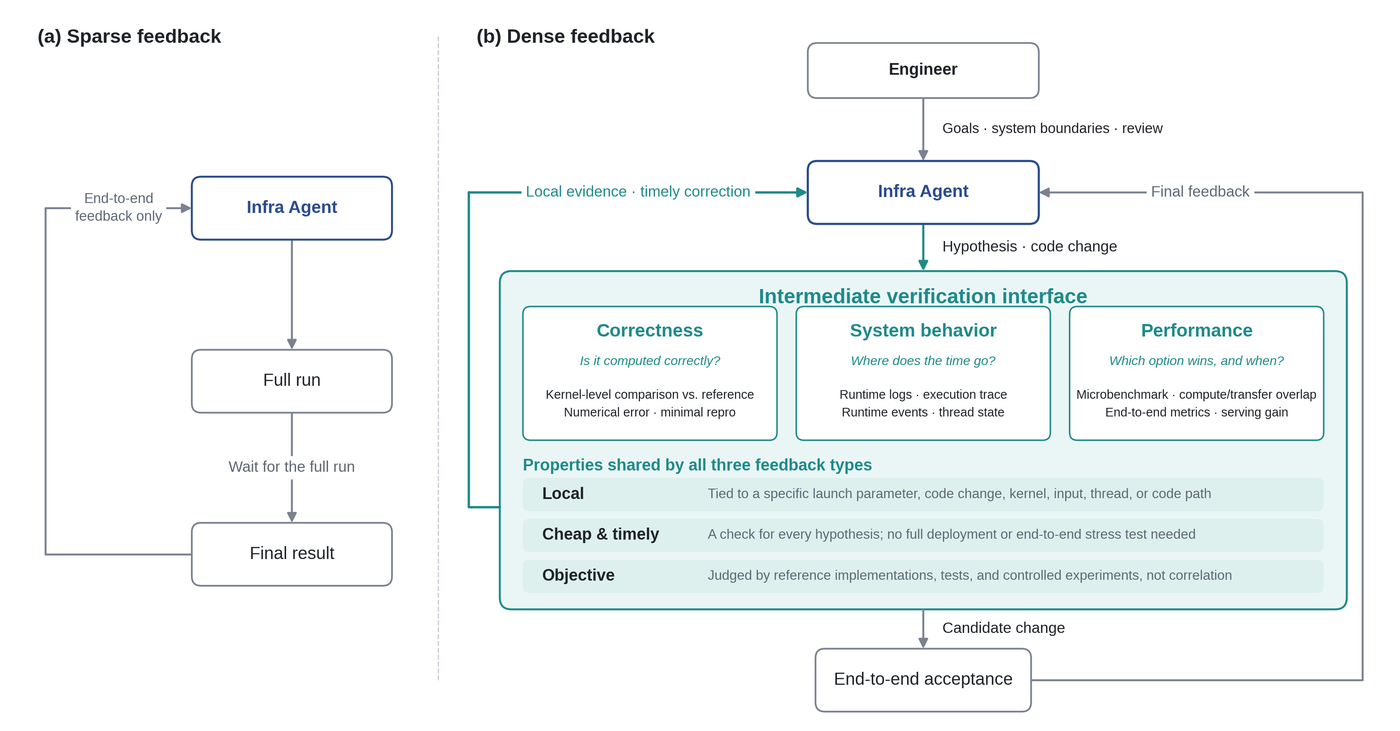 Figure : Boucle d’optimisation de l’Infra Agent articulée autour d’une rétroaction dense. Source : blog officiel de z.ai
Percer la boîte noire grâce à des boucles de rétroaction denses
Parvenir à refondre le code source de bas niveau en seulement 14 jours a reposé sur une méthode centrale : la « rétroaction dense » (Dense Feedback). Lors du débogage d’un cluster hétérogène de 100 000 nœuds, le pire fléau réside dans les dégradations inexpliquées de performances. Convertir une erreur système nébuleuse en une cause immédiatement exploitable — savoir exactement sur quelle couche le problème survient, pourquoi la latence augmente et quel test exécuter ensuite — est devenu la clé de voûte de la vitesse d’optimisation.
Pour dissiper l’opacité de la boîte noire, l’équipe a fixé trois règles d’or en matière de rétroaction. En premier lieu, la rétroaction devait être hautement localisée. Le système de supervision devait pénétrer la couche matérielle afin d’isoler l’exécution d’un noyau précis, les conditions environnementales déclencheuses et des fenêtres temporelles de l’ordre de la microseconde. L’imprévisibilité d’un cluster géant a ainsi été découpée en tranches d’état locales, observables et maîtrisables.
En deuxième lieu, le coût d’acquisition de cette rétroaction devait être minime et son circuit extrêmement rapide. Chaque hypothèse pouvant être validée par des tests unitaires au niveau du kernel ou par des micro-benchmarks locaux était traitée dès la phase de développement, sans jamais polluer l’environnement de production global par des essais hasardeux. En troisième lieu, toute action d’optimisation devait être vérifiable de manière objective. Chaque modification du code de bas niveau reposait sur des tests comparatifs stricts, excluant toute déduction hâtive fondée sur de simples corrélations observées à l’exécution.
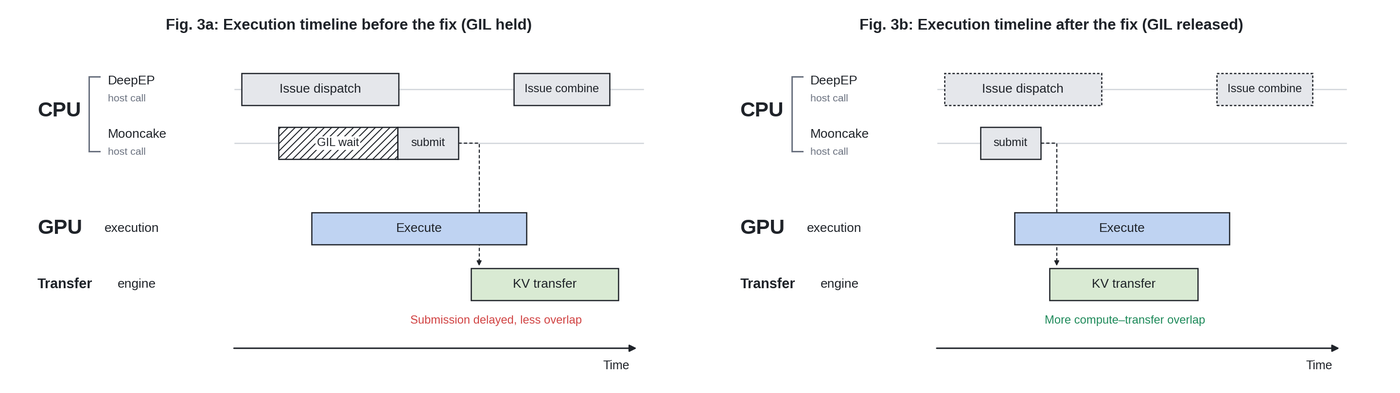 Figure : Schéma du processus d’optimisation du système d’inférence. Source : blog officiel de z.ai
Des métriques idéales tempérées par l’épreuve du terrain
La trajectoire spectaculaire mise en avant dans la publication officielle n’a toutefois pas convaincu l’ensemble des praticiens de terrain. Sur Hacker News, plusieurs centaines de commentaires ont révélé une fracture sensible dans les retours d’expérience. Si une fraction de la communauté technique s’est déclarée impressionnée par la restructuration expéditive d’un cluster d’une telle ampleur, d’autres développeurs ont opposé leurs propres journaux d’appels API pour nuancer les déclarations de l’éditeur.
Plusieurs utilisateurs ont ainsi rapporté que, dans des scénarios impliquant des contextes longs et complexes, la latence des réponses de l’API GLM demeurait très élevée, assortie de limites de requêtes simultanées particulièrement strictes. Des développeurs ayant tenté de faire tourner des tâches autonomes nocturnes ont vu leurs processus s’interrompre au bout de quelques heures à cause d’erreurs réseau ou de quotas dépassés. Cet écart illustre la frontière tenace qui sépare les bancs d’essai en laboratoire des aléas inhérents aux réseaux mondiaux et aux charges réelles imprévisibles.
Le débat a rapidement dépassé le cadre de l’ingénierie système pour interroger le discours sur la sécurité et l’autonomie de l’IA. Des observateurs ont souligné le décalage entre la dramatisation d’une IA décrite comme acquérant une puissance potentiellement incontrôlable et la fragilité pratique des services observée lors des appels API. Dans le même temps, des ingénieurs étrangers ont formulé une interrogation stimulante : si 100 000 puces aux spécifications modestes parviennent au seuil de viabilité grâce à la seule ingéniosité logicielle et à l’automatisation par agents, pourquoi les géants occidentaux, dotés de financements massifs et des meilleurs GPU du marché, n’ont-ils pas démontré d’optimisations matérielles-logicielles d’une ampleur équivalente ?
La vélocité d’itération redéfinit la compétition matérielle
L’équipe d’architecture responsable du projet a explicitement qualifié cette approche pilotée par agents de prémices d’une amélioration récursive autonome (Recursive Self-Improvement ou RSI). Le modèle commence à faire preuve de dispositions pour lire, comprendre, analyser et corriger le code de l’infrastructure qui supporte sa propre exécution. L’équipe a néanmoins gardé une posture mesurée, rappelant que la sélection des objectifs d’optimisation, la définition des périmètres de modification du code et l’évaluation des risques de sécurité doivent impérativement demeurer sous le contrôle des ingénieurs humains.
Le système forgé durant ces deux semaines intenses transmet un signal sans équivoque à l’industrie : l’affirmation récurrente selon laquelle « les puces chinoises ne valent rien en production » a perdu l’essentiel de sa pertinence. Sur une plateforme matérielle handicapée par une mémoire restreinte et des interconnexions plus modestes, l’équipe a su maximiser la densité de rétroaction et confier l’ingrat travail d’essais-erreurs au modèle lui-même, amenant le coût d’inférence par token au coude-à-coude avec les leaders du marché des GPU.
Le fossé qui sépare les écosystèmes matériels ne disparaîtra pas en un sprint de quinze jours. La véritable variable réside dans la vitesse à laquelle la boucle reliant la détection d’une anomalie à la correction du noyau peut être raccourcie dès lors que la granularité de la rétroaction devient microscopique. Cette réalisation fixe un plafond : sur des puces aux ressources mémoire et bande passante limitées, la vélocité d’itération peut pallier en partie les faiblesses des spécifications brutes du matériel. Jusqu’où cette compensation peut-elle opérer ? Pour l’instant, les données recueillies en deux semaines par une seule entreprise constituent le seul repère disponible.
Liens de référence :