2026年9月17日、世界的なコンピュート枯渇の常識を覆す発表が行われた。z.aiは、10万基以上の中国産AIアクセラレータで構成された巨大クラスタ上で、完全な本番運用向け推論サービスをゼロから構築したプロセスを公開した。単なる動作実証にとどまらず、現在GLM-5.3-Flashのすべての本番推論トラフィックが、この非NVIDIA系システム上で安定稼働している。最大の衝撃はそのスピードにある。新ハードウェア上での初回実行成功から、過酷な本番トラフィックを安定して処理できるようになるまでの全展開期間が、わずか2週間に短縮されたのだ。
14日間で62兆トークンの実リクエストを処理
正式発表に先立ち、GLM-5.3-Flashは過酷な全負荷ストレステストを経験した。「Ox-Alpha」というコードネームのもと、開発者コミュニティであるOpenCodeとOpenRouterの両プラットフォームで匿名公開されたのだ。公開からわずか6日間のうちに、モデルは62兆トークンを超えるリクエストを処理し、両サービスの使用量ランキングで即座に首位を獲得した。この膨大な同時実行トラフィックこそが、最もリアルな本番環境において国産インフラの堅牢性を証明する試金石となった。
大規模な負荷集中はシステムをダウンさせるどころか、基盤ハードウェアの潜在能力を極限まで引き出す契機となった。わずか2週間のチューニング期間で、クラスタ全体のエンドツーエンドスループットは初期ベースライン比で約3倍に急伸した。この飛躍によりハードウェアの利用効率は劇的に改善され、トークンあたりの推論コストは現行の主流なNVIDIA GPUアーキテクチャと同等の水準にまで引き下げられた。コスト構造の対等化は、ソフトウェアエンジニアリングによってエコシステムの遅れを補完すれば、非NVIDIAアクセラレータでも過酷な商業的競争の中で自立的な好循環を確立できることを明確に示している。
この迅速なブレークスルーで中心的な役割を果たしたのが、GLM-5.3自身によって駆動される「Infra Agent」である。モデル自身が現場に介入し、自らが稼働する物理インフラ環境の構築、デバッグ、継続的最適化を直接担った。高度な推論モデルを活用して低レベルのコンピュートボトルネックを系統的に解消する手法は、10万基規模のハードウェア網において再現可能な実用エンジニアリングへと昇華された。
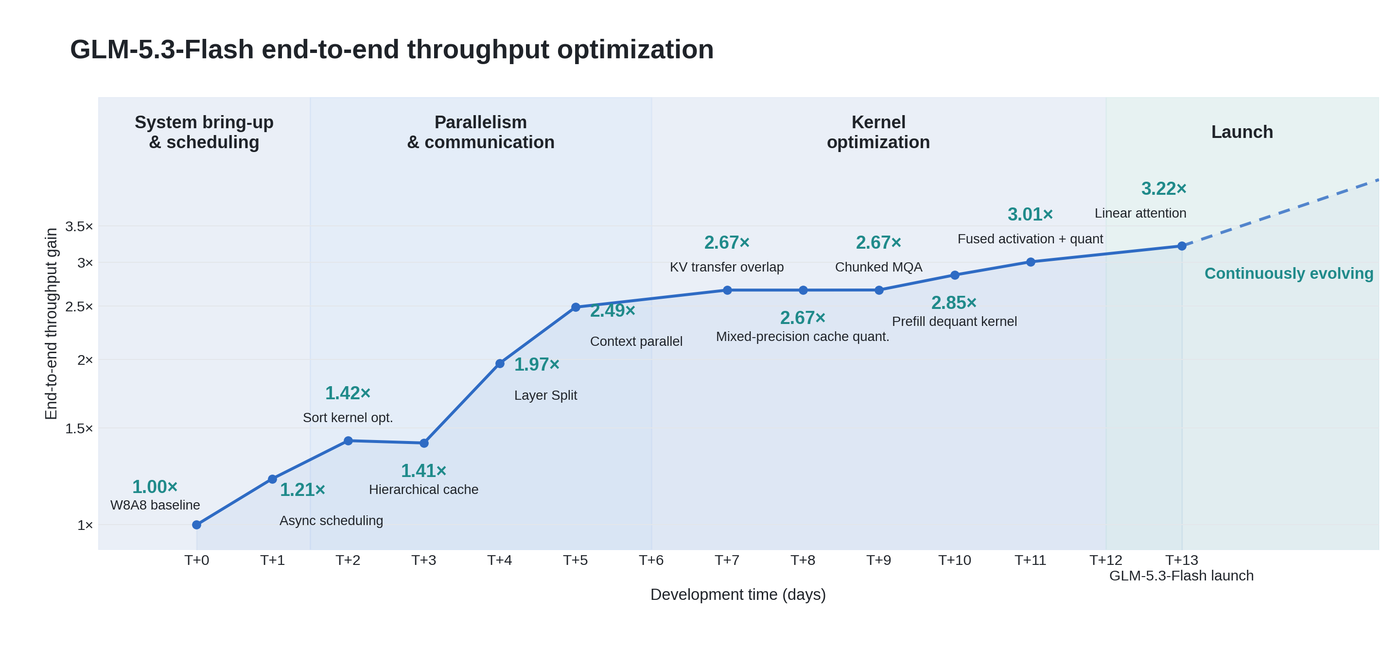 図:GLM-5.3-Flashのエンドツーエンドスループット推移。出典:z.ai公式ブログ
ハードウェアの制約をアルゴリズムとエンジニアリングで克服
開発チームは、立ち上げ当初の過酷なエンジニアリング環境を率直に認めている。クラスタを構成する国産チップは、メモリ容量とチップ間帯域幅において物理的な制約を抱えていた。さらに、ソフトウェアエコシステムは極めて未成熟で、カーネルレベルのドライバサポートには多数の不具合が潜んでいた。多くの重要な技術ノードにおいて開発者が切望する低レベルドキュメントは完全に欠落しており、チームは工学的直感による推測と泥臭いリバースエンジニアリングに頼らざるを得なかった。
こうしたハードウェアの障壁を乗り越えるため、インフラチームは重層的なソフトウェア最適化スタックを構築した。アーキテクチャ面では、線形アテンション(Linear Attention)とLM Headに対してノード内テンソル並列化を果敢に適用し、内部状態を制御するためにReplaySSMを導入した。メモリフットプリントの削減に向けては、W8A8量子化を全面展開し、INT8、FP8、BF16を組み合わせた混合精度KV Cache量子化を実装した。さらにLayer Split技術とEncode-Prefill-Decode(EPD)分離アーキテクチャを組み合わせることで、極限まで細粒度化されたスケジューリングにより計算オーバーヘッドを削ぎ落としていった。
これら一連のエンジニアリング施策は、すべてメモリと帯域のボトルネックを突破することを狙いとしている。1基のチップのVRAMに巨大なモデルパラメータが収まらず、チップ間通信の物理上限がデータ転送速度を縛る中、エンジニアたちはマイクロ秒単位の実行分割と精密な計算スケジューリングでハードウェアの限界を補った。インフラの未成熟さはプロジェクトを頓挫させるどころか、CUDA前提の思考様式から完全に脱却した問題解決アプローチを逆説的に生み出す原動力となった。
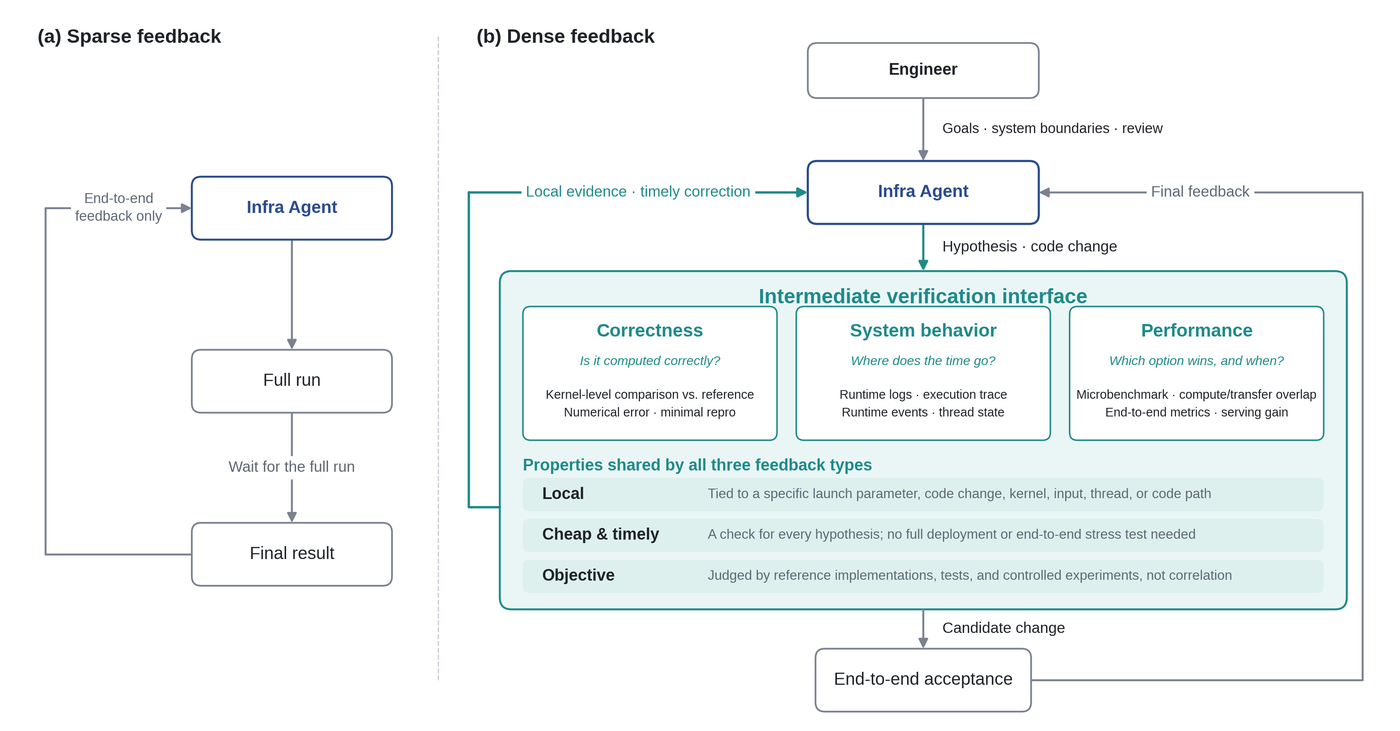 図:高密度フィードバックを中心に構築されたInfra Agent最適化ループ。出典:z.ai公式ブログ
ブラックボックスを解体し高密度フィードバック網を構築
14日間という極限の短期間で低レベルコードの再構築を成し遂げた最大の武器は、「高密度フィードバック(Dense Feedback)」と呼ばれる中核手法である。10万基の異種ノードからなるクラスタでシステムデバッグを行う際、最も致命的な災厄は原因不明のパフォーマンス劣化である。大規模システムから吐き出される漠然としたエラーを、「どのレイヤーで問題が生じたのか」「なぜ劣化したのか」「次に何をテストすべきか」という実行可能な帰因に迅速に落とし込むことが、チューニング速度の生命線となった。
ブラックボックスを切り崩すため、最適化チームは3つの厳格なフィードバック原則を定めた。第1に、フィードバックは高度に局所的でなければならない。監視システムはハードウェア層を透過し、実行された特定のカーネルユニット、特定の環境トリガー条件、さらにはマイクロ秒単位の実行区間まで正確に特定できなければならない。巨大な計算クラスタの不確実性は解体され、局所的かつ観測・制御可能な状態スライスへと変換された。
第2に、フィードバック取得のコストは極小化され、フィードバックループは迅速でなければならない。カーネルレベルのユニットテストやローカルマイクロベンチマークで検証可能な疑問は開発段階で徹底的に解決し、決してクラスタ全体の本番環境に無駄な試行錯誤を持ち込まない。第3に、すべての最適化アクションは客観的に検証可能でなければならない。低レベルコードの修正は常に厳密な対照実験に基づいて行われ、実行時シグナルの表面的な相関関係だけで推論チューニングの結論を下すことは固く禁じられた。
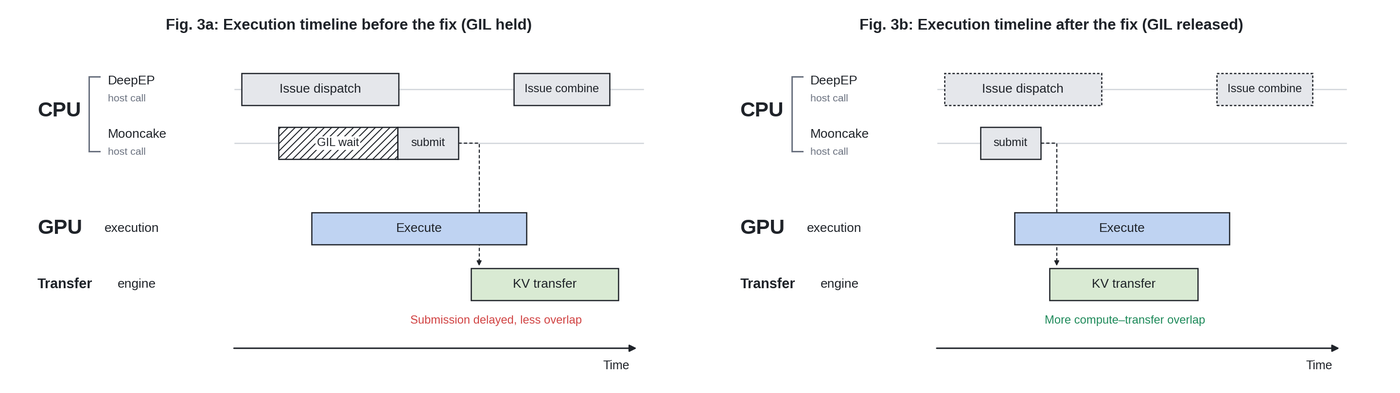 図:推論システム最適化プロセスの概要。出典:z.ai公式ブログ
華々しいベンチマークと実測での乖離:開発者の冷ややかな視線
公式ブログで公開された鮮やかなスループット向上曲線は、現場の開発者全員を納得させたわけではなかった。Hacker Newsでは数百件に及ぶ白熱した議論が巻き起こり、ユーザー体験の激しい温度差が浮き彫りとなった。これほど大規模な独自クラスタを短期間で再構築した成果に驚嘆する声がある一方で、自身が取得したAPIレイテンシログを提示し、公式発表のデータに鋭い疑問を投げかける開発者も現れた。
本番環境のユーザーからは、複雑な長文脈シナリオにおいてGLMのAPI応答速度が非常に遅く、厳しい同時実行レートリミットが課されているという報告が相次いだ。夜間に長時間の自動推論タスクを実行しようとした開発者は、ネットワークの不安定さや割り当て制限によって数時間でジョブが停止してしまうと不満を漏らした。この状況は、統制された実験室環境で得られたベンチマークと、過酷かつ流動的な現実のネットワーク環境との間に横たわるギャップを露呈させた。
議論はシステム実装の域を超え、AIモデルの安全性や自律性をめぐる言説への疑問にまで波及した。記事内でAIが自律的で危険な領域に踏み込んでいるかのように描かれていることに対し、実際のAPI利用で感じるサービスの脆弱さとは乖離しているという辛口な指摘もなされた。同時に、海外の開発者からは別の角度からの問いかけも上がった。もし10万基の劣勢なチップが、アルゴリズムの工夫とエージェントによる自動化だけで実用基準に達したのだとすれば、莫大な資金と最先端GPUを握る欧米の巨大テック企業は、なぜ同水準のハード・ソフト協調最適化を打ち出せていないのかという疑問である。
イテレーション速度が塗り替えるハードウェア競争の基準線
開発を担ったアーキテクチャチームは、今回の一連のエージェント主導エンジニアリングを「再帰的自己改善(Recursive Self-Improvement: RSI)」の初期形態と明確に位置づけている。モデル自身が自らの実行環境を支えるインフラコードを読み解き、分析し、自らの手で書き換える能力を獲得し始めたのだ。ただしチームは過度な誇張を避け、具体的な最適化目標の設定、コード変更の境界線の画定、潜在的な安全リスクの評価においては、依然として人間のエンジニアが主導権を握り続けるべきだと強調している。
2週間の高圧下で鍛え上げられたこのシステムは、業界全体に一つの明確なシグナルを発信した。「国産アクセラレータは実用に耐えない」という長年の通念は、今日をもって半分過去のものとなった。メモリ容量が逼迫し通信帯域で劣るプラットフォームであっても、フィードバックの密度を徹底的に高め、過酷な試行錯誤をLLMに肩代わりさせることで、クラウド推論コストを主流GPUベンダーの水準まで引き下げることができた。
ハードウェアのエコシステム格差が、2週間の集中開発だけで完全に埋まるわけではない。真の変数は、フィードバックの粒度を極限まで細分化したとき、エラー検知からカーネル修復までのサイクルをどこまで短縮できるかにある。今回の事例が示したのは、メモリや帯域が劣るチップであっても、イテレーションの速度によってハードウェア仕様の不利を部分的に代替できるという事実である。その代替がどこまで通用するのか、現時点では一社が示した2週間のデータがその唯一の指針である。
参考リンク: