El 17 de septiembre de 2026, una noticia vino a desafiar las certezas establecidas sobre la escasez global de potencia de cómputo. z.ai reveló públicamente cómo construyó un servicio completo de inferencia a nivel de producción desde cero sobre un macroclúster compuesto por más de 100.000 aceleradores de IA de fabricación china. No se trata de una prueba de concepto: en la actualidad, la totalidad del tráfico de inferencia en producción de GLM-5.3-Flash se ejecuta sobre esta infraestructura ajena al ecosistema de NVIDIA. Lo más llamativo es el ritmo de despliegue: desde la primera ejecución exitosa del modelo en el nuevo hardware hasta resistir de forma estable los flujos de tráfico real de producción, todo el ciclo de ingeniería se redujo a escasas dos semanas.
62 billones de tokens reales procesados en 14 días
Antes de su presentación formal ante el público, GLM-5.3-Flash se sometió a una exigente prueba de esfuerzo a plena carga. Bajo el seudónimo «Ox-Alpha», el modelo se desplegó de forma anónima en dos destacadas plataformas para desarrolladores: OpenCode y OpenRouter. En tan solo seis días, procesó más de 62 billones de tokens, situándose de inmediato en el primer puesto de uso en ambas comunidades. Este colosal volumen de peticiones simultáneas puso a prueba la capacidad real de la infraestructura nacional en condiciones operativas auténticas.
Lejos de colapsar la plataforma, la elevada concurrencia permitió aflorar el notable potencial latente del hardware. En un plazo de ajuste de apenas dos semanas, el rendimiento de extremo a extremo del clúster se multiplicó por tres respecto a la línea base inicial. Este salto cualitativo transformó la eficiencia de uso de los componentes, situando el coste de inferencia por token en un nivel plenamente equiparable al de las arquitecturas de GPU más avanzadas de NVIDIA. La paridad en la estructura de costes demuestra que, cuando el software compensa las carencias del ecosistema, los aceleradores no dependientes de NVIDIA pueden articular un ciclo comercial viable y competitivo.
El motor fundamental de este avance fue el denominado «Infra Agent», impulsado por el propio GLM-5.3. El modelo intervino de forma directa en el proceso técnico, asumiendo la construcción, depuración y optimización continua del entorno físico en el que opera. Utilizar un modelo de razonamiento de frontera para subsanar los cuellos de botella del cómputo de bajo nivel se convirtió en una metodología de ingeniería plenamente reproducible en una red de 100.000 chips.
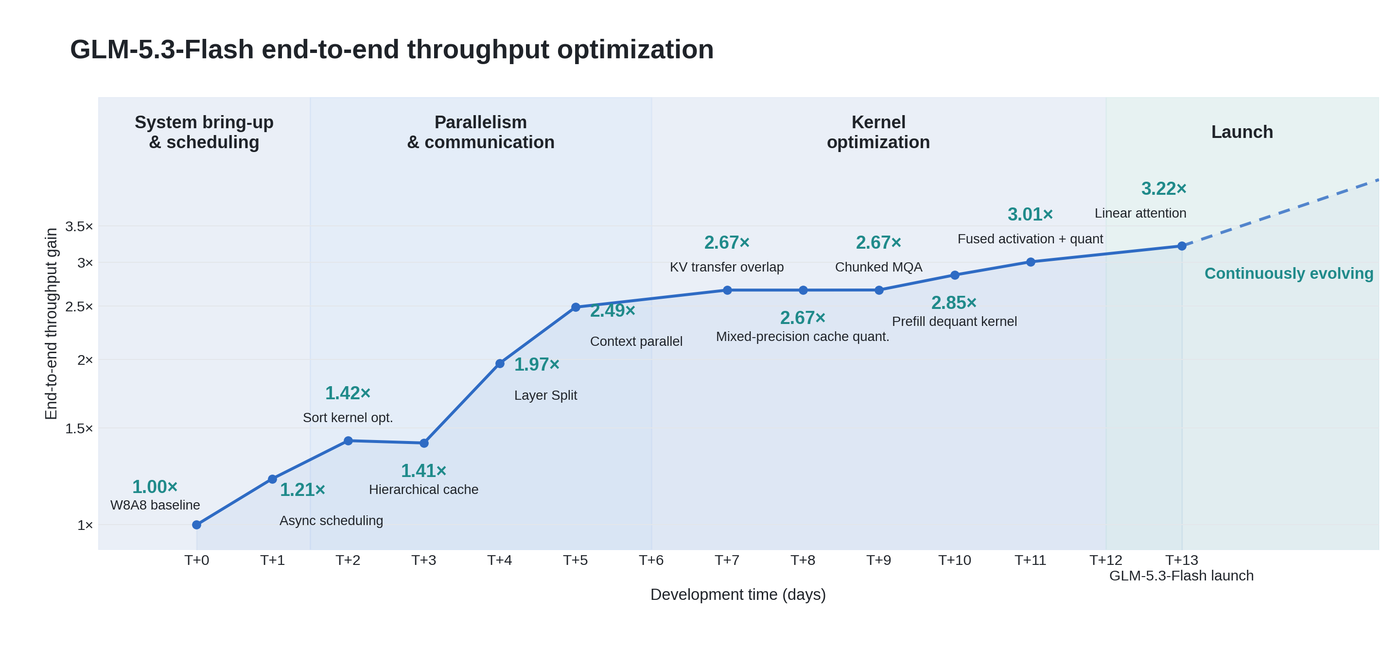 Figura: Curva de evolución del rendimiento de extremo a extremo de GLM-5.3-Flash. Fuente: blog oficial de z.ai
La ingeniería algorítmica supera las limitaciones del hardware
El equipo de ingenieros no ocultó la crudeza de las condiciones de partida. Los chips utilizados presentaban severas limitaciones de fábrica tanto en capacidad de memoria como en ancho de banda para la comunicación interchip. Además, el ecosistema de software complementario era sumamente rudimentario y el soporte de controladores a nivel de kernel albergaba numerosos errores. En puntos críticos de la arquitectura faltaba por completo la documentación técnica indispensable, lo que obligó a los desarrolladores a apoyarse en la intuición profesional, conjeturas fundamentadas y complejas labores de ingeniería inversa.
Para superar estas barreras físicas, el equipo de infraestructura implementó una ambiciosa pila de optimización de software. A nivel de arquitectura, aplicaron paralelismo tensorial dentro del nodo para la atención lineal (Linear Attention) y el LM Head, al tiempo que integraron ReplaySSM para controlar los estados internos. Con el objetivo de reducir la huella de memoria, desplegaron cuantización W8A8 en combinación con técnicas de cuantización de precisión mixta (INT8, FP8 y BF16) para la KV Cache. Finalmente, gracias a la división por capas (Layer Split) y a una arquitectura desagregada de Encode-Prefill-Decode (EPD), la meticulosa planificación de los recursos redujo al mínimo las pérdidas de computación en cada ciclo de reloj.
Este compendio de soluciones técnicas apuntaba directamente a romper el estrangulamiento de la memoria y el ancho de banda. Cuando la memoria de vídeo de un solo chip no alcanza para albergar modelos con parámetros gigantescos y los límites físicos de interconexión frenan la tasa de transferencia, los ingenieros recurrieron a la microsegmentación temporal y a una planificación rigurosa de las operaciones. En lugar de hacer fracasar el proyecto, la inmadurez de la infraestructura forzó el nacimiento de un enfoque analítico emancipado de la dependencia habitual de CUDA.
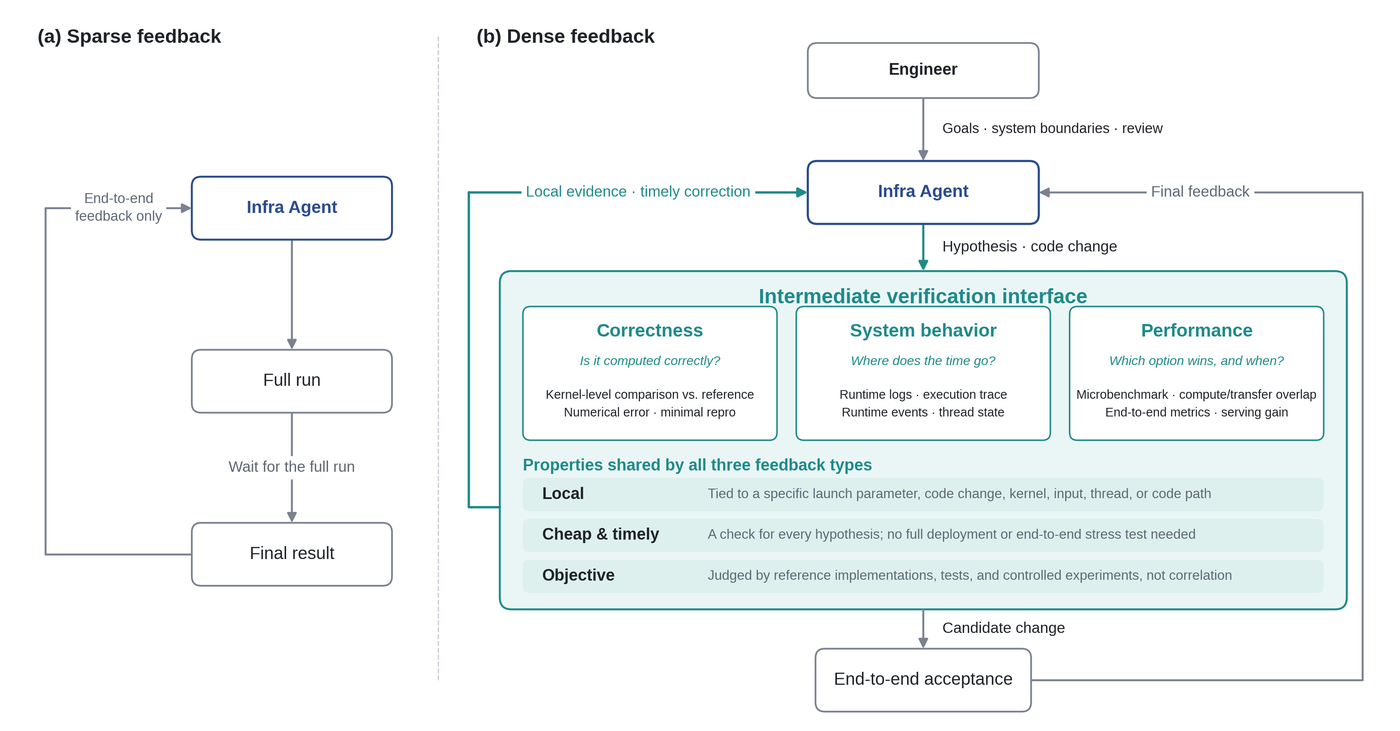 Figura: Bucle de optimización del Infra Agent estructurado en torno a una retroalimentación densa. Fuente: blog oficial de z.ai
Desglosando la caja negra: una red de retroalimentación densa
La capacidad para refactorizar el código base de bajo nivel en solo catorce días se sustentó en una metodología esencial: la «retroalimentación densa» (Dense Feedback). Durante la depuración de un clúster heterogéneo de 100.000 nodos, el mayor peligro reside en las degradaciones imprevistas del rendimiento. La clave de la rapidez residió en transformar un error genérico del sistema en una causa procesable: determinar con exactitud en qué capa se origina el problema, por qué se deteriora la latencia y qué prueba debe ejecutarse a continuación.
Para arrojar luz sobre esta caja negra, el equipo de optimización definió tres directrices innegociables. En primer lugar, la retroalimentación debía ser estrictamente localizada. El sistema de telemetría debía penetrar la capa de hardware para aislar unidades de kernel concretas, condiciones ambientales desencadenantes e intervalos temporales medidos en microsegundos. La complejidad inmanejable del macroclúster se dividió así en fragmentos de estado locales, observables y controlables.
En segundo lugar, el coste computacional de recopilar estos datos debía ser mínimo y los tiempos de respuesta inmediatos. Cualquier hipótesis técnica susceptible de contrastarse mediante pruebas unitarias en el kernel o microbenchmarks locales se resolvía en fase de desarrollo, sin trasladar pruebas a ciegas al entorno completo de producción. En tercer lugar, cada intervención debía ser verificable de forma objetiva. Las modificaciones del código base se validaron mediante rigurosos experimentos de control, vetando cualquier conclusión sustentada únicamente en correlaciones superficiales observadas en tiempo de ejecución.
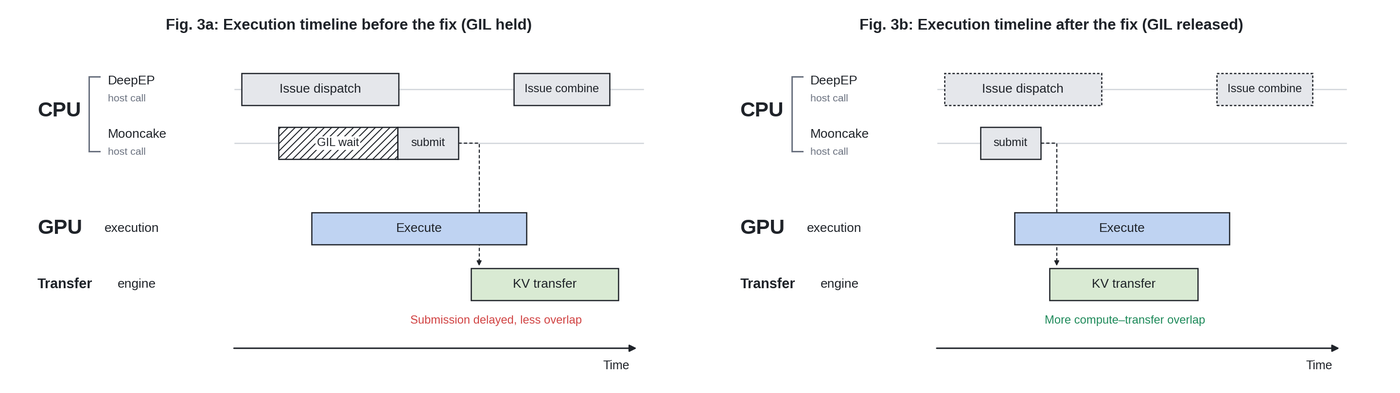 Figura: Flujo del proceso de optimización del sistema de inferencia. Fuente: blog oficial de z.ai
Las métricas de laboratorio chocan con la experiencia de los desarrolladores
La espectacular curva de rendimiento difundida en la publicación oficial no convenció por completo a todos los profesionales del sector. En los intensos debates surgidos en Hacker News, que congregaron cientos de comentarios, quedó patente una notable disparidad en la experiencia de uso. Mientras que una parte de los observadores expresó su asombro ante la rápida optimización de un clúster tan masivo, otros desarrolladores mostraron sus propios registros de latencia en la API para cuestionar los datos oficiales.
Varios usuarios señalaron que en entornos de producción con contextos extensos y complejos, la velocidad de respuesta de la API de GLM resultaba muy lenta y estaba sujeta a límites de concurrencia extremadamente restrictivos. Algunos desarrolladores que intentaron ejecutar tareas automatizadas durante toda la noche informaron de interrupciones imprevistas tras pocas horas debido a fallos de red o agotamiento de cuotas. Esta brecha puso en evidencia el desfase que a menudo existe entre las métricas obtenidas en condiciones controladas de laboratorio y la cruda realidad de los entornos de producción reales y cambiantes.
La discusión no tardó en rebasar el plano estrictamente técnico para abordar la narrativa sobre la seguridad y el poder de la IA. Críticos del sector señalaron que la advertencia del artículo sobre una IA tan poderosa que roza riesgos existenciales resultaba contradictoria frente a la fragilidad operativa percibida en las llamadas a la API. Al mismo tiempo, desarrolladores internacionales plantearon una pregunta legítima: si 100.000 aceleradores de prestaciones reducidas pueden alcanzar el umbral de viabilidad gracias al ingenio algorítmico y a la automatización por agentes, ¿por qué los gigantes tecnológicos occidentales, respaldados por ingentes fondos y las GPU más potentes del mercado, no han demostrado optimizaciones conjuntas de hardware y software de similar envergadura?
La velocidad de iteración redefine la línea base del hardware
El equipo de arquitectura definió esta iniciativa liderada por agentes como una fase temprana de mejora recursiva autorreferencial (Recursive Self-Improvement o RSI). El modelo evidenció facultades para leer, comprender, diagnosticar y modificar el código de la infraestructura que hace posible su propio funcionamiento. Con todo, el equipo mantuvo una prudente mesura al recalcar que la definición de objetivos de optimización, los límites de alteración del código y el control de los riesgos de seguridad deben permanecer bajo la supervisión ineludible de ingenieros humanos.
El sistema depurado a lo largo de esas dos intensas semanas envía un mensaje nítido al mercado tecnológico: el viejo axioma que descartaba la viabilidad de la computación china alternativa ha quedado prácticamente obsoleto. Frente a una plataforma con escasa memoria y sin ventajas de conectividad, el equipo logró situar los costes de inferencia por token al nivel de los principales proveedores de GPU mediante una retroalimentación de máxima densidad y la delegación de las tareas complejas de ensayo y error en el propio modelo.
La distancia en el ecosistema de hardware no se desvanecerá con un sprint de dos semanas. La verdadera variable determinante es hasta qué punto puede comprimirse el intervalo entre la detección de un error y su corrección en el kernel cuando la información diagnóstica alcanza un nivel microscópico. Este logro marca un nuevo techo: en chips con restricciones físicas de memoria y ancho de banda, la velocidad de iteración puede suplir parcialmente la falta de potencia bruta del hardware. Hasta dónde alcanzará esa sustitución es un interrogante que, por ahora, solo cuenta con los datos obtenidos durante dos semanas por una sola compañía.
Enlaces de referencia: