Am 17. September 2026 erschütterte eine bemerkenswerte Veröffentlichung die etablierten Gewissheiten der weltweiten Compute-Krise: z.ai legte detailliert dar, wie das Unternehmen einen vollständigen produktionsreifen Inferenzdienst von Grund auf auf einem Cluster von über 100.000 in China hergestellten KI-Beschleunigern aufbaute. Es handelt sich nicht bloß um einen Machbarkeitsnachweis – der gesamte produktive Inferenz-Traffic für das Flaggschiffmodell GLM-5.3-Flash läuft inzwischen stabil auf dieser Non-NVIDIA-Infrastruktur. Das bemerkenswerteste Detail ist das Tempo: Vom ersten lauffähigen Modellaufruf auf der neuen Hardware bis zum verlässlichen Abfangen des realen Produktiv-Traffics vergingen gerade einmal zwei Wochen.
62 Billionen Token in 14 Tagen unter realer Last
Vor seiner offiziellen Vorstellung durchlief GLM-5.3-Flash einen extremen Volllast-Stresstest. Unter dem Pseudonym „Ox-Alpha“ wurde das Modell anonym auf zwei führenden Entwicklerplattformen bereitgestellt: OpenCode und OpenRouter. Innerhalb von nur sechs Tagen verarbeitete das System mehr als 62 Billionen Token und setzte sich auf beiden Plattformen an die Spitze der Nutzungscharts. Dieses gewaltige Aufkommen an gleichzeitigen Anfragen stellte die Belastbarkeit der heimischen Hardware-Infrastruktur unter realen Produktionsbedingungen auf eine harte Probe.
Anstatt unter der Last zusammenzubrechen, brachte der massive Ansturm das ungenutzte Potenzial der zugrunde liegenden Hardware zum Vorschein. Innerhalb einer zweiwöchigen Optimierungsphase verdreifachte sich der End-to-End-Durchsatz des gesamten Clusters gegenüber der ursprünglichen Baseline. Dieser Leistungssprung revolutionierte die Auslastungseffizienz der Hardware und drückte die Inferenzkosten pro Token auf ein Niveau, das mit modernen NVIDIA-GPU-Architekturen voll konkurrenzfähig ist. Diese Kostenparität belegt, dass chinesische Beschleuniger durch gezieltes Software-Engineering bestehende Ökosystem-Defizite ausgleichen und sich in anspruchsvollen kommerziellen Umgebungen wirtschaftlich behaupten können.
Den entscheidenden Hebel bei diesem Kraftakt bildete ein von GLM-5.3 selbst angetriebener „Infra Agent“. Das Modell griff direkt in das Systemgeschehen ein und wirkte aktiv am Aufbau, dem Debugging und der kontinuierlichen Optimierung seiner eigenen physischen Ausführungsumgebung mit. Der Ansatz, ein leistungsfähiges Reasoning-Modell zur systematischen Beseitigung von Low-Level-Flaschenhälsen einzusetzen, wurde in einem Netzwerk von 100.000 Beschleunigern zu einer reproduzierbaren Ingenieurspraxis.
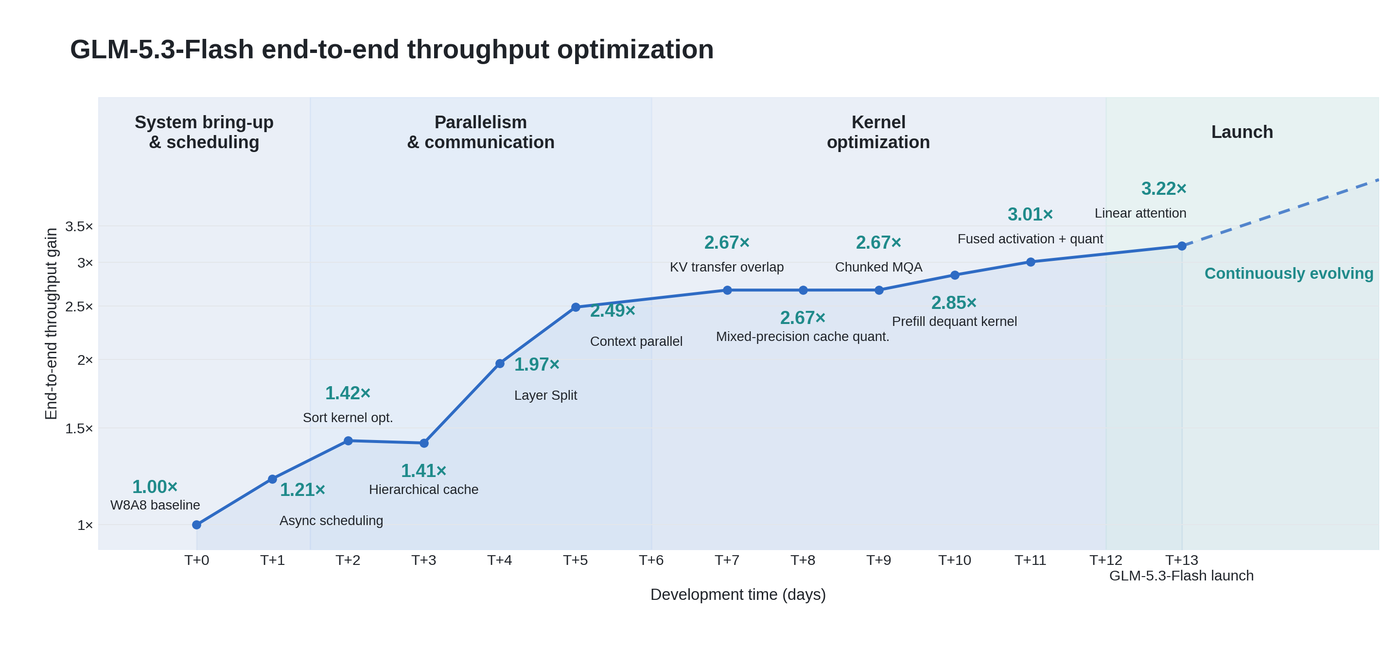 Abbildung: Entwicklung des End-to-End-Durchsatzes von GLM-5.3-Flash. Quelle: Offizieller z.ai-Blog
Algorithmische Kompensation physischer Hardware-Defizite
Das Entwicklerteam verschwieg keineswegs die widrigen Ausgangsbedingungen des Projekts. Die für das Clusternetzwerk genutzten heimischen Chips wiesen erhebliche bauliche Nachteile bei Speicherkapazität und Interconnect-Bandbreite auf. Das begleitende Software-Ökosystem präsentierte sich weitgehend rudimentär, und die Treiber-Unterstützung auf Kernel-Ebene wies zahlreiche Schwachstellen auf. An vielen kritischen technischen Schnittstellen fehlte die notwendige Low-Level-Dokumentation vollständig, sodass sich das Team auf ingenieurmäßige Intuition, fundierte Vermutungen und aufwendiges Reverse Engineering verlassen musste.
Um diese physikalischen Hürden zu überwinden, implementierte das Infrastruktur-Team einen umfassenden Software-Optimierungs-Stack. Auf architektonischer Ebene setzten sie konsequent auf Intra-Node-Tensor-Parallelismus für Linear Attention und den LM Head, während ReplaySSM zur präzisen Zustandssteuerung integriert wurde. Zur Senkung des Speicherbedarfs führte das Team flächendeckend W8A8-Quantisierung ein, kombiniert mit Mixed-Precision-KV-Cache-Quantisierung über INT8-, FP8- und BF16-Formate hinweg. Ergänzt durch Layer-Split-Techniken und eine disaggregierte Encode-Prefill-Decode-Architektur (EPD) wurde die Recheneffizienz durch fein abgestimmtes Scheduling bis auf die letzte Taktperiode optimiert.
Dieses Bündel anspruchsvoller Maßnahmen zielte passgenau auf das Durchbrechen der Speicher- und Bandbreiten-Engpässe ab. Wenn der lokale Videospeicher eines einzelnen Chips nicht für die gigantische Parameteranzahl ausreicht und die physikalischen Grenzen der Chip-zu-Chip-Kommunikation den Datenaustausch drosseln, kompensierten die Ingenieure dies durch mikrosekundengenaue Ausführungszerlegung und minutiöses Scheduling. Die Unreife der Infrastruktur brachte das Vorhaben nicht zu Fall, sondern erzwang im Gegenteil Denkansätze, die sich radikal von gewohnten CUDA-Mustern lösten.
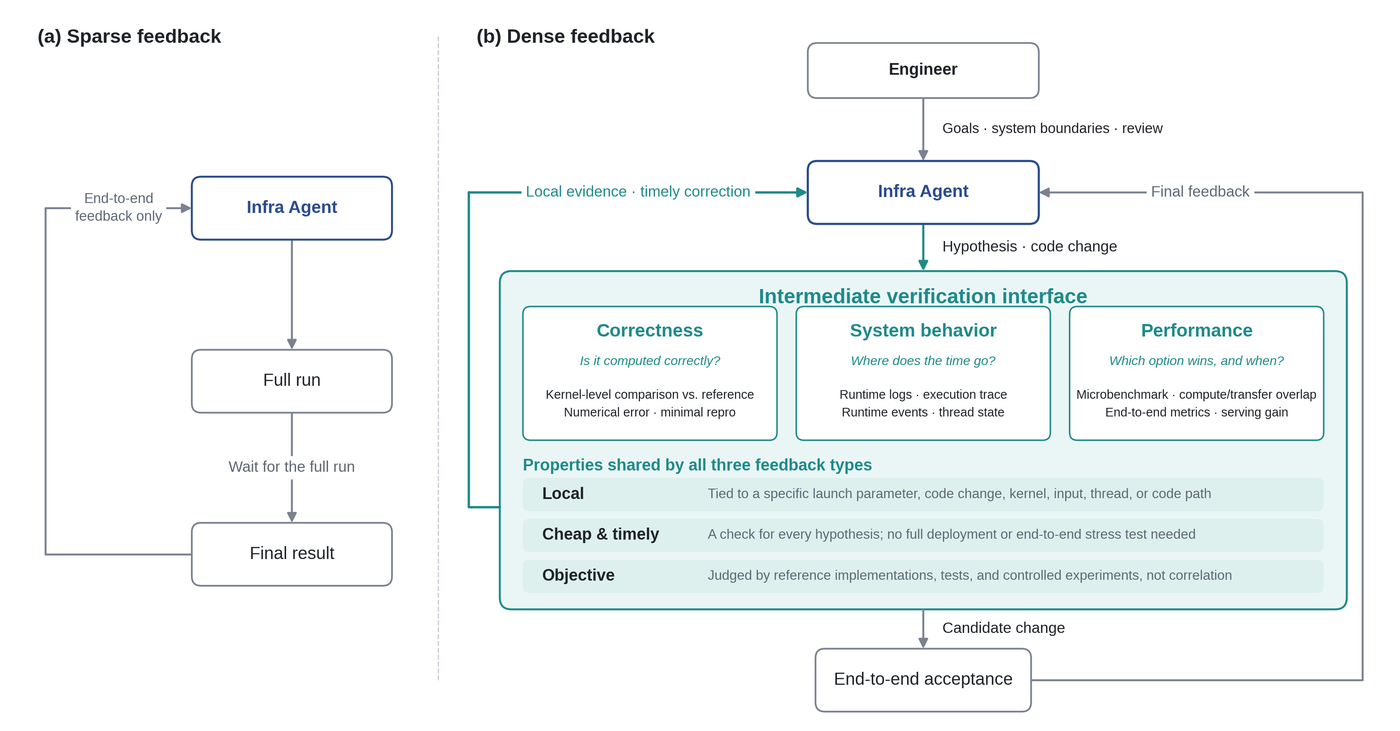 Abbildung: Die um dichtes Feedback aufgebaute Optimierungsschleife des Infra-Agenten. Quelle: Offizieller z.ai-Blog
Aufbrechen der Blackbox durch dichte Feedback-Netzwerke
Dass eine derart tiefgreifende Überarbeitung des Low-Level-Codebestands innerhalb von 14 Tagen gelang, beruhte vor allem auf einer zentralen Methodik: dem Konzept des „dichten Feedbacks“ (Dense Feedback). Bei der Fehlersuche in einem heterogenen Cluster aus 100.000 Knoten ist ein unklarer Performance-Abfall das gefürchtetste Szenario. Vage Fehlermeldungen in Sekundenschnelle in handlungsrelevante Erkenntnisse zu überführen – exakt zu wissen, auf welcher Schicht der Fehler auftritt, warum die Leistung einbricht und welches Experiment als Nächstes auszuführen ist –, bildete das Fundament des Optimierungstempos.
Um die Blackbox zu durchdringen, definierte das Team drei strikte Feedback-Prinzipien. Erstens muss das Feedback hochgradig lokalisiert sein. Das Telemetriesystem muss die Hardware-Schicht durchdringen und spezifische Kernel-Aufrufe, präzise Umgebungsauslöser und Zeitfenster im Mikrosekundenbereich isolieren können. Die Unberechenbarkeit des gigantischen Rechennetzwerks wurde so in überschaubare, mess- und kontrollierbare Zustandsschnitte zerlegt.
Zweitens müssen die Kosten für die Datenerhebung minimal und die Feedback-Schleifen extrem kurz sein. Jede Performance-Frage, die sich über Unit-Tests auf Kernel-Ebene oder lokale Micro-Benchmarks klären ließ, wurde strikt in der Entwicklungsphase abgefangen und niemals ungeprüft in die gesamte Produktivumgebung getragen. Drittens müssen alle Optimierungsmaßnahmen objektiv verifizierbar sein. Jede Änderung am Low-Level-Code basierte auf kontrollierten Experimenten; rein spekulative Schlüsse aus oberflächlichen Laufzeitsignalen waren strikt untersagt.
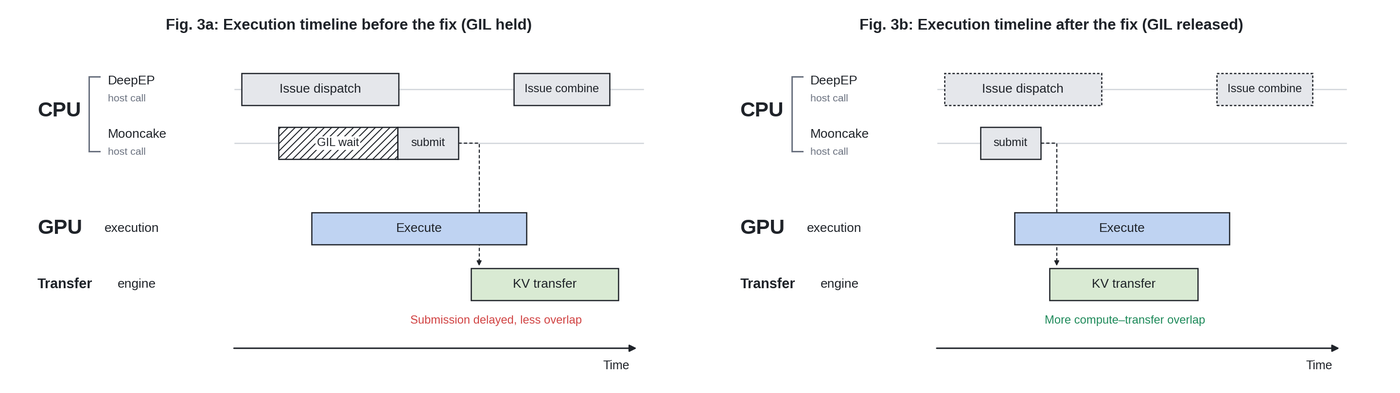 Abbildung: Workflow der Optimierung des Inferenzsystems. Quelle: Offizieller z.ai-Blog
Glänzende Messwerte im Realitätscheck der Entwickler
Die im offiziellen Bericht präsentierte Durchsatzkurve vermochte jedoch nicht alle Praktiker in der Entwickler-Community restlos zu überzeugen. In den intensiven Diskussionen auf Hacker News mit Hunderten von Beiträgen traten deutliche Diskrepanzen in der Praxiserfahrung zutage. Während ein Teil der Fachwelt von der raschen Reorganisation eines derart massiven heimischen Clusters beeindruckt war, hielten andere Entwickler mit ihren eigenen API-Latenzprotokollen dagegen.
Mehrere Anwender berichteten, dass die API-Antwortzeiten von GLM bei anspruchsvollen Aufgaben mit langen Kontexten auffallend träge ausfielen und von rigiden Rate-Limits für parallele Abfragen flankiert wurden. Entwickler, die versuchten, das Modell über Nacht für langwierige autonome Programmieraufgaben einzusetzen, stellten fest, dass die Sitzungen häufig nach wenigen Stunden wegen Netzwerkabbrüchen oder Quota-Überschreitungen stoppten. Diese Diskrepanz verdeutlichte die Kluft zwischen idealisierten Benchmark-Messungen im Labor und den unberechenbaren Bedingungen des weltweiten Produktiveinsatzes.
Die Diskussion ging bald über reine Implementierungsdetails hinaus und berührte grundlegende Fragen zur Sicherheitserzählung der KI-Entwickler. Kritiker merkten an, dass die im Text geäußerte Warnung vor einer potenziell bedrohlichen Eigenständigkeit des Modells in scharfem Kontrast zur tatsächlich erlebten Fragilität der bereitgestellten API-Dienste stehe. Gleichzeitig formulierten internationale Entwickler eine unbequeme Frage: Wenn ein Cluster aus 100.000 leistungsschwächeren Chips allein durch algorithmische Finesse und Agenten-Steuerung die Leistungsschwelle zur Wirtschaftlichkeit erreichen kann, warum haben die finanzstarken westlichen Tech-Konzerne trotz modernster GPU-Ausstattung bisher keine vergleichbaren Hard- und Software-Kopplungen demonstriert?
Iterationsgeschwindigkeit verschiebt die Baselines des Hardware-Wettbewerbs
Das verantwortliche Architekturteam stufte diese agentengesteuerte Ingenieurspraxis explizit als frühe Manifestation rekursiver Selbstverbesserung (Recursive Self-Improvement, RSI) ein. Das Modell erwies sich als fähig, den Infrastrukturcode seiner eigenen Laufzeitumgebung eigenständig zu lesen, zu verstehen, zu analysieren und zu modifizieren. Zugleich wahrte das Team eine realistische Perspektive: Die Festlegung konkreter Optimierungsziele, die Definition von Code-Änderungsgrenzen und die Bewertung potenzieller Sicherheitsrisiken müssen weiterhin fest in den Händen menschlicher Ingenieure verbleiben.
Das in zwei Wochen unter hohem Druck entwickelte System sendet ein deutliches Signal an die weltweite Halbleiter- und KI-Branche: Die lange gepflegte Annahme, chinesische Beschleuniger seien für moderne Produktions-Workloads ungeeignet, hat ihre Gültigkeit weitgehend verloren. Auf einer Hardware-Plattform mit knapper Speicherkapazität und unterlegener Bandbreite gelang es dem Team durch maximale Feedback-Dichte und die Delegation mühsamer Trial-and-Error-Arbeit an Sprachmodelle, die Inferenzkosten pro Token auf das Niveau führender GPU-Hersteller zu drücken.
Die Kluft im Hardware-Ökosystem wird nicht durch einen einzelnen zweiwöchigen Sprint verschwinden. Die entscheidende Variable ist vielmehr, wie stark sich der Zyklus von der Fehlererkennung bis zum Kernel-Fix komprimieren lässt, sobald das Feedback eine feine Granularität erreicht. Dieses System markiert eine neue Obergrenze: Auf Chips mit begrenztem Speicher und schmaler Bandbreite kann eine hohe Iterationsgeschwindigkeit physische Nachteile der Hardware teilweise ausgleichen. Wie weit dieser Ausgleich trägt, lässt sich derzeit anhand der zweiwöchigen Datenbasis eines einzelnen Pionierprojekts ermessen.
Referenzen: