爆红的模型,25行就能复刻
9 月 22 日,距离 TypeSafe 发布 Jev 刚过一周,NobodyWho 博客贴出了《Jev in 25 Lines of Python》:用 Qwen3-0.6B 的 GGUF 加上 llama.cpp 的 logits_all 模式,在 prompt 里放上 A/B/C 三个选项,取对应 token 的 logit 做 softmax 归一化,一个带概率分布的分类器就出来了。零训练、零 API、全本地。这篇自称「parody」的博文传递了一个尴尬的信息——被技术社区捧了两周的「新范式」,25 行 Python 就能跑通核心机制。
发布当时的数字是另一个量级:9 月 15 日,TypeSafe AI 创始人 Diogo Almeida(前 OpenAI,参与过 ChatGPT 指令微调研究)发布了名为「System One Model」的新品类:放弃字符串生成,只输出类型安全的结构化决策,官方宣称「数学上不可能出现类型错误」,官网首页写着比 LLM 快 193.6 倍、便宜 444.6 倍。Vercel 官方数据显示,Jev 是 AI Gateway 历史上采用最快的模型。
一边是新范式的爆红,一边是 25 行的复刻。这两件事同时成立,问题就变成了:Jev 到底在卖什么?
25行复刻到的是什么
先说复刻到的那部分。Jev 的推理机制拆开后惊人地朴素:它不生成任何文本,输入一段 state 和一组问题,每个问题给出选项,模型对选项 token 的 logit 做归一化,直接输出概率。choice 是多选一,noul 是布尔判断,score 是打分。Arcturus Labs 的逆向分析把机制说透了:Jev 本质是 LLM 的单 token logprobs 分类。
这个思路算不上新。2025 年就有人写过「Supercharging LLM Classifications with Logprobs」;更早的先例藏在 OpenAI 自己的机制里——从 tool calling 时代起,<|im_start|>assistant 后的第一个 token 预测 \n 还是 to=function.,本身就是「要不要调工具」的 micro-classifier,<|im_end|> 则是「说完了没」的分类器。Jev 做的事情,是把 OpenAI 隐式的、特化的 micro-classifier 变成了通用的、暴露给开发者的产品。
所以 25 行复刻到的是推理流程。流程之外的部分,才是这个模型真正被标价的东西。
校准概率,软件敢直接信的部分
25 行复刻不了的第一样东西是校准。上面那段 Python 输出的概率是原始 LLM 的置信度——LLM 的原始概率出了名的过度自信且前后不一致,同一个问题换个措辞,概率可能从 0.9 跳到 0.6。TypeSafe 用一套叫 RLCD(Reinforcement Learning for Calibrated Decisions)的训练方法专门解决这个问题,训练数据 100% 合成。创始人对自家定位的原话:「我们自认为是数据研究实验室,绝大部分研究在于造出真正通用的数据。」
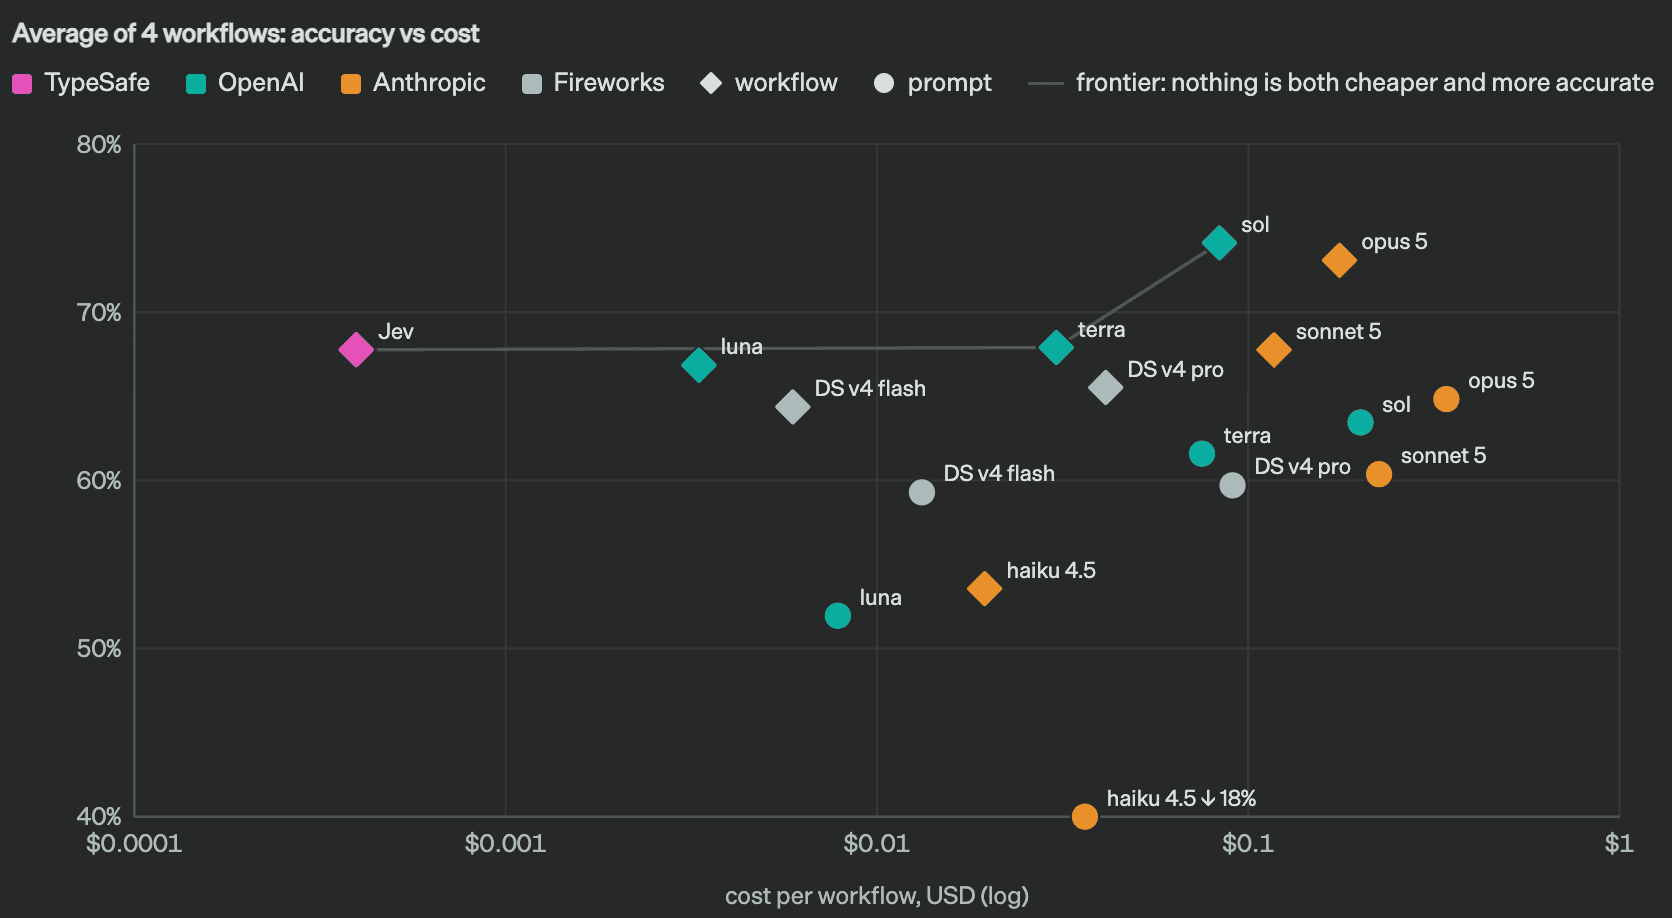
图:TypeSafe workflow evals 帕累托前沿,Jev 在成本-质量曲线上远离 frontier LLM 集群。来源:typesafe.ai
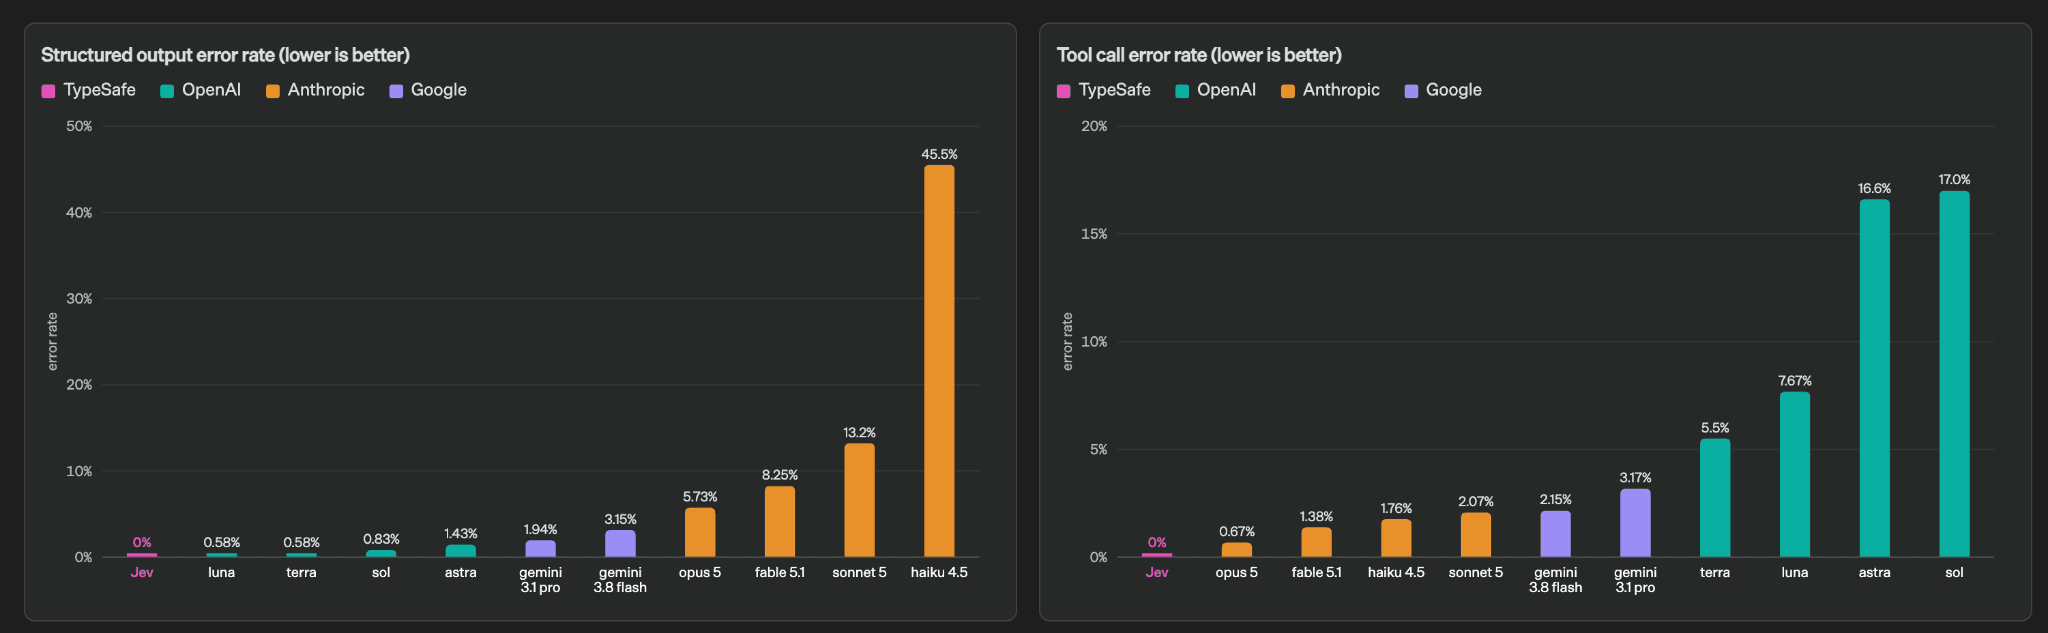
图:TypeSafe 幻觉率与类型安全对比。来源:typesafe.ai
第二样是工程包装。Jev 单次查询并行输出全部答案,端到端响应 70-500ms,输入 $0.042/MTok,输出 token 免费。数字背后的逻辑很直接:一个字符串生成器没法埋进有延迟保证的生产代码,一个带校准概率、无类型错误的分类器可以。HN 评论区给这个品类的定位是流传最广的一句:「一条聪明的 if 语句」——分类、路由、打分、拦截,发生在普通软件的分支逻辑里。
需要说清的另一面:Arcturus Labs 实测发现 Jev 在部分领域的概率并不成立,校准这个核心卖点同时也是它最容易被攻击的软肋。TypeSafe 拒绝公布公开 benchmark 成绩,还发过一篇 antibenchmaxxing 博文解释「这类决策模型没有统一基准可比」——社区对这个解释的反应相当一致:如果有好成绩,早就贴出来了。
两周生态,验证了同一件事
复刻门槛低,不代表这个品类是空的。Jev 发布后不到两周,围绕它的开源项目同时从四个方向长了出来——这个爆发速度本身,就是对「决策模型是个真需求」的验证:
| 项目 | 证明了什么 |
|---|---|
| Kev(jaredpalmer) | 0.5B 的决策模型 MacBook Pro 就能跑 |
| Ollaya | 本地运行时:RTX 4090 上 5 个问题 8-10ms(TypeSafe 托管 API 中位 236-276ms),官方 SDK 不改一行代码直接兼容 |
| Bespoke Nimble | Qwen3.5-9B LoRA 训练:自建 eval 上 66%→90%,Jev 参考线 93% |
| Perplexity CTO 的模型 | 3000 美元 + agent swarm 自主训练,登顶开源决策模型排行榜 |
| JevBench / jev-decision-index | 品类标准化:可复现基准和开源模型排行榜都出现了 |
| Pokémon Red 直播 / LangChain 集成 | 玩法验证:游戏决策、browser use(LangChain 创始人称这是他见过最好的 Jev 应用)、Box 的工单升级分类 |
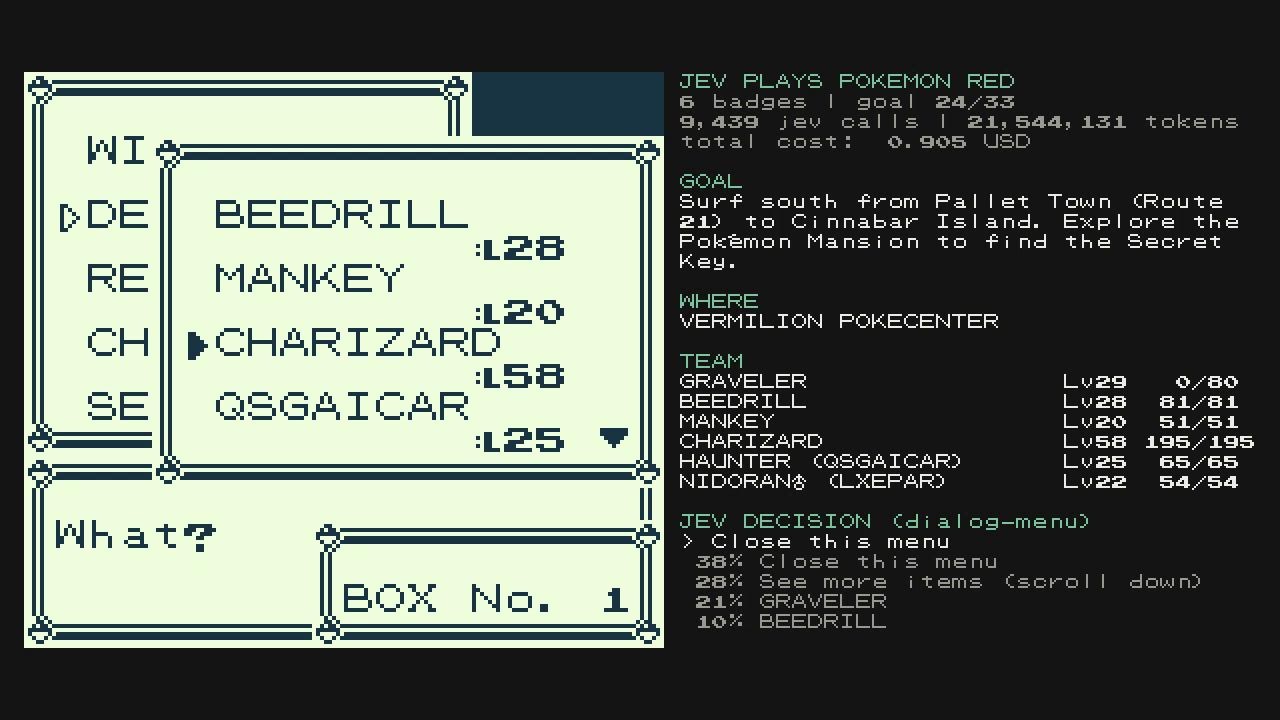
图:Jev Plays Pokémon Red 直播画面,右侧面板显示每步决策概率。来源:jev-pokemon.vercel.app
这份清单同时读出两层信息:架构层面确实没有秘密——一个 0.5B 的小模型、一个 LoRA 微调、3000 美元的 agent 训练,都能逼近官方产品;但反过来,社区用真金白银和两周时间投票,说明「给软件一个敢直接信的概率接口」这个需求是真的,连基准和排行榜这类品类成熟的标志都长了出来。
争议同样集中在验证方式上。话题性最强的 Pokémon demo 里,Jev 只负责在给定目标下选动作,导航、目标设定、按键映射全是外层 harness 提供的——HN 的吐槽很直接:「这更像看攻略玩游戏。」作者也承认 Jev 知道下一步去哪,是因为 harness 给了 guide。低延迟决策和高层规划之间的边界,目前没有人说清。
壁垒正在被3000美元测试
图:Arcturus Labs 文章配图——大机器人抢三明治,暗喻 OpenAI 随时可能入场。来源:arcturus-labs.com
Arcturus Labs 对 Jev 的商业判断很冷静:架构层面没有壁垒,OpenAI 用 LLM 当隐式分类器已经很多年,缺的只是产品化。Jev 真正的优势在训练数据——RLCD 管线和那个 100% 合成的通用数据集,才是复刻者绕不过去的部分。Arcturus 甚至替 OpenAI 想好了后手:把分类能力折进常规 LLM,加一个 <prediction> 标签让模型在推理中途自查——工具调用前做安全检查、判断任务该路由到大模型还是小模型、提前终止发散的思考链。
TypeSafe 创始人 Diogo Almeida 的回应只有一句:「如果模型质量重要,我们会在很长时间内处于非常好的位置。」这句话翻译过来:25 行能复刻推理流程,复刻校准质量需要那个数据集。
回到开头的问题。25 行 Python 回答了「Jev 是什么」——一个把 LLM 当分类器用的机制,朴素到藏在所有人眼皮底下十几年。它回答不了「Jev 值钱在哪」:TypeSafe 卖的东西从模型转向了概率的质量——让软件敢直接信、敢埋进生产代码的校准决策。Perplexity 的 CTO 用 3000 美元就训出了排行榜第一的竞品,这道壁垒的厚度,很快就会有答案。
参考链接:
- Introducing System One Models and Jev — TypeSafe AI
- HN 讨论: Introducing System One Models and Jev (49717558)
- Jev in 25 Lines of Python — NobodyWho
- Ollaya: Run decision models locally
- Kev: Tiny Jev-like family of decision models — GitHub
- Show HN: Jev Plays Pokémon Red (49845172)
- Will OpenAI Eat Jev’s Lunch? — Arcturus Labs
- TypeSafe’s Jev trades text generation for instant calibrated decisions — Arcturus Labs
- Show HN: JevBench, a reproducible benchmark (49800574)
- Latent Space: Here are 6 clones of Jev