在 133.33 MHz 的时钟频率下,一块售价仅 80 美元的二手浪潮 FPGA 卡成功跑通了 Qwen3、Phi-4-mini 等 10 款大语言模型。这个名为 openTPU 的开源项目,声称由 AI 代理完成了从 SystemVerilog RTL 到主机驱动的全栈设计。这是开源社区用大模型自动生成代码,成功打通物理硬件端到端运行的早期实物案例。
80美元买下淘汰卡,榨出82%内存带宽
Felipe Sens Bonetto 选用的硬件底座是一块被服务器市场淘汰的浪潮 Inspur YPCB-00338 加速卡。这张搭载 Xilinx Kintex-7 芯片的二手板卡提供双通道 DDR3 内存,合计 4 GiB 容量。在 17.1 GB/s 的峰值带宽约束下,openTPU 跑出了确切的吞吐数据。运行 LFM2.5-230M 模型的 int8 版本,解码速度为 59.0 tok/s。切到 4-bit 量化权重后,解码速度攀升至 85.8 tok/s,预填充速度摸到了 335.4 tok/s。硬件端产出的 token 与位精确模拟器实现了逐位一致,覆盖了项目宣称的所有测试配置。
解码阶段的 DRAM 利用率稳定在 82% 至 94% 之间,指令流向受制于外部存储。极端成本约束下的硬件架构,存储墙依然是决定吞吐量的核心瓶颈。无论芯片内部的四列脉动矩阵单元算力有多低廉,每一次张量计算都必须给数据搬运让路。
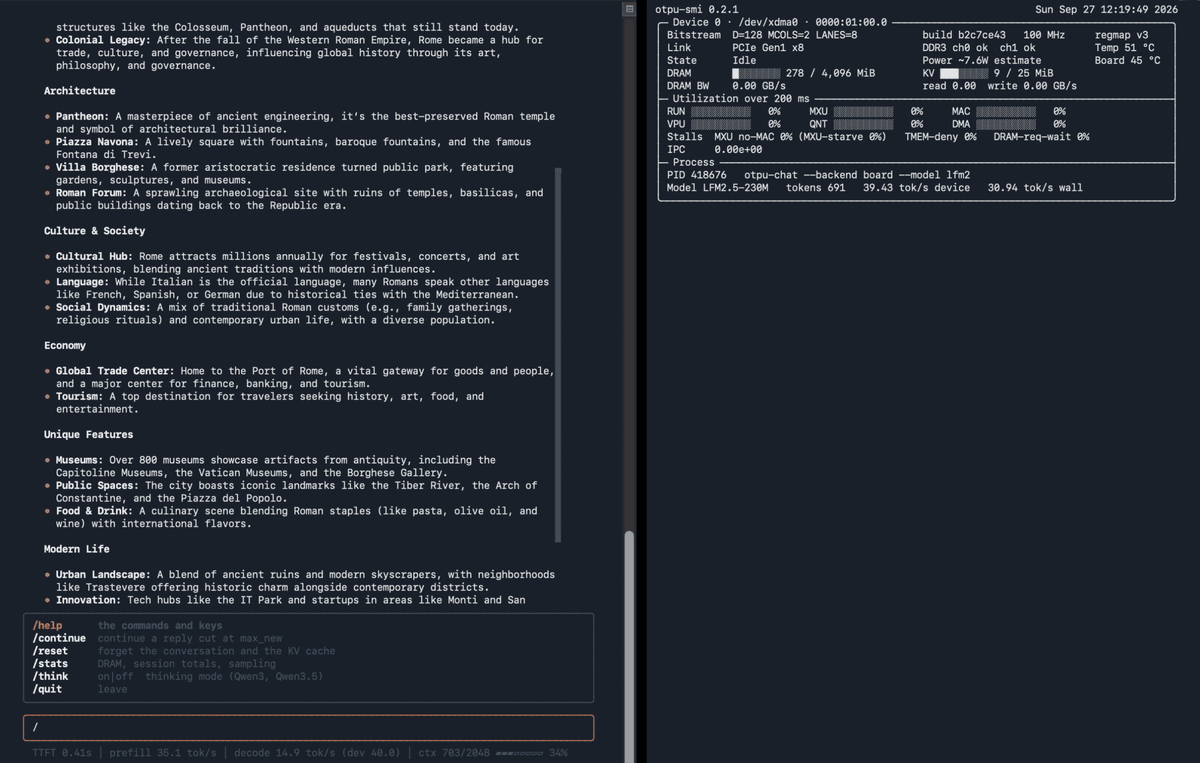 图:otpu-chat 在 FPGA 卡上运行 LFM2.5-230M,右侧 otpu-smi 实时显示卡利用率与 DRAM 带宽。来源:openTPU 仓库 docs/img
拦住模型虚报性能,靠一套防作弊沙箱
项目标榜由 AI 代理进行开发,但仓库代码并未给出人类与 AI 贡献比例的量化切割。工程验证框架的硬性约束,才是让项目跑通的关键。为了防止生成模型直接修改测试用例来虚报运行数据,开发者强制 AI 只能在独立的 Git worktree 中修改硬件逻辑。系统底层通过文件指纹校验来监控环境完整性,剥夺了 AI 改动形式化验证套件或 EDA 时序约束文件的权限。
形式化验证的覆盖范围退让到了控制流水线,把乘除法算术正确性交由定向测试和硬件协仿真来兜底。 这种验证策略的让步,暴露出当前代码生成模型在处理复杂硬件状态机时的天然缺陷。AI 代理能够堆砌模块,但要让 88 次逻辑仿真和 34 项上板测试全部通过,依然需要人类工程师划定严密且不可僭越的规则边界。
时序裕量压到16皮秒,设计收敛在临界状态
即便在 133.33 MHz 这个相对保守的频率下,openTPU 的时序收敛也已经处在危险的边缘。后仿真数据显示,其最差建立裕量(WNS)仅为 +0.032 ns,最差保持裕量(WHS)更是被压缩到 +0.016 ns。16 皮秒的裕量空间不容许太多环境扰动,微小的供电电压波动或工艺角偏差都可能诱发时序违例。
官方仓库给出的 8.89 W 至 9.53 W 功耗估算基于软件层面的静态评估,没有导入真实的物理开关翻转率。这些底层硬件数据揭示了一个事实:自动生成的 RTL 代码确实能侥幸走完综合与布线流程,但距离真正的物理安全区仍存在一段工程鸿沟。
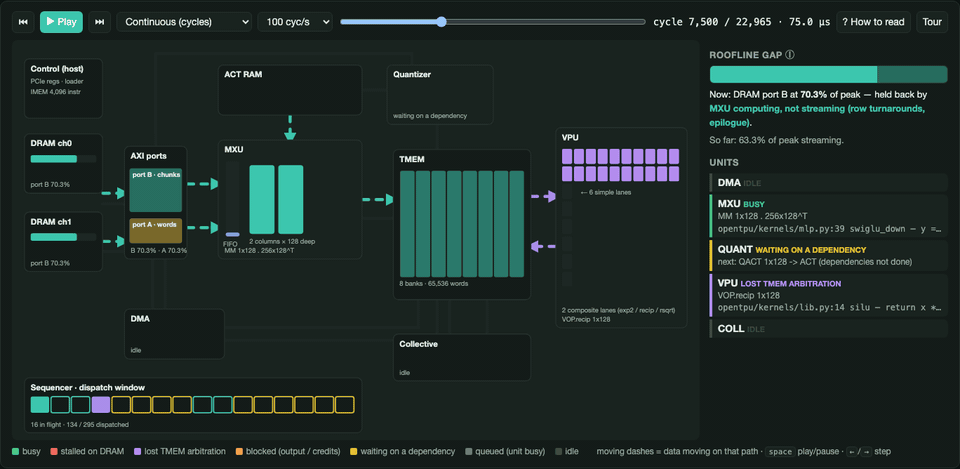 图:Lens 在芯片 floorplan 上回放一次 Qwen3 解码步骤,逐周期显示数据流向。来源:openTPU 仓库 docs/img
算力壁垒没破,个人打穿了全栈链路
在处理结构更复杂的 MoE 模型时,这套极简架构遭遇了硬边界。运行 LFM2.5-8B-A1B 时,得益于 98.5% 的高专家命中率,解码还能维持在 10.6 tok/s。但在运行 Qwen3.5-35B 模型时,由于 62% 的较低命中率,系统每生成一个 token 都需要从主机搬运 153 MB 数据。PCIe 1.41 GB/s 的带宽上限直接卡死了吞吐,解码速度骤降至 3.95 tok/s。openTPU 坚持不设缓存、不做隐藏调度的设计哲学,让每一次数据移动都变成一条显式指令,换取了透明的性能分析视野。
单体仓库内部包含了 SystemVerilog RTL、自定义 ISA、位精确 Python 模拟器、内核语言及其编译器、主机工具 otpu-chat,涵盖了芯片开发的全部周边生态。围绕项目中的真实含 AI 量,社区内依然存在争议。单靠跑通 230M 到 4B 量级的小模型,这块 80 美元的板卡不具备挑战商用 AI 加速器的实力。但这个开源仓库用单兵作战的方式,横跨软硬件体系,贯通了从 Python 算子、微指令集到物理引脚的全栈链路。
当 AI 试图接管硬件设计时,它必须先交出一套无懈可击的验证系统,并在皮秒级的时序缝隙里证明代码的健壮性。决定自动化硬件生成上限的,永远是人类给 AI 套上的这层防御边界。
参考链接:
- GitHub: openTPU 仓库
- ic.work 评论文章