科技巨头还在为十万张显卡的算力集群买单,一家欧洲公司只用不到四千张显卡,就把一个万亿参数级别的大模型推上了前沿牌桌。
2026年10月6日,Mistral 官方发布拥有 1 万亿参数的 Mistral Large 4(内部代号 ML4)。该模型在网络安全、代码修复等核心指标上,直接与全球最顶尖的开源模型打平。
把万亿参数练到顶级水平,不再绝对依赖天文数字的硬件堆叠。大模型军备竞赛的重心,正在从单纯的集群规模,转移到对数据、算力和部署环境的绝对控制权上。
3800张显卡撑起万亿参数体量
ML4 的训练全程在 Mistral 自家的欧洲数据中心完成,从零开始训练仅动用了 3800 张 NVIDIA Grace Blackwell 显卡。这打破了行业对万亿模型训练算力门槛的固有认知。
为了在有限算力下跑通庞大体量,ML4 采用了稀疏 MoE(混合专家)架构。整个模型包含 1 万亿参数,但通过「一大群专家里每次只叫醒一小部分」的机制,每算一个词只动用 490 亿激活参数。这种设计极大压低了推理期的计算开销。
 图:Mistral Large 4 官方发布页头图。来源:Mistral
极简的算力消耗直接反映在定价策略上。ML4 的输入价格为 1.36 美元/百万 token,输出价格定在 4.18 美元。把万亿级别模型的单价压进个位数美元区间,硬件成本的下降直接转化为商业竞争中的定价权。
需要厘清的前提是,3800 张显卡仅对应从零训练阶段,官方并未公布消耗的总 token 数与训练时长。云厂商的十万卡集群往往需要同时兼顾海量并发推理与多租户隔离,而 Mistral 的小集群专注于单一目标。
拿到真实代码执行漏洞修复
在 Artificial Analysis 的网络安全独立评测(Cyber Index)里,ML4 排进全球前五,在非中国出品的开放权重模型里领先幅度很大。其中一项测试要求模型复现开源软件里的真实漏洞再写补丁,ML4 拿到 82%,是所有参测模型里最高的。
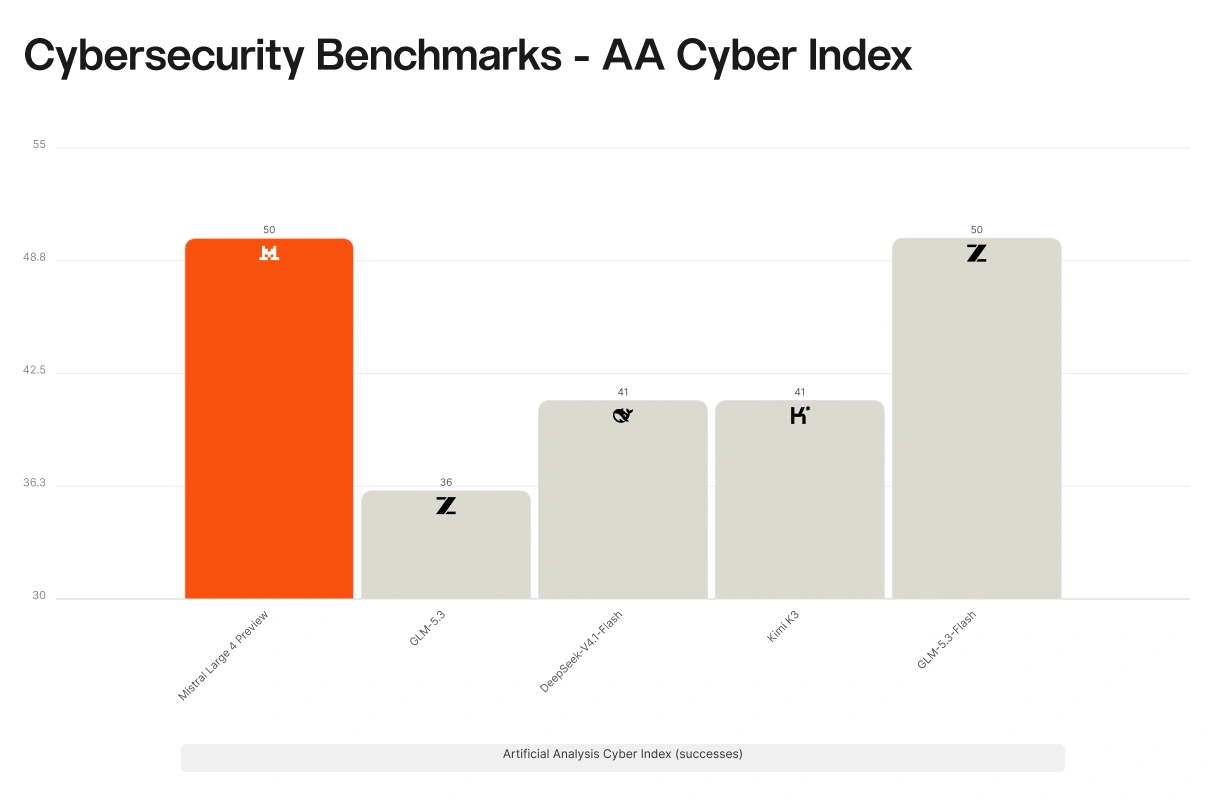 图:官方网络安全基准图表展示了模型在漏洞修复上的表现。来源:Mistral
ML4 在这项挑战中拿到了 82% 的修复率。而在由 40 道安全竞赛实战题改编的 Cybench 测试中,它同样解出了 93% 的题目。
在发布模型权重前,Mistral 专门向网络安全机构和政府主管单位提供了一个降低审核强度、扩展攻防能力的原生版本进行红队测试。模型能力评估的标准,已经从回答文字选择题转向了执行高危环境下的真实工程操作。
权重月底放出,训练数据与配方不公开
ML4 继续沿用了先上线 API、月底释出权重的发布节奏。技术社区反复追问的一个核心点是:区区四千张显卡练出的模型,究竟如何摸到头部水准。
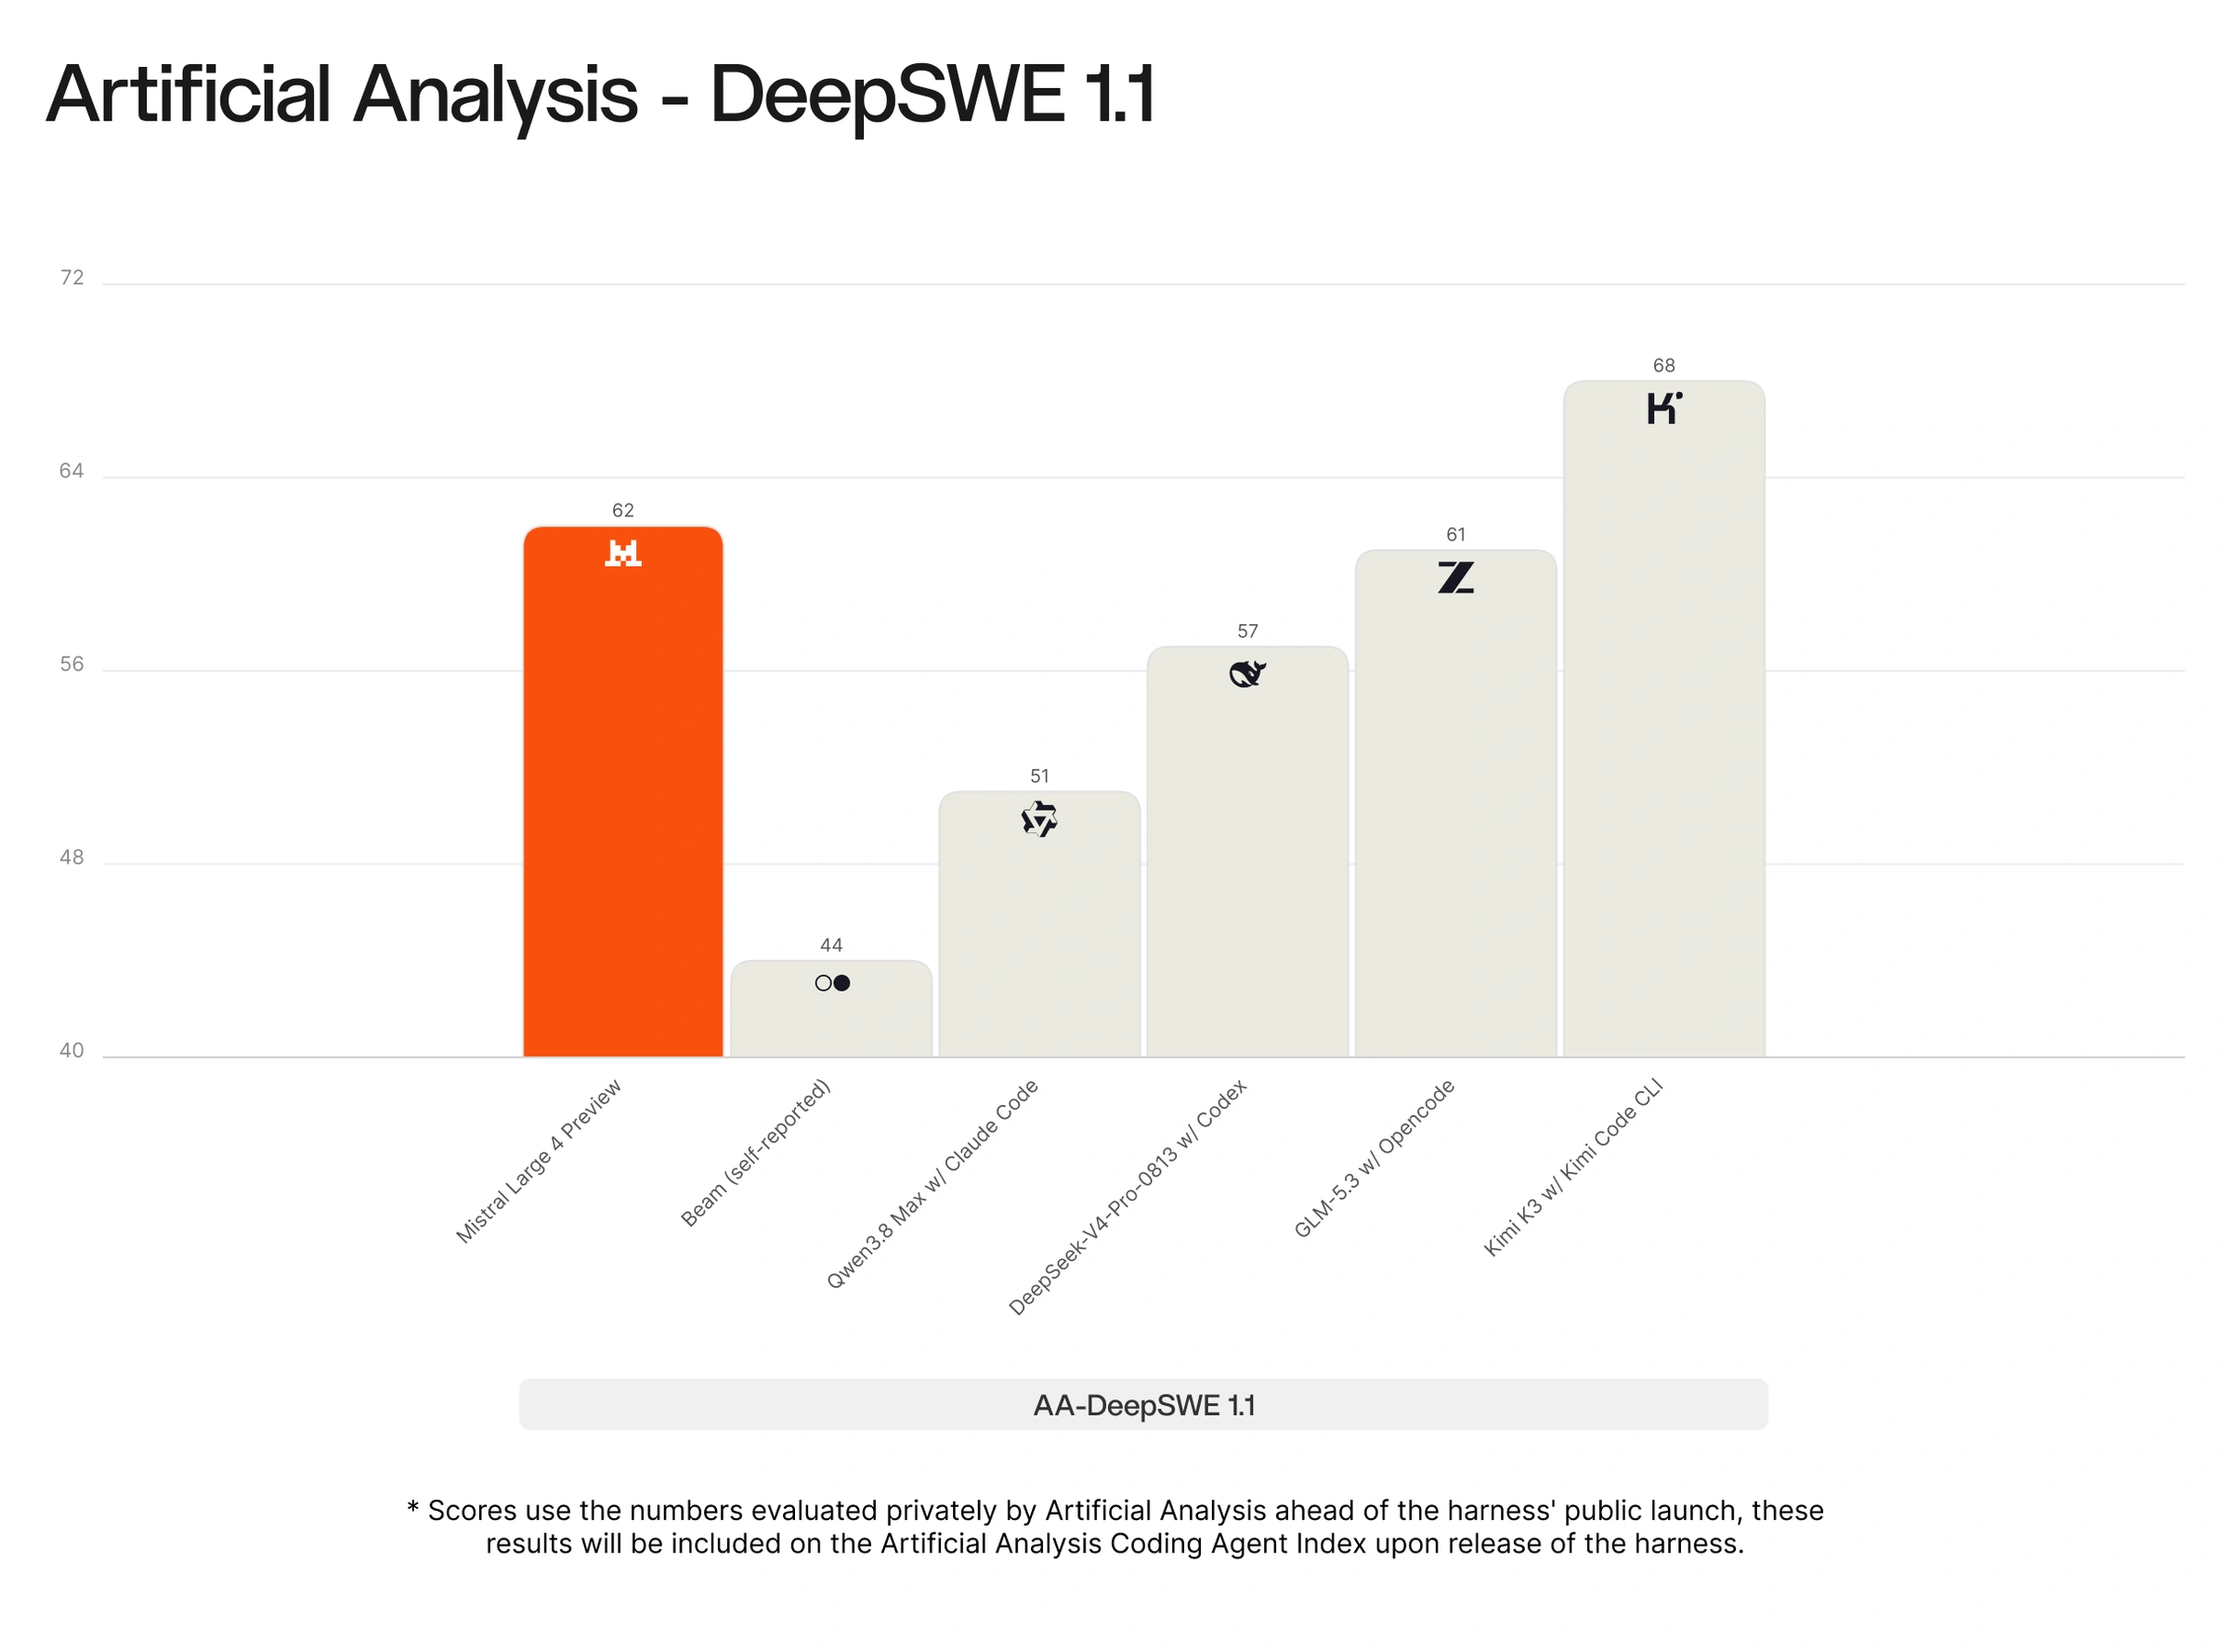 图:DeepSWE 编码能力基准测试对比。来源:Mistral / Artificial Analysis
答案藏在并未公开的数据集里。ML4 宣称覆盖 160 多个语种,并包含所有欧盟官方语言,但官方明确区分了「开放权重(open-weight)」与「开源(open-source)」的界限。外界可以免费下载并运行这 1 万亿参数,却拿不到训练数据和配方。
交出成品模型换取社区生态,同时把制造工艺锁在保险箱里,这是目前大模型厂商最务实的防御手段。
目前放出的预览版在工程细节上仍有打磨空间。部分开发者实测发现,模型的推理(reasoning)只提供了 none 和 high 两个档位,且开启 high 档位时偶尔会出现输出 token 反而更少的异常现象。
30亿欧元直接砸向自有数据中心
Mistral 刚刚完成了 30 亿欧元的 D 轮融资,这笔资金正被全数投入到扩建自有欧洲数据中心上。
ML4 的 public preview API 并没有跑在第三方云服务商的机器上,而是直接部署在训练该模型的那套基础设施里。从硬件采购、底层调度到模型训练,再到最终的 API 吞吐,整条链路完全由 Mistral 内部团队掌控。
掌握底层物理机房和算力调度系统,比单纯在公有云上租用庞大算力拥有更高的迭代效率。
当一个万亿参数模型能用四千张显卡做到顶尖水平时,大模型前沿竞争的门槛发生了实质性偏转。单纯比拼显卡采购数量的粗放阶段结束了,接下来的较量属于那些能将数据质量、硬件调度和本地化部署压榨到极限的团队。
参考链接:
- Mistral 官方公告
- Artificial Analysis 独立评测报告
- 开发者社区实测讨论