一台装着 12GB 显存游戏显卡的家用电脑,现在能以每秒 60 个字的速度,流畅运行 1250 亿参数的顶尖大模型。
长久以来,运行千亿参数模型是数据中心的特权。租用机架式服务器是参与牌局的唯一门槛。这个前提在 2026 年被三件事同时拆掉:模型权重的开放、稀疏激活架构的成熟,以及把精度压到极限的量化技术。开源推理引擎 Strata 通过一套激进的硬件分层调度策略,把 Qwen3.8-Flash-Next 塞进了普通人的电脑桌底。推理的边际成本从按月支付的云服务费,变成了你原本就拥有的那台电脑的电费。真正的技术门槛,已经从昂贵的显存容量转移到了主板内存和硬盘读取速度上。
12GB 显存装下 1250 亿参数
把 1250 亿参数装进 12GB 显存,听起来像要把大象塞进冰箱。但现代大模型的结构并非一块铁板。Qwen3.8-Flash-Next 虽然拥有 1250 亿总参数,但它采用了混合专家架构。整个模型内部总共包含 24576 个具体的「专家」网络。每次生成一个词汇时,系统只需要调用其中最相关的 10 个专家。这直接导致每次计算实际激活的参数量只有 60 亿。
Strata 引擎抓住了这个高度稀疏的架构特征,重新分配了硬件的工作负载。它将最常被调用的那几千个「热专家」长期驻留在 12GB 的显存中。这确保最核心、最高频的计算跑在速度最快的硬件上。剩下的上万个「冷专家」,则被全量存放在主板的内存条里。这种分层拦截的策略,直接绕过了游戏显卡显存严重不足的弱点。
内存与 CPU 在这场接力赛中接管了显卡的剩余工作。遇到生僻词需要调用冷专家时,系统会跨过显卡直接调动电脑的 CPU。它利用 AVX-512 或 AVX2 指令集进行并行计算。这套分层缓存机制打破了唯显存论。在严苛的工程优化下,普通硬件也能通过调度策略硬吃庞大的参数集群。
猜词与校验让速度翻倍
单靠分层缓存还不足以榨干硬件的每一滴性能。为了进一步拉高生成速度,模型内置了一个 40 亿参数的多词汇预测头。这个小模型会充当前锋,快速猜出接下来的几个词。随后庞大的主模型会一次性对这些预测结果进行批量校验。比起主模型一个词一个词往外蹦,这种批量校验的吞吐效率要高得多。
这种大小模型配合的猜测与校验流水线,让最终的生成速度直接飙升了 1.6 到 1.8 倍。在压缩率最高的 Q2_0 量化规格下,一台搭载 RTX 5070 和 Ryzen 5 7600 的测试机跑出了每秒 94 个词的数据。即便是精度更高的 IQ3_XXS 量化版本,速度也稳定在每秒 62 个词。优化大模型不再只是单向缩减参数。通过重构执行管线,消费级硬件的吞吐上限被强行拉高了。
不仅是生成速度,提示词的处理效率同样迎来了质变。处理一段 3.2 万词长的提示词时,系统能以每秒 2650 个词的速度一口气读完。面对超长文本,系统会按最大 8192 个词一块切分读取,长程任务不会中途撑爆内存。Qwen3.8-Flash-Next 原生支持 26 万个词的上下文,通过 YaRN 技术能扩展到 100 万个词,本地电脑由此具备了吞下整本长篇小说的能力。
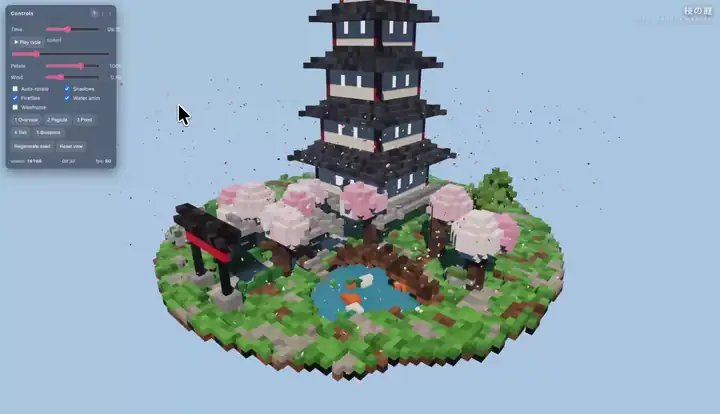 图:一次提示词生成的体素佛塔花园,在浏览器里跑起来的效果。来源:Strata 仓库 README
本地运行取代云端服务
当生成速度和上下文长度都达到可用标准后,本地部署的意义就不再是技术极客的玩具。Strata 在本地机器的 localhost 端口上,直接建立了一个兼容 OpenAI 和 Anthropic 接口的 API 服务。用户不需要修改任何代码习惯。模型文件由安装脚本自动从 Hugging Face 拉取,就能让本地电脑接入现有的 AI 工具链。
不管是自动写代码的 Cursor,还是独立工作的 Claude Code 智能体,现在都可以直接将请求发送到这个本地地址。这切断了开发者对云端大厂 API 的物理依赖。开发者不再需要盯着不断跳动的 API 账单。你也不用担心核心业务代码在云端传输时面临的数据安全风险。只要电脑不关机,顶尖模型的算力就源源不断。
这套系统的包容性同样跨越了厂商壁垒。在 AMD 的 RX 9070 XT 显卡上,这款 16GB 显存的设备在 Q2_0 精度下同样跑出了每秒 60 个词的速度。整个系统复用了 llama.cpp 和 ggml 的底层代码。它通过 ISTA-DASLab 和 Unsloth 提供的量化方案,将庞大的模型压缩进家用电脑。消费级硬件的生态开始成型,AI 算力正从集中式的数据中心回流到每个开发者的桌面。
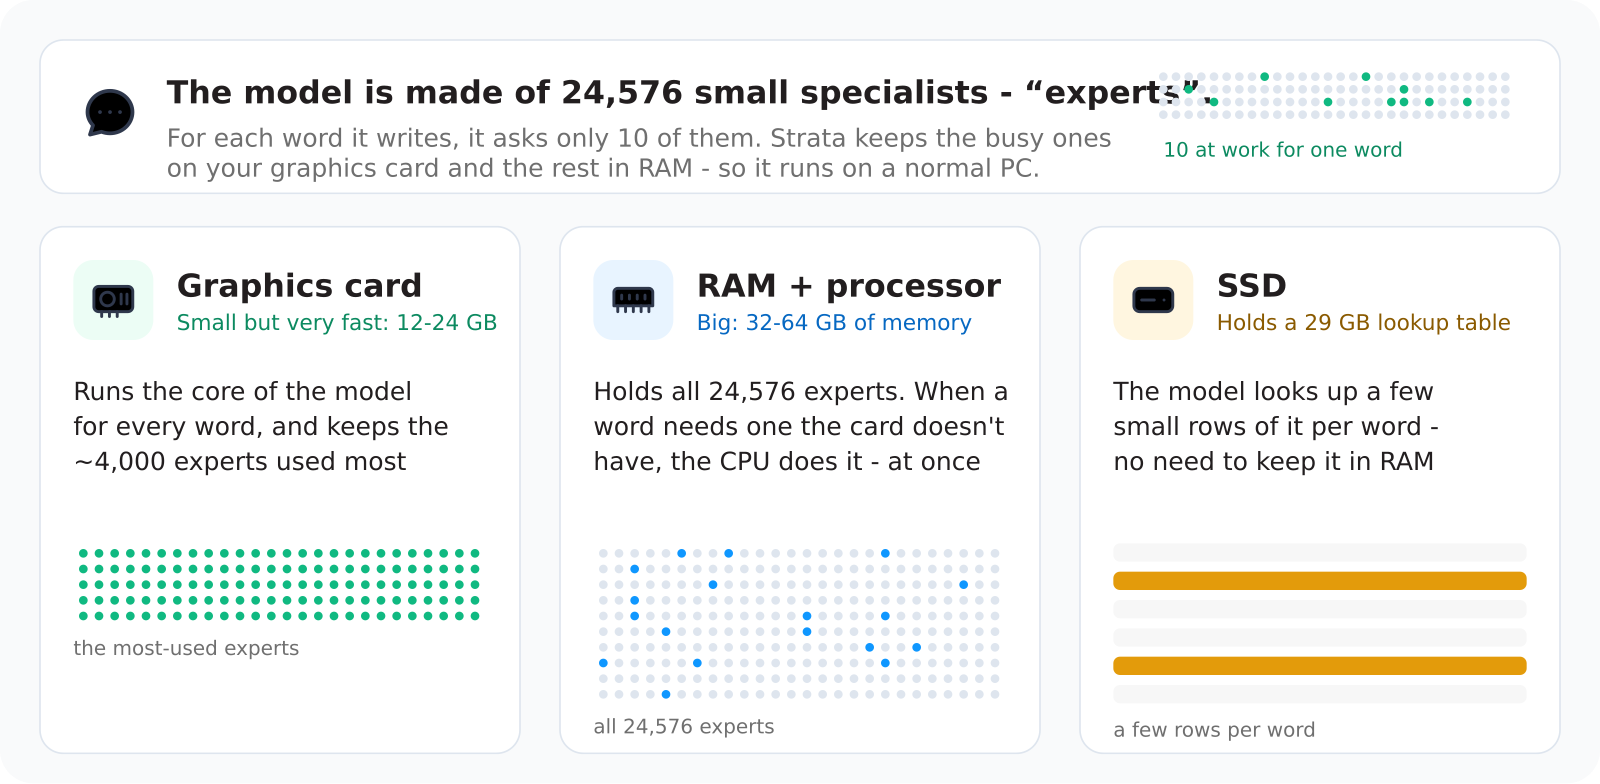 图:官方硬件调度示意图,展示显存、内存、CPU 与 SSD 各自负责的数据。来源:Strata 仓库 docs/media
真正的门槛变成了硬盘
把算力中心搬回桌面的过程并非毫无摩擦。当显卡不再是绝对的短板时,巨大的吞吐压力立刻传导到了其他硬件组件上。为了维持运转,系统中还包含了一个 510 亿参数的 n-gram 嵌入表。这部分庞大的数据被直接塞进固态硬盘,作为一张巨大的查找表供系统随时翻阅。
存储设备的读取速度成为了新的卡点。大模型需要读取海量的权重文件。默认的 Unsloth UD-IQ4_XS 量化规格下载体积高达 94GB。如果电脑的物理内存不足 80GB,装不下所有的专家网络,系统就必须在生成过程中实时从固态硬盘里读取缺失的冷专家。一旦发生跨硬盘的实时读取,流畅的生成速度就会遭遇断崖式下跌。计算力达标后,总线带宽决定了模型表现的下限。
12GB 显存的额度在这个挑战中已经被压榨到了极限。如果在纯文字生成的过程中强行塞入图片让模型识别,图像编码器会瞬间挤爆残存的显存。官方的避坑指南明确要求,处理图片时必须通过命令行参数手动预留 1GB 显存。否则在 RTX 5070 上实测空闲显存只剩下约 200MiB,会导致整个进程卡死。
1250 亿参数摸到了当前游戏显卡架构的物理天花板。Strata 的成绩证明了庞大参数模型不再是云厂商的专属特权。当 12GB 显卡的家用电脑都能在长程任务中压制并跑满 60 tokens/s 时,大模型竞争的游戏规则已经变了。下一次算力突破的重心,也许就不再是单张显卡有多强,而是主板的内存总线该如何重构。
参考链接:
- Strata 仓库 README 与测试数据
- Qwen 模型发布公告