Un ordinateur de bureau standard équipé d’une carte graphique de jeu dotée de 12 Go de VRAM est désormais capable d’exécuter avec fluidité un modèle de langage de pointe de 125 milliards de paramètres à une vitesse soutenue de 60 tokens par seconde.
Pendant des années, l’exécution de modèles dépassant la centaine de milliards de paramètres est restée le pré carré des grands centres de données. Louer des serveurs rack multi-GPU constituait le droit d’entrée obligatoire. En 2026, trois bouleversements concomitants ont fait voler ce paradigme en éclats : la libération des poids des modèles frontières, la maturité des architectures à activation clairsemée (Mixture-of-Experts ou MoE) et l’essor de techniques de quantification poussées à leurs limites physiques extrêmes. Le moteur d’inférence open source Strata s’appuie sur une stratégie d’ordonnancement matériel étagé particulièrement agressive pour loger Qwen3.8-Flash-Next sous un bureau ordinaire. Le coût marginal de l’intelligence artificielle s’est déplacé des factures cloud mensuelles vers la simple consommation électrique d’un ordinateur que l’on possède déjà. Dans le même temps, le véritable goulet d’étranglement technique s’est déplacé de la coûteuse VRAM vers la bande passante de la mémoire vive et la vitesse de lecture des disques SSD.
Faire tenir 125 milliards de paramètres dans 12 Go de VRAM
Faire tenir 125 milliards de paramètres dans 12 Go de mémoire vidéo ressemble à première vue à une tentative de faire entrer un éléphant dans un réfrigérateur. Cependant, les architectures contemporaines sont loin d’être des blocs monolithiques indivisibles. Si Qwen3.8-Flash-Next affiche 125 milliards de paramètres au total, il repose sur une structure MoE intégrant 24 576 réseaux d’« experts » à granularité fine. Lors de la génération de chaque token, le routeur n’active que les 10 experts les plus pertinents. Dès lors, le volume de paramètres réellement mobilisé pour chaque calcul n’excède pas 6 milliards.
Strata tire parti de cette parcimonie architecturale extrême pour redistribuer de fond en comble la charge de travail entre les composants matériels. Le moteur maintient en permanence plusieurs milliers d’« experts chauds », les plus fréquemment sollicités, dans les 12 Go de VRAM, garantissant ainsi que les calculs critiques les plus intenses soient exécutés sur le silicium le plus véloce. En parallèle, les dizaines de milliers d’« experts froids » restants sont stockés dans la mémoire vive (RAM) de la carte mère. Cette stratégie d’interception par couches successives contourne avec brio l’étroitesse de la mémoire vidéo qui paralysait jusqu’ici les GPU grand public.
La mémoire système et le processeur prennent ensuite le relais de manière transparente. Lorsqu’un terme inhabituel nécessite de faire appel à un expert froid, le système contourne la carte graphique pour solliciter directement le CPU, mobilisant les jeux d’instructions vectorielles AVX-512 ou AVX2 pour le calcul parallèle. Ce mécanisme de mise en cache hiérarchique fait voler en éclats le dogme selon lequel la VRAM serait la seule variable déterminante pour l’inférence locale. Grâce à une optimisation rigoureuse de l’ingénierie système, un matériel classique devient tout à fait capable de dompter d’immenses volumes de paramètres par la seule vertu d’un ordonnancement intelligent.
Décodage spéculatif et validation par lots : une vitesse dédoublée
La mise en cache étagée ne suffit toutefois pas à elle seule pour extraire la quintessence des performances d’un silicium grand public. Pour accélérer encore davantage la cadence de génération, le modèle intègre une tête de prédiction multi-tokens (Multi-Token Prediction / MTP) forte de 4 milliards de paramètres. Ce sous-modèle léger intervient comme éclaireur en anticipant à grande vitesse la suite des tokens. Le gigantesque modèle principal de 125B valide ensuite ces prédictions de manière groupée, en un seul lot. Comparée à l’émission séquentielle classique mot par mot, cette validation par lots offre un débit infiniment supérieur.
Ce pipeline coopératif de spéculation et de vérification permet de multiplier par 1,6 à 1,8 la vitesse finale de génération. Avec le profil de quantification Q2_0, qui pousse la compression à son maximum, une configuration de test associant une Nvidia GeForce RTX 5070 et un processeur AMD Ryzen 5 7600 a atteint la cadence remarquable de 94 tokens par seconde. Même sous le profil IQ3_XXS, plus fidèle et précis, la vitesse est demeurée solidement stabilisée à 62 tokens par seconde. Optimiser les grands modèles ne se résume plus à tronquer aveuglément le nombre de paramètres ; en repensant le pipeline d’exécution, le plafond de performance des composants grand public a été relevé de force.
Ce bond en avant concerne tout autant le traitement des requêtes initiales (prefill). Confronté à un prompt long de 32 000 tokens, le système l’ingère à la vitesse foudroyante de 2 650 tokens par seconde. Pour traiter les documents très longs en toute sécurité, l’environnement segmente la lecture par blocs de 8 192 tokens au maximum, évitant ainsi que les contextes massifs ne saturent la mémoire en cours de route. Qwen3.8-Flash-Next gère nativement une fenêtre de contexte de 260 000 tokens — extensible jusqu’à 1 million grâce aux techniques YaRN —, offrant ainsi à un simple ordinateur domestique la capacité d’ingérer et d’analyser des romans entiers en un clin d’œil.
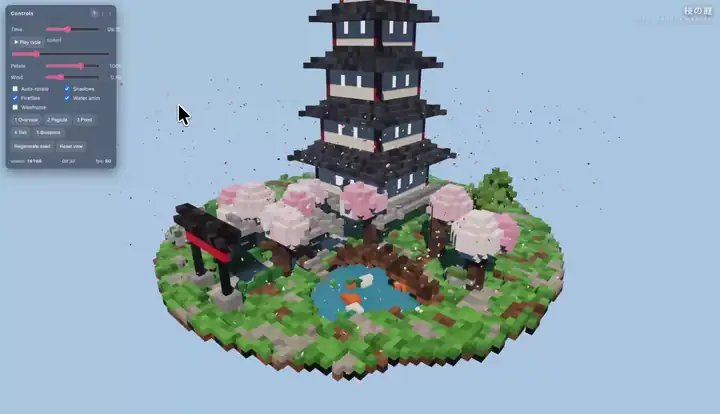 Figure : Jardin de pagodes en voxels généré à partir d’un seul prompt, exécuté en direct dans le navigateur. Source : README du dépôt Strata
L’exécution locale se substitue aux services cloud
Dès lors que la vitesse de génération et l’étendue du contexte atteignent des seuils d’utilisabilité concrets, le déploiement local s’émancipe de son statut d’expérimentation pour passionnés. Strata déploie sur localhost un service dont les points de terminaison sont rigoureusement compatibles avec les spécifications des API d’OpenAI et d’Anthropic. Les développeurs n’ont aucunement besoin de revoir leurs habitudes de programmation ni de reconfigurer leurs outils. Les poids des modèles sont automatiquement rapatriés depuis Hugging Face par des scripts d’installation, intégrant en toute simplicité la puissance de la machine locale dans les chaînes d’outils d’IA modernes.
Qu’il s’agisse de solutions d’assistance au codage telles que Cursor ou d’agents autonomes à l’image de Claude Code, les requêtes peuvent désormais cibler directement cette adresse locale. Cette approche coupe net le lien de dépendance physique envers les API des géants du cloud. Les développeurs n’ont plus à surveiller des factures mensuelles en perpétuelle hausse, ni à composer avec les risques de sécurité et de confidentialité inhérents au transit de code propriétaire sur des réseaux tiers. Tant que la machine reste allumée, la puissance d’un modèle d’élite s’exprime sans interruption ni surcoût.
La souplesse de cette architecture s’affranchit également des cloisonnements matériels. Sur une carte AMD Radeon RX 9070 XT dotée de 16 Go de VRAM, le moteur atteint également la barre des 60 tokens par seconde en précision Q2_0. L’ensemble s’appuie sur le socle éprouvé de llama.cpp et ggml, combiné aux méthodes de quantification avancées développées par ISTA-DASLab et Unsloth pour compacter des modèles gigantesques sur des PC domestiques. L’écosystème du matériel grand public prend forme : la puissance de calcul de l’IA reflue des data centers centralisés pour revenir directement sur le bureau des développeurs.
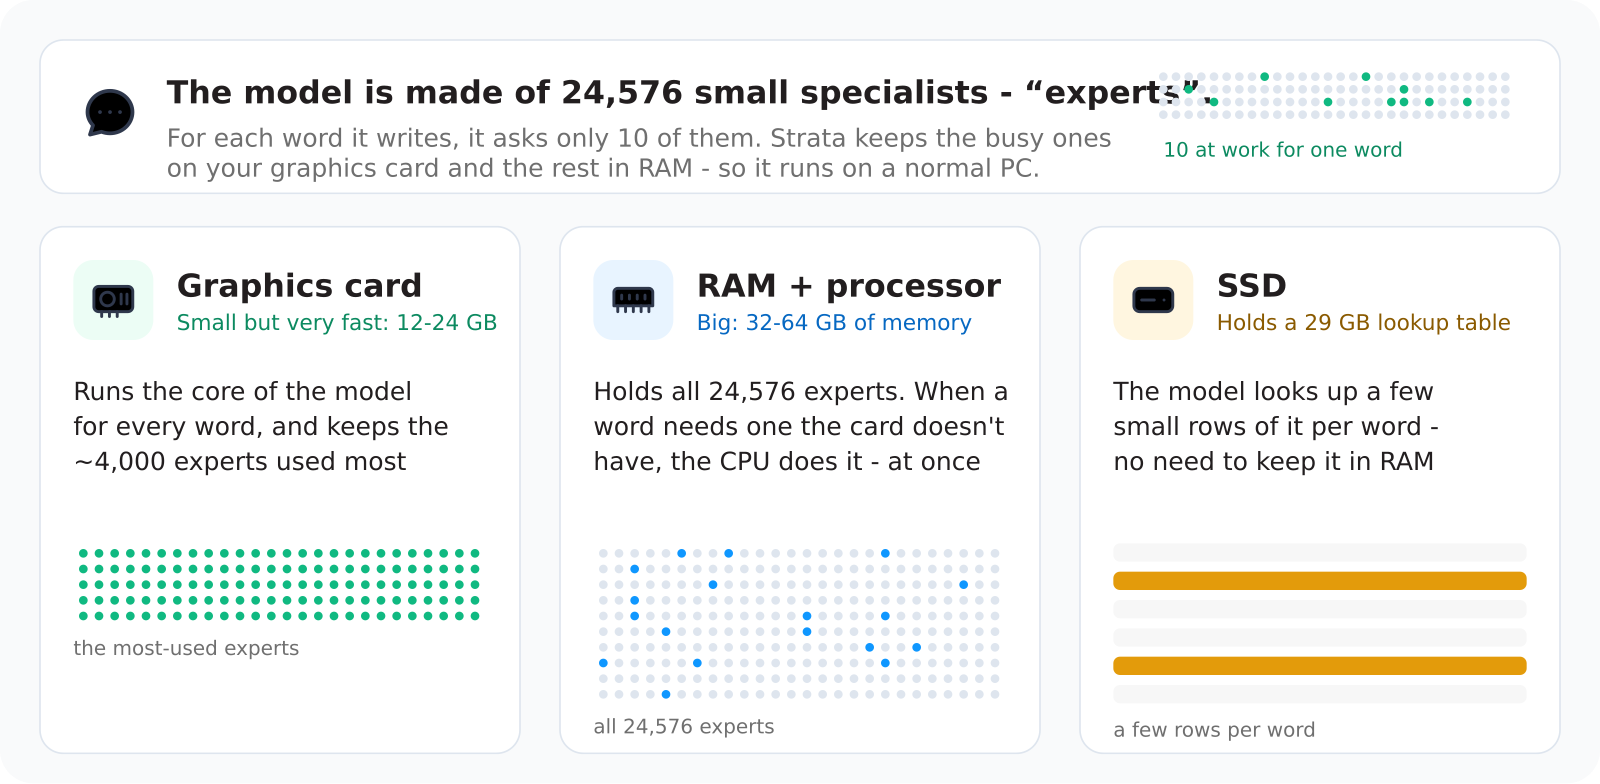 Figure : Schéma officiel d’ordonnancement matériel illustrant la répartition des données entre VRAM, mémoire système, CPU et SSD. Source : Strata repository docs/media
Le véritable goulet d’étranglement bascule vers le stockage
Rapatrier la puissance d’un centre de calcul sur un bureau ne va cependant pas sans quelques heurts. Dès l’instant où la carte graphique cesse d’être le facteur limitant exclusif, une pression d’entrée-sortie colossale se reporte sur les autres composants du PC. Afin de soutenir le rythme du décodage spéculatif, l’architecture incorpore une gigantesque table de plongements n-gram de 51 milliards de paramètres, mappée directement sur le disque SSD NVMe sous forme de table de correspondance persistante.
La vitesse de lecture du support de stockage devient ainsi le nouvel écueil du système. Les très grands modèles imposent la lecture continue d’immenses fichiers de poids ; la version par défaut quantifiée en Unsloth UD-IQ4_XS pèse à elle seule 94 Go sur le disque. Si un ordinateur dispose de moins de 80 Go de mémoire vive physique pour charger l’intégralité des réseaux d’experts, le système est contraint de lire en temps réel sur le SSD les experts froids manquants au fil de la génération de texte. Dès que des accès disques interviennent en cours d’inférence, la fluidité de sortie s’effondre brutalement. Une fois le défi du calcul brut surmonté, c’est la bande passante du bus de données qui détermine le plancher de performance.
Par ailleurs, l’enveloppe de 12 Go de VRAM est poussée dans ses derniers retranchements physiques. Si des images sont injectées au milieu de la génération textuelle pour solliciter les capacités multimodales, l’encodeur visuel sature instantanément la marge résiduelle de mémoire vidéo. La documentation officielle impose formellement de réserver 1 Go de VRAM par un paramètre en ligne de commande avant tout traitement d’images. Faute de cette précaution, il ne reste qu’environ 200 Mio de VRAM libre sur une RTX 5070, provoquant immanquablement le blocage complet du processus.
Faire tourner 125 milliards de paramètres frôle la limite physique des cartes graphiques grand public de dernière génération. Pourtant, la prouesse accomplie par Strata prouve que les modèles d’envergure ne sont plus la chasse gardée des géants du cloud. Lorsqu’un ordinateur personnel équipé de 12 Go de mémoire vidéo parvient à soutenir plus de 60 tokens par seconde sur des tâches à long contexte, les règles de la compétition en matière d’IA sont durablement transformées. La prochaine rupture matérielle ne dépendra plus seulement de la puissance brute d’un GPU isolé, mais de la manière dont les bus mémoire des cartes mères seront repensés pour accueillir l’IA locale.
Liens de référence :
- README et données de benchmark du dépôt Strata
- Annonce officielle de sortie du modèle Qwen