Un ordenador de sobremesa estándar equipado con una tarjeta gráfica de 12 GB de VRAM ya es capaz de ejecutar un modelo de lenguaje de 125 mil millones (125B) de parámetros a una velocidad sostenida y fluida de 60 tokens por segundo.
Durante años, ejecutar modelos de más de cien mil millones de parámetros fue un privilegio exclusivo de los grandes centros de datos. Alquilar costosos servidores en rack con múltiples GPU de gama alta representaba el peaje obligatorio para sentarse a la mesa. En 2026, tres transformaciones simultáneas han derribado esa barrera: la liberación de pesos de modelos punteros, la maduración de arquitecturas de mezcla de expertos (Mixture-of-Experts o MoE) con activación dispersa y las técnicas de cuantización extrema llevadas al límite físico. El motor de inferencia de código abierto Strata emplea una agresiva estrategia de planificación jerárquica de hardware para meter Qwen3.8-Flash-Next debajo de un escritorio convencional. El coste marginal de la inteligencia de vanguardia ha pasado de facturas mensuales recurrentes en la nube al mero consumo eléctrico de un PC que el usuario ya posee. En el camino, el verdadero cuello de botella técnico se ha desplazado de la costosa memoria VRAM al ancho de banda de la RAM del sistema y a la velocidad de lectura de las unidades SSD.
125 mil millones de parámetros en 12 GB de VRAM
Meter 125 mil millones de parámetros en 12 GB de memoria de vídeo parece, a primera vista, como intentar meter un elefante en una nevera doméstica. Sin embargo, los modelos de frontera actuales distan mucho de ser bloques monolíticos indivisibles. Aunque Qwen3.8-Flash-Next cuenta con 125 mil millones de parámetros totales, adopta una arquitectura MoE compuesta por 24.576 redes de expertos de granularidad fina. Al generar cada token, el sistema solo activa los 10 expertos más relevantes. En consecuencia, la carga computacional real calculada en cada paso se reduce a unos 6 mil millones de parámetros activos.
Strata aprovecha esta extrema dispersión arquitectónica para redistribuir por completo la carga de trabajo entre los componentes de hardware. Mantiene permanentemente varios miles de los «expertos calientes» más utilizados en los 12 GB de VRAM, garantizando que las operaciones matemáticas más críticas y frecuentes corran sobre el silicio más rápido. Al mismo tiempo, las decenas de miles de «expertos fríos» restantes se almacenan íntegramente en la memoria RAM de la placa base. Esta estrategia de interceptación por niveles esquiva con ingenio la estricta limitación de VRAM que tradicionalmente asfixiaba a las GPU de consumo.
A partir de ahí, la memoria del sistema y la CPU toman el relevo. Cuando un término poco habitual requiere la intervención de un experto frío, el motor elude la GPU y deriva la tarea directamente al procesador central, aprovechando los conjuntos de instrucciones vectoriales AVX-512 o AVX2 para el cálculo en paralelo. Este mecanismo de caché escalonada pulveriza el dogma de que la inferencia depende exclusivamente de la VRAM. Con una optimización rigurosa de ingeniería de sistemas, el hardware doméstico demuestra ser perfectamente capaz de domar cúmulos masivos de parámetros mediante una planificación inteligente.
Predicción especulativa y validación: duplicando la velocidad
Sin embargo, el almacenamiento en caché por niveles no basta por sí solo para exprimir hasta la última gota de rendimiento del silicio convencional. Con el fin de acelerar aún más la generación de texto, el modelo incorpora un cabezal de predicción multitioken (Multi-Token Prediction / MTP) de 4 mil millones de parámetros. Este submódulo ligero actúa como avanzadilla, anticipando con rapidez la secuencia de los siguientes tokens. A continuación, el descomunal modelo base de 125B valida estas hipótesis en un único lote agrupado. En comparación con la emisión secuencial clásica de un token por paso, la validación por lotes multiplica drásticamente el rendimiento del sistema.
Esta canalización coordinada de especulación y validación eleva la velocidad final de generación entre 1,6 y 1,8 veces. En el perfil de cuantización de mayor compresión, Q2_0, un equipo de pruebas compuesto por una Nvidia GeForce RTX 5070 y un procesador AMD Ryzen 5 7600 alcanzó la impresionante cifra de 94 tokens por segundo. Incluso con el perfil IQ3_XXS, de mayor precisión y fidelidad, la tasa de salida se mantuvo firme en 62 tokens por segundo. Optimizar grandes modelos ya no consiste únicamente en podar parámetros a ciegas; al reconfigurar la canalización de ejecución, el techo de rendimiento del hardware doméstico se ha elevado por la fuerza.
Este salto no se limita a la generación de respuestas, sino que abarca también el procesamiento del contexto inicial (prefill). Al introducir un prompt de 32.000 tokens de longitud, el sistema lo procesa a una velocidad vertiginosa de 2.650 tokens por segundo. Para gestionar textos kilométricos de forma segura, el entorno fragmenta la lectura en bloques de un máximo de 8.192 tokens, evitando que las ventanas de contexto extensas saturen la memoria a mitad de tarea. Qwen3.8-Flash-Next admite de forma nativa una ventana de 260.000 tokens —ampliable a 1 millón mediante técnicas YaRN—, otorgando a un ordenador doméstico la capacidad de digerir y analizar novelas completas de una sola vez.
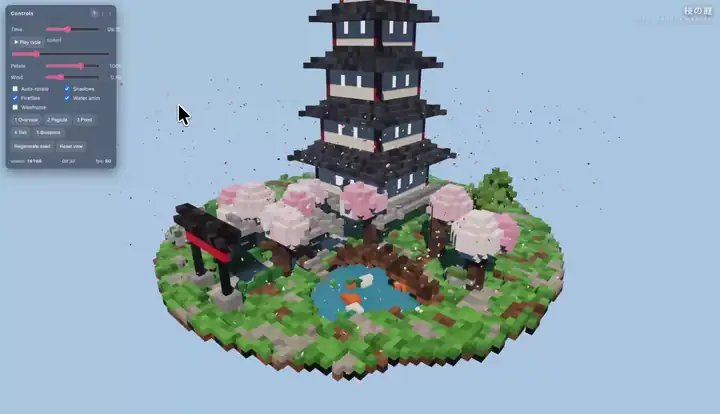 Figura: Jardín de pagodas vóxel generado a partir de un único prompt y ejecutado en el navegador. Fuente: README del repositorio Strata
La ejecución local sustituye a los servicios en la nube
Una vez que la velocidad de generación y la longitud de contexto rebasan el umbral de utilidad práctica, el despliegue local deja de ser un mero pasatiempo para entusiastas. Strata levanta un servicio en localhost cuyas interfaces son plenamente compatibles con las especificaciones de las API de OpenAI y Anthropic. Los desarrolladores no necesitan cambiar sus herramientas habituales ni modificar una sola línea de sus entornos de programación. Los scripts de instalación descargan automáticamente los pesos desde Hugging Face, integrando la potencia del PC local en los flujos de trabajo de IA actuales sin fricción alguna.
Ya se trate de entornos de codificación asistida como Cursor o de agentes autónomos como Claude Code, las solicitudes pueden dirigirse directamente a este servidor local. Esto corta de raíz la dependencia física respecto a las costosas API en la nube. Los desarrolladores ya no tienen que vigilar facturas mensuales que crecen sin parar ni preocuparse por los riesgos de seguridad derivados de enviar código confidencial a través de la red. Mientras el ordenador permanezca encendido, la capacidad de cómputo de un modelo puntero fluye de manera ininterrumpida.
La versatilidad del sistema trasciende también las barreras entre fabricantes. En una tarjeta gráfica AMD Radeon RX 9070 XT con 16 GB de VRAM, el motor alcanza idénticamente 60 tokens por segundo con precisión Q2_0. Todo el desarrollo se asienta sobre las contrastadas bases de código abierto de llama.cpp y ggml, adoptando las fórmulas de cuantización avanzadas ideadas por ISTA-DASLab y Unsloth para condensar modelos mastodónticos en equipos domésticos. El ecosistema del hardware de consumo empieza a consolidarse: la potencia de cálculo de la IA regresa de los centros de datos centralizados a las mesas de trabajo de los desarrolladores.
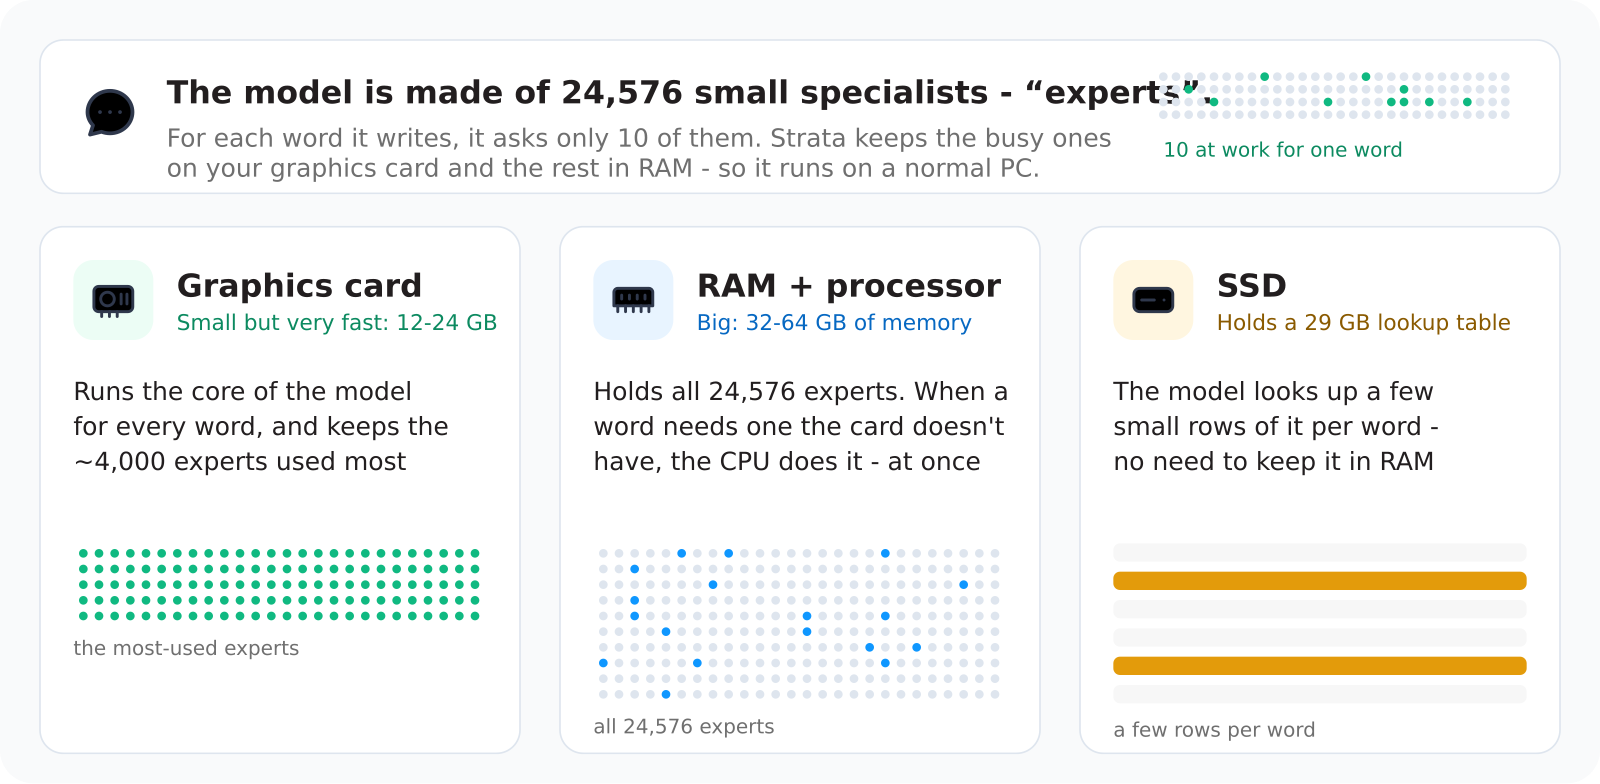 Figura: Diagrama oficial de planificación de hardware que muestra la distribución de datos entre VRAM, memoria del sistema, CPU y SSD. Fuente: Strata repository docs/media
El verdadero cuello de botella se traslada al almacenamiento
El proceso de trasladar la infraestructura de cálculo al escritorio personal no está exento de fricciones. Cuando la tarjeta gráfica deja de ser el obstáculo principal, la intensa presión de entrada y salida se transfiere de inmediato al resto de componentes. Para sostener el ritmo de la ejecución especulativa, el sistema incorpora una gigantesca tabla de incrustaciones n-gram de 51 mil millones de parámetros, alojada directamente en la unidad SSD NVMe como estructura de consulta permanente.
En consecuencia, el ancho de banda de lectura del almacenamiento secundario se convierte en el nuevo escollo. Los grandes modelos exigen transferir continuamente volúmenes ingentes de pesos; la versión cuantizada por defecto Unsloth UD-IQ4_XS ocupa nada menos que 94 GB en disco. Si el ordenador cuenta con menos de 80 GB de memoria RAM física para cargar la totalidad de las redes de expertos, el sistema se ve forzado a leer en tiempo real desde el SSD los expertos fríos que falten durante la generación de texto. En el instante en que se producen lecturas en disco durante la inferencia, la fluidez sufre una caída en picado. Una vez resuelta la capacidad de cómputo, el ancho de banda del bus fija el suelo infranqueable del rendimiento.
Asimismo, la dotación de 12 GB de VRAM se encuentra exprimida hasta su frontera física. Si durante la generación de texto se introducen imágenes para su análisis multimodal, el codificador visual satura al instante el escaso margen de VRAM disponible. La guía oficial de despliegue advierte de forma explícita que, al procesar imágenes, se debe reservar manualmente 1 GB de VRAM mediante un parámetro de línea de comandos. Sin este resguardo, en una RTX 5070 apenas quedan unos 200 MiB libres, lo que desemboca irremediablemente en el bloqueo del proceso.
Manejar 125 mil millones de parámetros roza el techo físico de la actual generación de tarjetas gráficas de consumo. Con todo, el hito de Strata demuestra que los modelos a gran escala han dejado de ser coto reservado de los gigantes de la nube. Cuando un PC doméstico con 12 GB de VRAM puede despachar tareas complejas de largo contexto superando de forma constante los 60 tokens por segundo, las reglas de juego de la inteligencia artificial han cambiado para siempre. El próximo salto decisivo ya no dependerá exclusivamente de la potencia bruta de una sola GPU, sino de cómo se rediseñen los buses de memoria y la arquitectura de las placas base para la IA local.
Enlaces de referencia:
- README y datos de pruebas del repositorio Strata
- Anuncio de lanzamiento del modelo Qwen