Ein gewöhnlicher Desktop-PC mit einer Gaming-Grafikkarte und 12 GB VRAM kann heute ein hochentwickeltes Sprachmodell mit 125 Milliarden Parametern flüssig und mit stabilen 60 Tokens pro Sekunde ausführen.
Lange Zeit galt der Betrieb von Modellen jenseits der 100-Milliarden-Parameter-Grenze als exklusives Privileg großer Rechenzentren. Das Mieten kostspieliger Rack-Server mit mehreren Highend-GPUs war die unvermeidbare Eintrittskarte. Im Jahr 2026 wurde dieses Dogma durch drei parallele Entwicklungen gekippt: die breite Verfügbarkeit offener Modellgewichte, die Reife feinkörniger Mixture-of-Experts-Architekturen (MoE) und extreme Quantisierungsverfahren, die bis an die physikalischen Grenzen gehen. Die quelloffene Inferenz-Engine Strata nutzt eine aggressive, hierarchische Hardware-Scheduling-Pipeline, um Qwen3.8-Flash-Next direkt auf gewöhnliche Schreibtische zu bringen. Die Grenzkosten für Spitzen-KI verlagern sich damit von wiederkehrenden monatlichen Cloud-Rechnungen auf die reinen Stromkosten eines ohnehin vorhandenen Rechners. Gleichzeitig wandert der entscheidende Flaschenhals von teurem VRAM hin zur Bandbreite des Arbeitsspeichers und den Lesegeschwindigkeiten von NVMe-SSDs.
125 Milliarden Parameter in 12 GB VRAM
125 Milliarden Parameter in 12 GB Grafikspeicher unterzubringen, klingt zunächst wie der Versuch, einen Elefanten in einen Haushaltskühlschrank zu zwängen. Doch moderne Spitzenmodelle sind längst keine monolithischen Rechenblöcke mehr. Obwohl Qwen3.8-Flash-Next insgesamt 125 Milliarden Parameter umfasst, basiert es auf einer Mixture-of-Experts-Architektur mit 24.576 fein abgestuften Experten-Netzwerken. Bei der Generierung jedes einzelnen Wortes aktiviert das Gating-Netzwerk lediglich die 10 relevantesten Experten. Die tatsächlich berechnete Parameterlast pro Generierungsschritt schrumpft dadurch auf gerade einmal 6 Milliarden Parameter zusammen.
Strata nutzt diese extreme architektonische Sparsity gezielt aus und strukturiert die Lastverteilung der Hardware grundlegend um. Mehrere tausend der am häufigsten abgerufenen „heißen Experten“ verbleiben dauerhaft im 12 GB großen VRAM der GPU. Dadurch wird sichergestellt, dass die rechenintensivsten Kernoperationen auf dem schnellsten Rechenchip ablaufen. Die verbleibenden zehntausenden „kalten Experten“ lagert das System hingegen vollständig in den DDR-Arbeitsspeicher des Mainboards aus. Diese gestaffelte Caching-Strategie umgeht die knappen VRAM-Kapazitäten handelsüblicher Grafikkarten elegant.
Arbeitsspeicher und Hauptprozessor übernehmen anschließend nahtlos den restlichen Staffellauf. Erfordert ein seltener Begriff den Abruf eines kalten Experten, umgeht das System die GPU und delegiert die Berechnung direkt an die CPU. Mittels AVX-512- oder AVX2-Befehlssätzen werden die notwendigen Vektoroperationen hochgradig parallel ausgeführt. Dieser hierarchische Caching-Ansatz bricht mit der verbreiteten Annahme, Inferenz hänge ausschließlich vom Grafikspeicher ab. Durch rigorose Systemoptimierung und intelligentes Scheduling meistert selbst Consumer-Hardware gigantische Parameterbestände.
Spekulative Vorhersage und Validierung verdoppeln das Tempo
Ein hierarchischer Cache genügt jedoch noch nicht, um das letzte Quäntchen Leistung aus Standardkomponenten herauszukitzeln. Um die Generierungsgeschwindigkeit weiter zu steigern, integriert das Modell einen 4-Milliarden-Parameter umfassenden Kopf für spekulative Multi-Token-Vorhersage (Multi-Token Prediction / MTP). Dieses kleinere Modell eilt als Späher voraus und schlägt blitzschnell die nächsten Token vor. Das mächtige 125B-Hauptmodell validiert diese Prognosen anschließend in einem einzigen Durchlauf gebündelt (Batch-Validierung). Gegenüber dem klassischen sequenziellen Ausgeben einzelner Token steigert die gebündelte Überprüfung den Gesamtdurchsatz drastisch.
Diese Pipeline aus spekulativer Vorhersage und kollektiver Überprüfung beschleunigt die Ausgabegeschwindigkeit um den Faktor 1,6 bis 1,8. Unter der maximal komprimierenden Q2_0-Quantisierung erzielte ein Testsystem aus einer Nvidia GeForce RTX 5070 und einem AMD Ryzen 5 7600 beachtliche 94 Tokens pro Sekunde. Selbst bei der präziseren IQ3_XXS-Quantisierung hielt das System eine stabile Rate von 62 Tokens pro Sekunde aufrecht. Die Optimierung von Sprachmodellen erschöpft sich nicht mehr im bloßen Kürzen von Parametern; durch die Neuordnung der Ausführungspipeline wird die Leistungsgrenze von Consumer-Hardware signifikant nach oben verschoben.
Auch bei der Verarbeitung von Prompts (Prefill) zeigt sich ein gewaltiger Leistungssprung. Einen Prompt mit 32.000 Tokens liest das System mit atemberaubenden 2.650 Tokens pro Sekunde ein. Bei überlangen Texten unterteilt die Laufzeitumgebung die Daten in Blöcke von maximal 8.192 Tokens, um Speicherüberläufe während komplexer Aufgaben zuverlässig zu verhindern. Qwen3.8-Flash-Next unterstützt nativ ein Kontextfenster von 260.000 Tokens, das sich per YaRN-Skalierung auf bis zu 1 Million Tokens erweitern lässt. Damit wird ein lokaler PC in die Lage versetzt, ganze Romane in einem Zug zu erfassen und zu analysieren.
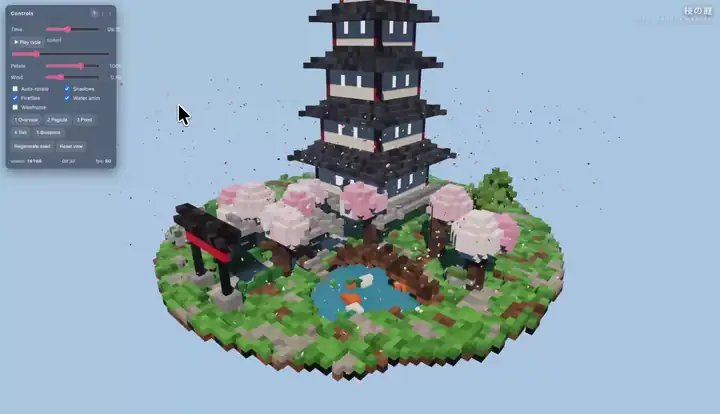 Abb.: Ein aus einem einzelnen Prompt generierter Voxel-Pagodengarten, direkt im Browser ausgeführt. Quelle: Strata-Repository README
Lokale Ausführung verdrängt Cloud-Dienste
Sobald Generierungsgeschwindigkeit und Kontextlänge alltagstaugliche Werte erreichen, verliert das lokale Deployment seinen Status als bloße Spielerei für Technik-Enthusiasten. Strata stellt direkt auf localhost einen Dienst bereit, dessen Schnittstellen vollständig mit den API-Standards von OpenAI und Anthropic kompatibel sind. Entwickler müssen weder ihre gewohnten Werkzeuge noch bestehenden Code anpassen. Modellgewichte werden über Installationsskripte automatisch von Hugging Face geladen, sodass sich die lokale Rechnerleistung reibungslos in moderne Entwicklungs-Pipelines einfügt.
Gleichgültig, ob Cursor für autonome Code-Generierung eingesetzt wird oder Claude-Code-Agenten eigenständig Workflows bearbeiten: Alle Anfragen lassen sich direkt an die lokale Serveradresse leiten. Das kappt die physische Abhängigkeit von kommerziellen Cloud-APIs. Entwickler müssen weder tickende Monatsrechnungen fürchten noch Datenschutzrisiken eingehen, die bei der Übertragung proprietären Codes über externe Server unvermeidlich sind. Solange der eigene Rechner läuft, steht die Rechenleistung eines Spitzenmodells unbegrenzt zur Verfügung.
Die Architektur arbeitet zudem herstellerunabhängig. Auf einer AMD Radeon RX 9070 XT mit 16 GB VRAM erreicht das System unter Q2_0-Präzision ebenfalls solide 60 Tokens pro Sekunde. Die Software setzt auf den erprobten Grundlagen von llama.cpp und ggml auf und nutzt Quantisierungsverfahren von ISTA-DASLab und Unsloth, um monumentale Modelle auf Heimcomputer zu verdichten. Das Ökosystem für Endkunden-Hardware gewinnt zusehends an Substanz: KI-Rechenleistung wandert von zentralisierten Rechenzentren zurück an den Arbeitsplatz des einzelnen Entwicklers.
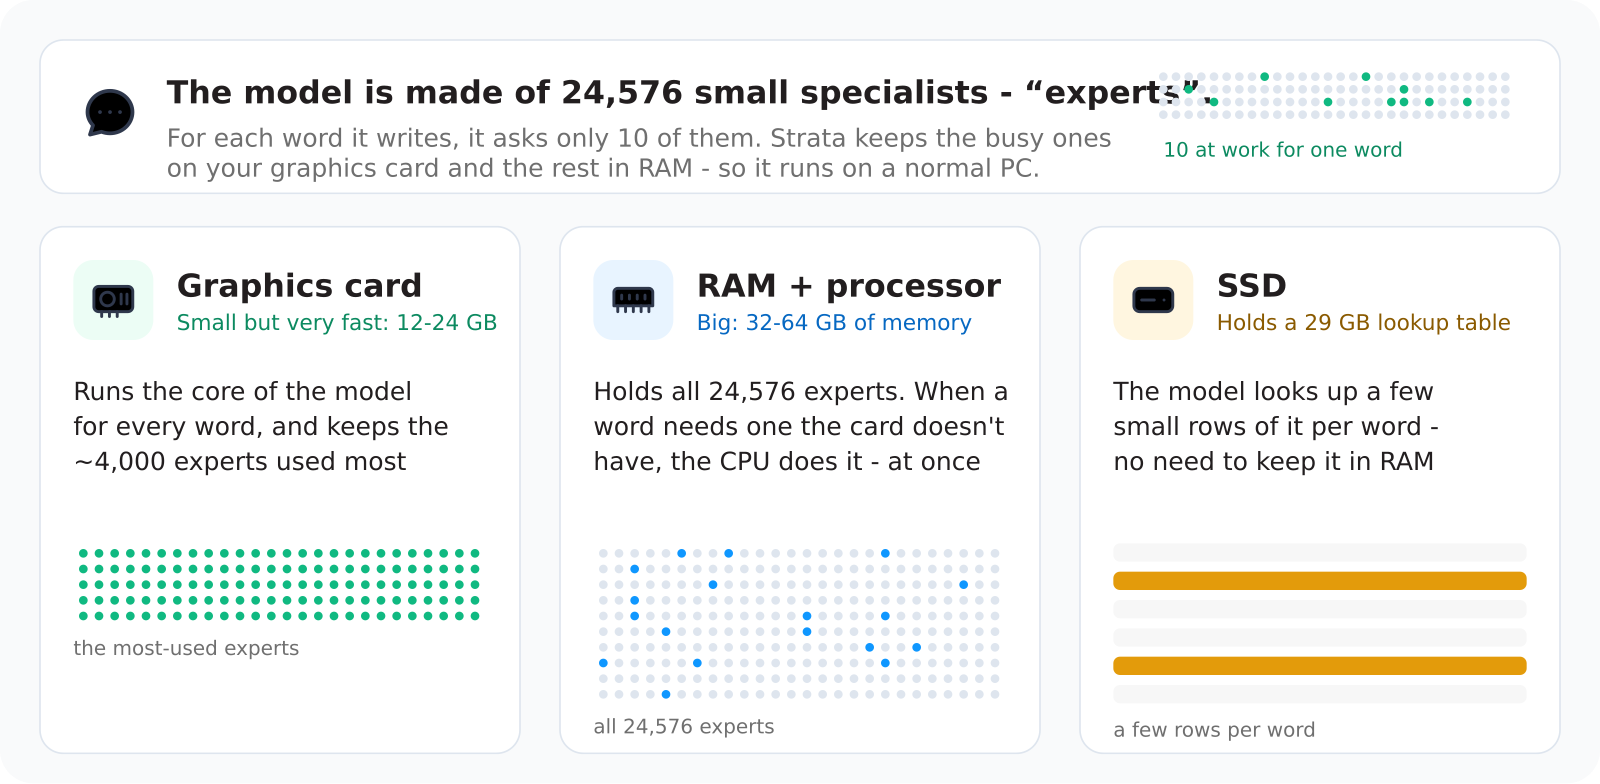 Abb.: Offizielles Diagramm zum Hardware-Scheduling mit der Verteilung der Daten auf VRAM, RAM, CPU und SSD. Quelle: Strata-Repository docs/media
Der eigentliche Flaschenhals verlagert sich auf die SSD
Die Verlagerung von Server-Rechenleistung auf den Desktop verläuft jedoch nicht völlig ohne Reibungsverluste. Sobald die Grafikkarte nicht mehr der alleinige Engpass ist, wandert der Druck unmittelbar auf benachbarte Hardware-Komponenten ab. Um die spekulative Ausführung aufrechtzuerhalten, benötigt das Modell eine 51 Milliarden Parameter große n-Gramm-Embedding-Tabelle, die direkt als Lookup-Tabelle auf einer NVMe-SSD abgelegt wird.
Dadurch rückt die Lesegeschwindigkeit des Sekundärspeichers als neuer Engpass in den Mittelpunkt. Große Modelle müssen gewaltige Datenmengen permanent nachladen; die standardmäßige Unsloth UD-IQ4_XS-Quantisierung beansprucht allein 94 GB Speicherplatz auf dem Datenträger. Verfügt ein PC über weniger als 80 GB physischen Arbeitsspeicher und kann nicht alle Experten-Netzwerke im RAM vorhalten, muss das System während der Textgenerierung fehlende kalte Experten in Echtzeit von der SSD nachstreamen. Sobald solche Lesezugriffe über den Datenträger nötig werden, bricht die flüssige Generierung drastisch ein. Ist die reine Rechenleistung gesichert, bestimmt die Busbandbreite die Untergrenze der Leistungsfähigkeit.
Gleichzeitig wird das 12-GB-VRAM-Budget bis an die Belastungsgrenze ausgereizt. Werden während der Textgenerierung zusätzlich Bilder eingespeist, überlastet der Vision-Encoder umgehend den verbliebenen VRAM-Puffer. Die offizielle Dokumentation schreibt daher vor, bei Bildverarbeitungsaufgaben über einen Startparameter manuell 1 GB VRAM zu reservieren. Fehlt dieser Puffer, verbleiben auf einer RTX 5070 lediglich rund 200 MiB freier Speicher, was unweigerlich zum Einfrieren des gesamten Prozesses führt.
125 Milliarden Parameter markieren die derzeitige physikalische Obergrenze aktueller Consumer-Grafikkarten. Doch die Resultate von Strata belegen eindrucksvoll, dass Modelle dieser Größenordnung kein exklusives Privileg der Cloud-Giganten mehr sind. Wenn ein herkömmlicher PC mit 12 GB Grafikspeicher bei langen Kontexten dauerhaft mehr als 60 Tokens pro Sekunde liefert, haben sich die Spielregeln für Sprachmodelle grundlegend gewandelt. Der nächste technologische Durchbruch wird daher weniger von der reinen Rechenleistung einzelner GPUs abhängen, sondern davon, wie Speicherbusse und Mainboard-Architekturen für lokale KI neu gestaltet werden.
Weiterführende Links:
- Strata-Repository README und Benchmark-Daten
- Qwen-Modell-Veröffentlichungsankündigung