12GBのVRAMを搭載した一般的なゲーミングPCで、1250億(125B)パラメータを誇る最先端の大規模言語モデルが、秒間60トークンという滑らかな速度で動作する時代が到来した。
これまで、1000億パラメータを超えるフロンティアモデルの実行は、巨大データセンターの特権だった。マルチGPUのラックマウントサーバーを高額でレンタルすることだけが、このゲームに参加するための入場料とされてきた。だが2026年、その前提は3つの要因によって同時に打破された。モデル重みのオープン化、疎結合な活性化を実現するMixture-of-Experts(MoE)アーキテクチャの成熟、そして精度限界まで削り込む極限の量子化技術である。オープンソース推論エンジン「Strata」は、徹底的なハードウェア階層スケジューリングによって、Qwen3.8-Flash-Nextを一般ユーザーのデスク下へと収めてみせた。推論にかかる限界コストは、毎月請求されるクラウド利用料から、手元にあるPCの電気代へと変貌を遂げた。そして真の技術的ハードルは、高価なVRAM容量から、マザーボードのシステムメモリやSSDの読み込み帯域へと移行しつつある。
12GBのVRAMに1250億パラメータを収める
12GBのビデオメモリに1250億ものパラメータを詰め込むというのは、まるで冷蔵庫に象を押し込むような話に聞こえる。しかし現代の大規模モデルは、決して分割不可能な一枚岩の塊ではない。Qwen3.8-Flash-Nextは総パラメータ数こそ1250億に達するものの、内部は24,576個のきめ細かな「エキスパート」ネットワークで構成されたMoEアーキテクチャを採用している。1つのトークンを生成する際、システムが呼び出すのはそのうち関連度の高い上位10個のエキスパートに過ぎない。つまり、実際の1ステップごとの計算で活性化されるパラメータは、わずか60億(6B)程度にとどまる。
Strataはこの極めてスパース(疎)なアーキテクチャ特性を的確に捉え、ハードウェアの負荷分散を根本から再設計した。もっとも頻繁に呼び出される数千個の「ホットエキスパート」を12GBのVRAM上に常駐させ、コアとなる高頻度の演算処理を最速のシリコンで実行する。一方で、残る数万個の「コールドエキスパート」は、マザーボード上の大容量システムメモリ(RAM)へと退避させる。この階層キャッシュによるインターセプト戦略が、民生用グラフィックカードの深刻なVRAM不足という弱点を鮮やかに回避した。
そして、システムメモリとCPUがリレーのバトンを受け取る。稀に出現するトークンがコールドエキスパートを必要とした場合、システムはGPUを介さず直接CPUを駆動し、AVX-512またはAVX2命令セットを用いて並列ベクトル演算を実行する。この階層型キャッシュ機構は「VRAM至上主義」の固定観念を打ち砕いた。高度なシステムエンジニアリングによって、手頃なハードウェアであっても、適切なスケジューリングさえあれば巨大なパラメータ群を十分に手懐けられることが証明されたのだ。
推測と検証で生成速度を倍増させる
だが、階層型キャッシュだけでハードウェアの潜在能力を限界まで絞り出すことはできない。生成速度をさらに引き上げるため、このモデルには40億(4B)パラメータの多重トークン予測(Multi-Token Prediction / MTP)ヘッドが組み込まれている。この軽量なサブモデルが先兵となり、次に続く数トークンを高速に推測する。続いて巨大な125Bメインモデルが、それらの推測結果を一括(バッチ)で検証する。1トークンずつ順番に生成する従来のアウトプット方式に比べ、バッチ検証のスループット効率は桁違いに高い。
この「推測と検証」の連携パイプラインによって、最終的な生成速度は一挙に1.6倍から1.8倍へと跳ね上がった。圧縮率がもっとも高いQ2_0量子化では、GeForce RTX 5070とAMD Ryzen 5 7600を搭載した検証環境で秒間94トークンという驚異的な数値を記録。より高精度なIQ3_XXS量子化においても、秒間62トークンという安定した実用速度を維持した。モデルの最適化とは、もはやパラメータを盲目的に削ることだけではない。実行パイプラインそのものを再構成することで、民生用ハードウェアの性能限界が力ずくで引き上げられた。
飛躍的な進化はトークン生成だけでなく、プロンプト処理(プリフィル)にも及んでいる。32,000トークンに及ぶ長大な入力であっても、毎秒2,650トークンという猛烈な速度で一気に読み込む。長文処理時には最大8,192トークン単位でチャンク分割して処理するため、途中でメモリが枯渇してクラッシュする心配もない。Qwen3.8-Flash-Nextは標準で26万トークン、YaRN技術の併用により最大100万トークンのコンテキストウィンドウをサポートしており、デスクトップPC上で長編小説を丸ごと一冊飲み込ませることも現実のものとなった。
 図:1回のプロンプトから生成され、ブラウザ上で動作するボクセル仏塔庭園。提供:Strata リポジトリ README
ローカル実行がクラウドサービスを置き換える
生成速度とコンテキスト長の実用性が十分に確立されたことで、ローカルモデルの運用は単なるギークのおもちゃではなくなった。Strataはローカルマシンの localhost 上で、OpenAIおよびAnthropicのAPI仕様と完全互換のサーバーを立ち上げる。開発者はこれまでのコーディング環境やAPIクライアントの設定をほぼ変更する必要がない。モデルファイルもセットアップスクリプトを介してHugging Faceから自動ダウンロードされ、手元のハードウェアを既存のAIツールチェーンへ即座に統合できる。
Cursorによる自動コード補完であれ、自律動作するClaude Codeエージェントであれ、リクエストの送信先をこのローカルアドレスへと向けるだけでよい。これにより、巨大IT企業が提供する商用クラウドAPIへの物理的依存から完全に脱却できる。かさみ続けるAPI請求書に怯える必要もなければ、企業の重要コードをクラウド経由で送信する際の情報漏洩リスクに頭を抱える必要もない。マシンを起動している限り、最先端クラスのモデル演算パワーが手元で湧き出し続ける。
このシステムの汎用性は、GPUベンダーの垣根をも超えている。AMDのRadeon RX 9070 XT(16GB VRAM)においても、Q2_0精度で同じく秒間60トークンをマークした。基盤には広く普及しているllama.cppやggmlのコードを活用し、ISTA-DASLabやUnslothが開発した先進的な量子化アルゴリズムを導入することで、巨大モデルを家庭用PCへと凝縮した。民生用ハードウェアを支えるエコシステムが着実に立ち上がり、AIの計算資源は集中型のデータセンターから開発者のデスクへと回流し始めている。
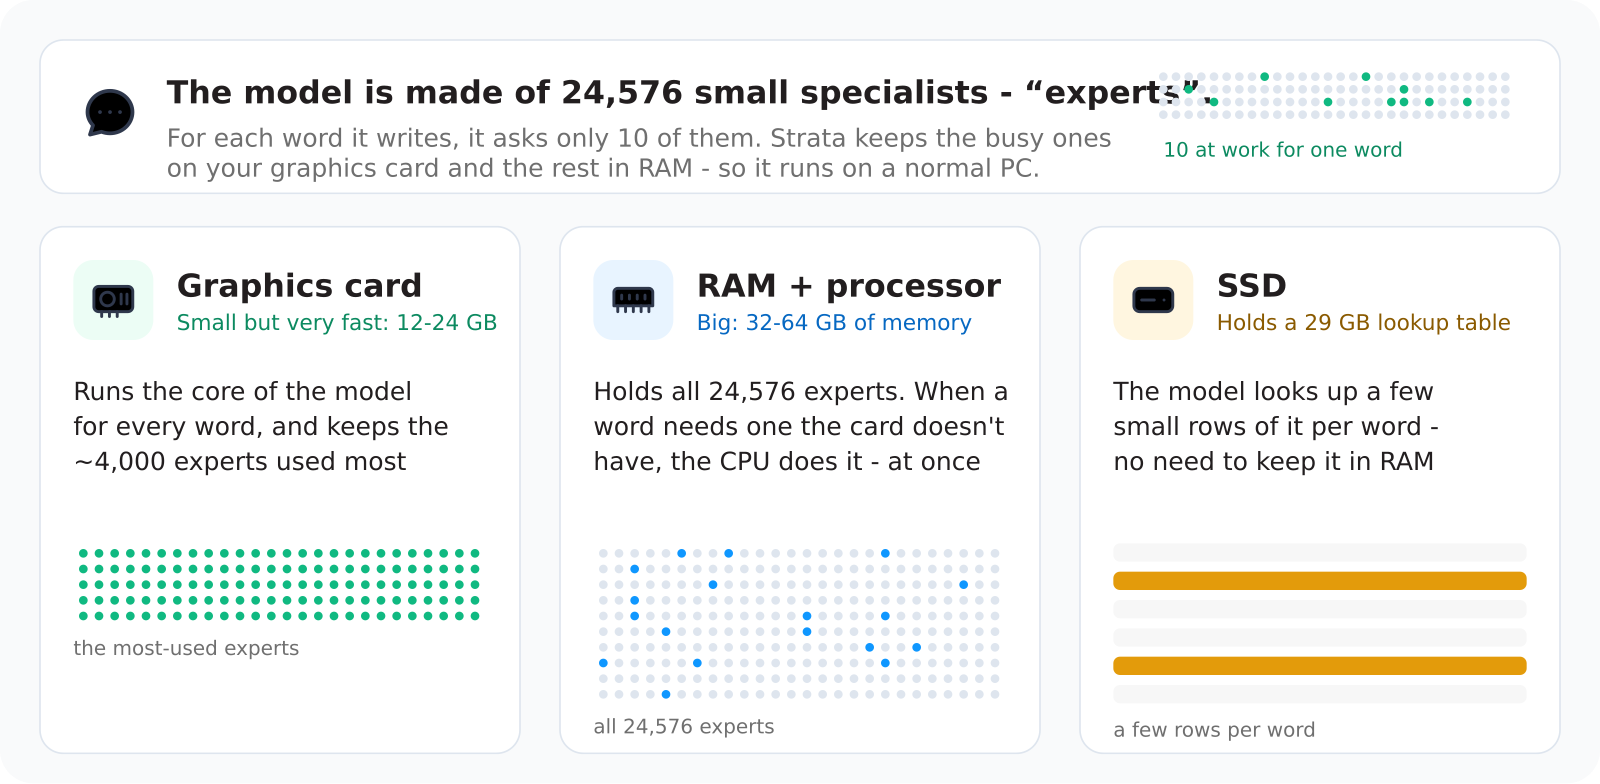 図:公式ハードウェアスケジューリング図。VRAM、システムメモリ、CPU、SSDそれぞれのデータ配置を示す。提供:Strata リポジトリ docs/media
真のボトルネックはストレージへ
しかし、データセンターの計算基盤を手元に移設するプロセスには、新たな摩擦も伴う。GPUが絶対的なボトルネックでなくなった瞬間、激しいスループットの負荷が他のハードウェア構成要素へと一気に波及するからだ。投機的な実行パイプラインを支えるため、システム内には510億パラメータ規模のn-gram埋め込みテーブルが用意されており、この膨大なデータはNVMe SSD上のルックアップテーブルとして直接マッピングされている。
その結果、ストレージの読み込み速度が新たな壁として浮上した。大規模モデルは膨大な重みデータを絶え間なく読み出さなければならない。標準のUnsloth UD-IQ4_XS量子化モデルのダウンロード容量は94GBに及ぶ。もしPCの物理メモリが80GB未満で全エキスパートを展開しきれない場合、システムはトークン生成の最中に欠落したコールドエキスパートをSSDからリアルタイムで読み出さざるを得なくなる。SSDをまたぐリアルタイムロードが発生した瞬間、滑らかだった生成速度は崖から落ちるように急落する。演算能力が足りた後、モデルの性能下限を決めるのはバス帯域幅なのだ。
また、12GBのVRAM容量はこの構成において物理的限界まで使い切られている。テキスト生成の途中でマルチモーダル画像を入力した場合、画像エンコーダーが残されたわずかなVRAMを瞬時に圧迫する。公式のトラブルシューティングガイドでは、画像を処理する際はコマンドライン引数で明示的に1GBのVRAMを予約するよう求めている。この予約を怠ると、RTX 5070環境では空きVRAMが約200MiBしか残らず、プロセス全体がフリーズしてしまう。
1250億パラメータの運用は、現行の民生用GPUアーキテクチャの物理的限界に達している。しかしStrataの成果は、巨大パラメータモデルがもはやクラウド事業者の独占物ではないことを鮮やかに示した。12GBのゲーミングPCが長大なコンテキストを相手に秒間60トークン以上を叩き出し続けるとき、大規模モデルを巡る競争のルールは根本から覆ったと言える。次なるハードウェアのブレイクスルーは、単体のGPU演算性能を競うことではなく、ローカルAIのためにマザーボードのメモリバス構造をいかに再設計できるかにかかっている。
参考リンク:
- Strata リポジトリの README とベンチマークデータ
- Qwen モデル公式リリース告知