2026 年 9 月,开发者 firelex 在一台 RTX PRO 6000 工作站上花了两个小时,完成了模型微调。他把 8 亿参数的 Qwen3.5 变成了一个专注于零样本分类的决策模型 Jeff。这个模型的权重仅有 1.7GB,完成一次判断的中位数时间为 22 毫秒。在包含 4599 道题目的公开基准测试中,它拿到了 79.1 的综合分数。这个成绩直接逼近 TypeSafe 商业托管方案 Jev 的 83.0 分。
当前应用管线里最昂贵且脆弱的一环,在于输出格式的约束。开发者为了程序稳定,必须强迫生成式模型将「判断结果」输出成特定的 JSON 格式。随后大量的下游代码再去对文本结果进行截断、解析和异常修复。Jeff 这类非自回归决策模型抛弃了文本生成逻辑。它将整个分类过程直接压缩成一次前向传播。开发者向接口输入当前处境与候选项。模型直接在网络末端输出每个选项的校准概率。这去掉了逐字生成的算力开销,也没有解析失败引发的延时灾难。
放弃生成文本,把判断压缩成22毫秒
传统的模型调用链路中,请求一次选择题答案需要等待首包延时,外加生成多个 token 的时间。Jeff 重构了这一耗时结构。在 RTX PRO 6000 显卡上处理约 200 个输入 token 的请求时,Jeff-Qwen3.5-0.8B 给出决策的中位数耗时只有 22 毫秒。把它迁移到 MacBook 的 Apple M4 Max 芯片上运行,单次调用仅需 28 毫秒。即便在纯 CPU 环境下,32 线程运算的延时也停留在 463 毫秒。作为对比,Jev 公布的 Doom 游戏端到端耗时在 114 到 212 毫秒之间。本地小模型的网络请求开销彻底清零。它直接在设备内存中完成了高频判断的闭环运算。
它能做到如此快速,工程机制在于输出接口的重写。Jeff 提供了三种高度结构化的问题类型。最多支持 26 个选项的选择题模式按字母顺序直接编码。是非题模式直接返回是否的概率值。打分模式在自定义量表上直接输出得分。多个互不相关的问题,可以在同一次 API 请求里一并处理完毕。模型直接通过 logits 输出各个候选项的概率分布与选中项的置信度。开发者拿到的是干净的浮点数与确定性字符,省去了繁琐的正则表达式清洗工作。
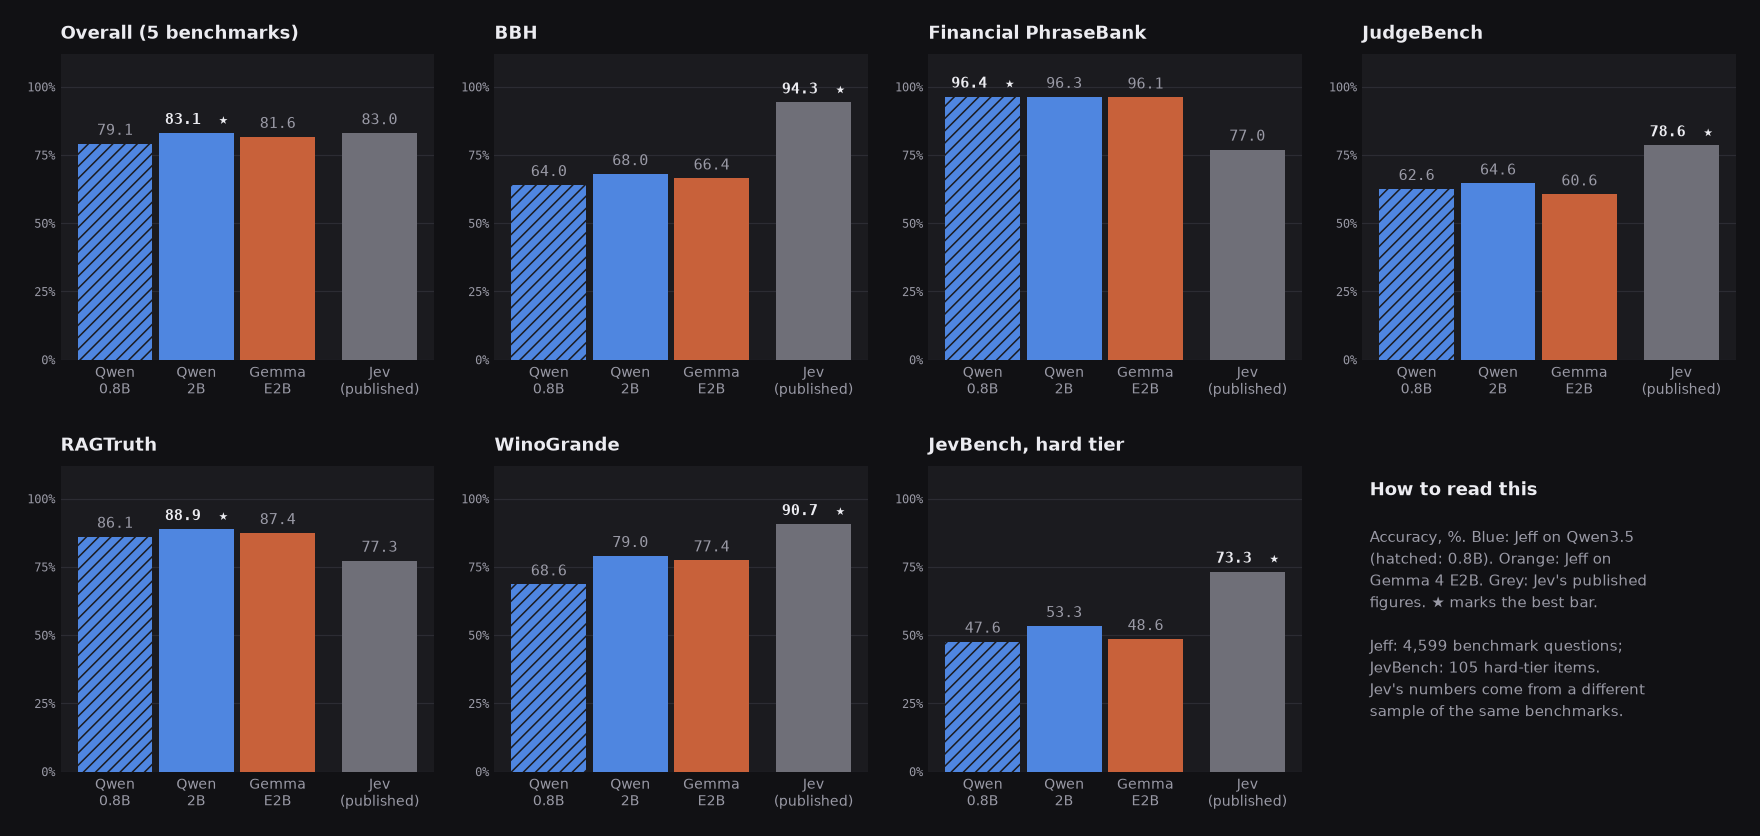 图:Jeff 三个模型与 Jev 在五个基准上的逐项准确率对比。来源:firelex/jeff 仓库
单卡全权重微调两小时跑通完整管线
Jeff 验证了端侧决策模型的极低准入门槛。全权重微调一个 0.8B 参数的版本,只需要两小时单卡算力。即便模型规模扩大到 2B 版本,也仅耗时三个半小时。整个开发流程完全摆脱了对云端 GPU 阵列的依赖。训练所用的合成数据集由 Qwen3.8-Flash-Next 在本地服务器上生成。测试过程则直接跑在日常开发用的 MacBook 上。闭源商业 API 仅被用作抽查合成数据的质量标尺。没有任何一条闭源模型的直接输出被混入训练数据。
它的训练配方精简直接。项目采用批次大小 256 进行全权重微调,仅跑完 1 个 epoch 的迭代便宣告结束。损失函数针对选项字母直接计算交叉熵。最后它再单独拟合一个温度参数,用于输出概率的校准。在语音导航场景的垂直实践中,这种方案展现出巨大的回报。仅使用 1.1 万条应用内样本进行半小时单卡微调,就能让模型的 held-out 准确率从 31.7% 跃升至 95.8%。此时 M4 Max 上的调用耗时依然稳定在 40 毫秒左右。这确认了用低成本算力快速适配私有场景的可行性。
分类任务越级对抗,纯推理基准落后30分
在 5 个公开基准的 4599 道测试题中,不同版本拉开了显著的分数梯队。Jeff-Qwen3.5-2B 取得了 83.1 的总分。微调自 Gemma 4 E2B 的版本获得 81.6 分。这与 Jev 官方公布的 83.0 分处于同一水平线。它们仅落后于 270 亿参数大模型 AutoJev 的 84.9 分。在专注分类与文本接地任务中,小模型打出了压制力。Financial PhraseBank 任务上它达到 96.4 分,远超商业托管版的 77.0 分。RAGTruth 任务中它也以 86.1 压倒对手的 77.3 分。
与分类任务的高分形成反差,Jeff 在复杂推理基准上暴露了物理极限。在要求多步逻辑推演的 BBH 任务中,它仅获得 64.0 分,而 Jev 拿到了 94.3 分。在 JudgeBench 和针对高难度推理构建的 JevBench hard 中,它的得分只有 62.6 与 47.6。这落后百亿参数大模型多达 30 分。项目作者明确指出,这种在推理密集型任务上的短板符合架构设计初衷。小参数模型天然不具备深度因果推导的记忆与状态容量。将复杂逻辑运算硬塞给轻量决策模型,必然导致性能层面的灾难。
选项格式比参数量更决定胜负概率
在没有进行任务特定微调的零样本游戏测试中,Jeff 展现了基于纯文本描述进行决策的即战力。在 Doom 游戏中,它每回合接收局势说明与合法走法描述。它场均达成 6.55 次击杀,直接与开发者手写的硬编码规则机器人打平。未微调的原始 Qwen3.5-0.8B 在同等条件下只能拿到 5.0。面对经典的 Pac-Man,它成功吃掉了 98 颗豆子中的 57 颗。在整个游玩过程中,0.8B 模型每步思考时间限制在 29 到 49 毫秒之间。
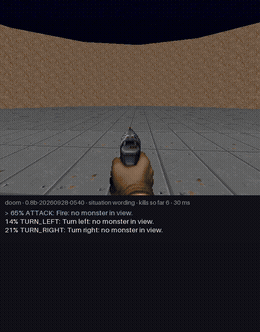 图:0.8B 模型零样本玩 Doom 的一帧,画面上方的文字是给它描述的局势与走法。来源:firelex/jeff 仓库
相比于单纯增加模型体积,选项设计对结果影响更为剧烈。在 Frogger 过马路测试中,如果把目标选项的措辞修改得与其他前进选项保持一致,单局过马路次数会直接从 15 次跃升到 23 次。同时,由于训练数据中问题最多只包含 19 个选项,模型从未学习过双字母的选项编码。排在第 27 位及之后的选项实际上永远不会被选中。服务端直接设定上限,拒绝接收超过 26 个选项的请求,从源头上规避了越界错误。使用短数字加描述文字作为选项键名,成为了避免产生幻觉的重要工程技巧。
决策权下放改变应用层管线分工
2026 年 9 月的 Hacker News 上已经聚集了一整波同类项目。除了托管 API 服务 Jev,还涌现了公开权重的 Laya、Ollaya、Reflex 和 TinyJev 等非自回归项目。社区争论的分歧在于:让通用大语言模型自己承担所有的判断逻辑更省事,还是把判断任务剥离给一个便宜、可复现、可微调的小模型更划算。
Jeff 给出了一种极具竞争力的低成本解法。在实际业务中,系统级推理必须与模型级判断解耦。开发者应该在传统的代码逻辑中完成前瞻预测与状态管理,仅将穷举后的「二选一或多选一」交由端侧模型执行。向模型提问「两回合后会有车来吗」,其准确率与掷硬币无异,因为它根本不做预测。把生成文本的繁重任务剥离出去,让几百兆权重的模型专注在一台普通的物理机上高频处理布尔值与分类概率,这是一条被工程界验证可行的捷径。
参考链接:
- firelex/jeff
- Hacker News 讨论