2026 年 8 月 LibreOffice 26.8 发布。官方公告下出现了一条略带调侃的用户评论:「所以,不装 AI 现在成了一个新功能?」
The Document Foundation(文档基金会)借着这个问题,在 9 月 3 日给出了一份包含六条硬性指标的 AI 准入清单。这套办公软件装在中小学校、医院、公共机构和律所里。它有几千万用户。这份清单等于给 AI 集成换了一套记分标准。问题从「有没有 AI」变成了「推理在哪跑、数据去哪、格式归谁」。这套标准对靠订阅收费的商业办公套件几乎无法成立。因为功能和商业模式本来就是在互相加强。
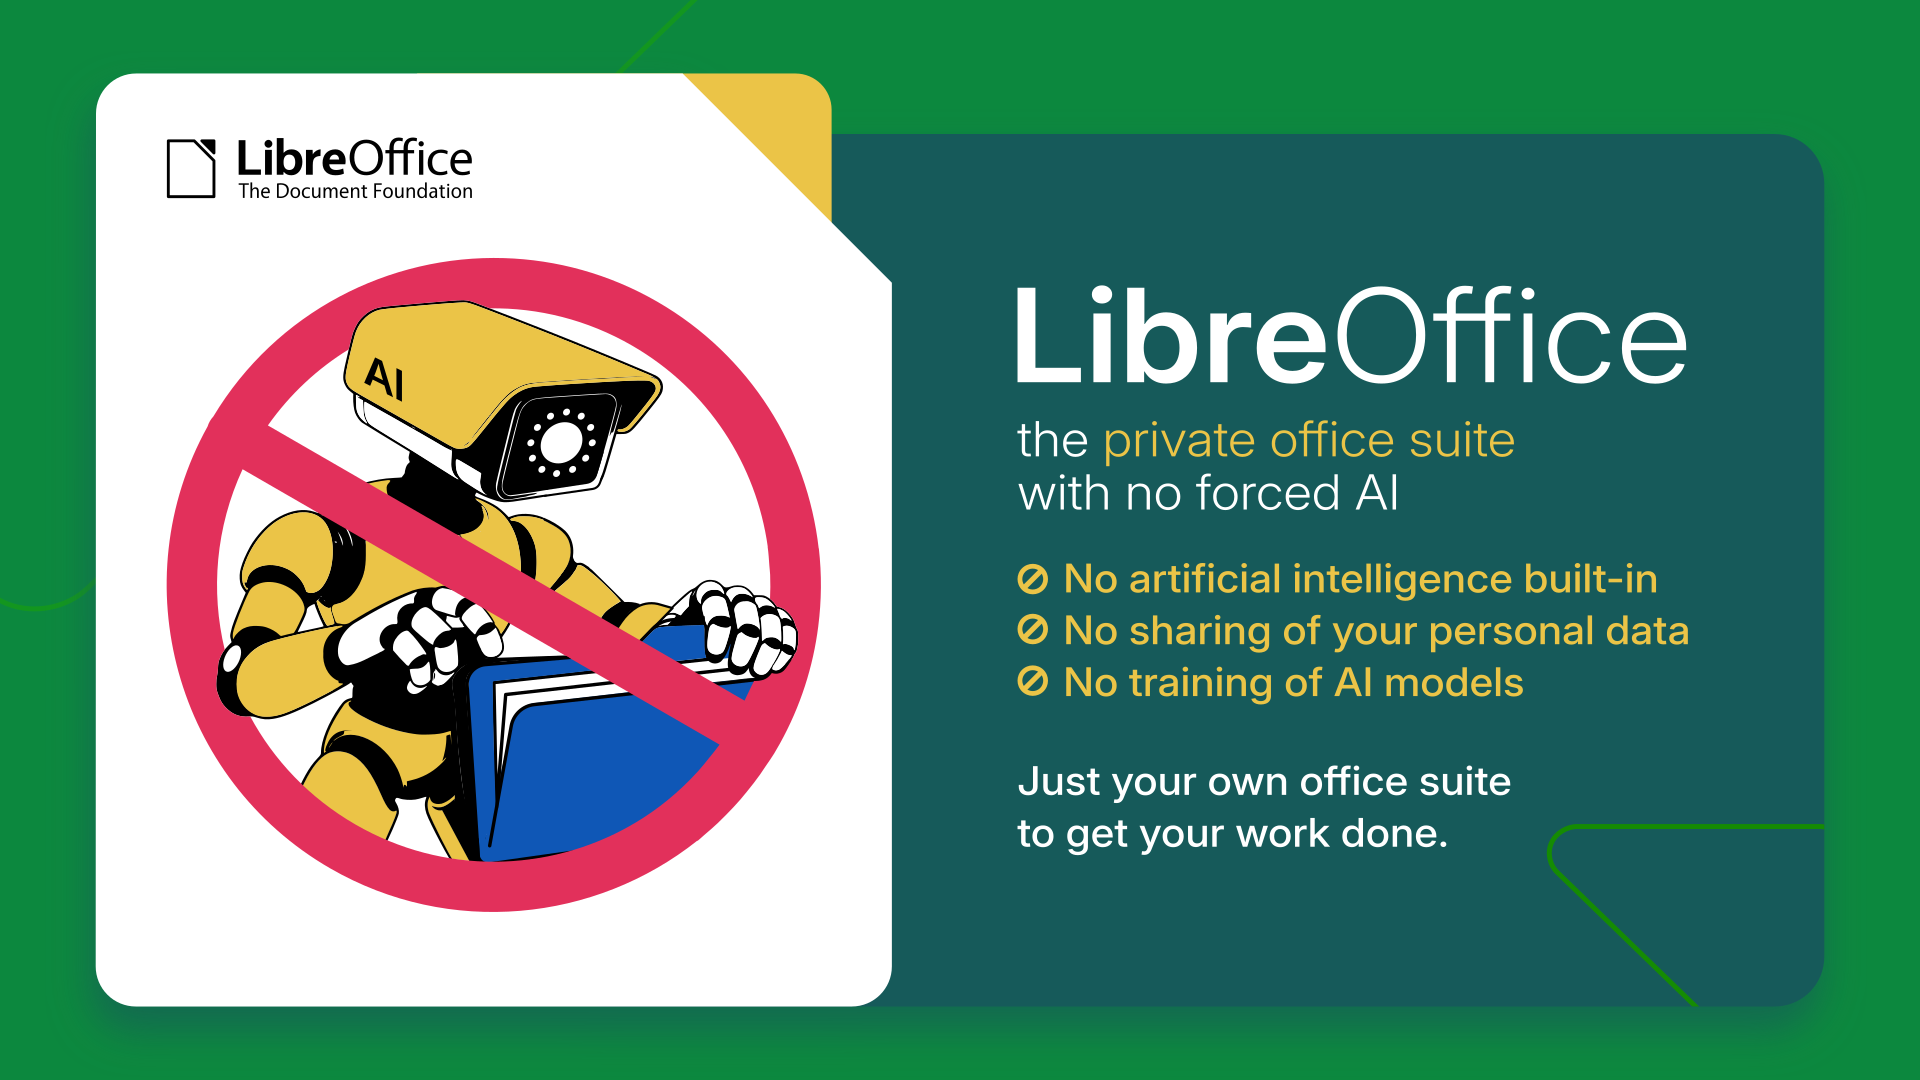 图:LibreOffice 团队在博文中强调可选性。来源:The Document Foundation 官方博客
订阅制接不住六条硬标准
LibreOffice 并没有一概拒绝人工智能。官方将这六条条件定性为对当前技术状态的评估。只有某项功能满足所有条件,它才会被加入默认配置。
第一条是执行位置必须由用户控制。用户必须能自主选择推理发生在本机、自己直接控制的基础设施,或是独立选定的第三方服务。默认设置悄悄把数据转发给单一供应商。在官方看来这根本不算选择。
第二条是未经授权文档内容不得离开本机。文档在很多场景下是受法律严格保护的材料。医院病历、法院案卷、企业投标文件和学生数据外传都会引发合规灾难。数据传输必须是用户明确决定的结果。它不能是应用程序在后台自行发生的数据挪用行为。
第三条是零遥测要求。LibreOffice 坚持不在后台收集用户数据。这一底线要求同样约束着未来的 AI 功能。所有的交互记录和使用频次都不能被暗中打包传输。
第四条是不依赖单一供应商。只能跟某一家公司的特定 API 打通的集成被视为一种锁定机制。发布说明里用什么词汇去包装它都不重要。接口应该保持开放。它可以由多个后端灵活实现,确保用户能够随时切换底层模型。
格式控制权决定文档归属
第五条是对 ODF 格式的不让步。AI 生成的内容必须和文档里的任何其他文字一样。它们必须使用标准的 ODF 格式,并完整保留结构、样式与语义。如果 AI 助手只能用专有格式产出内容,它就会顺着文档的生命周期锁定用户数据。
第六条是用户享有可选项。AI 模块必须能被安装。它也必须能被卸载。对于不想使用它的人,或者按公司政策被禁止使用的网络环境,它必须在软件界面上隐藏。这为需要批量部署成千上万台工作站的系统管理员留出了基础控制权。
对照这份事无巨细的清单,官方给出的现状判断非常直接。目前没有任何一个现成的 AI 集成能满足全部六个要求。它们无法默认启用,也无法在发布版本的生命周期内得到稳定支持。这套技术标准阻断了商业 AI 助手渗透开源办公底座的路径。
 图:LibreOffice 强调文档应该由用户掌控。来源:The Document Foundation 官方博客
第三方扩展接管本地需求
LibreOffice 的用户没有被隔离在大模型生态之外。官方在系统架构上给想用的人留了一道门。用户可以通过第三方扩展接入 AI 能力。
目前多数跑通的扩展接的是本地运行的开源模型。他们通过 Ollama、LM Studio 或是兼容 OpenAI API 的本地端点进行调用。在这个链路里,所有的推理都在本地硬件上完成。文档数据从头到尾没有离开本机计算环境。官方在公告中也发出了明确提醒。这些扩展成熟度各异,它们由各自的作者而非基金会维护。
用户和系统管理员在引入这些扩展时,应该像评估任何第三方组件那样去严格评估。管理员需要查验它是否配置了隐蔽的云端端点,弄清供应商拿到这些数据后到底会做些什么。本地运行的模型证明了实际需求的存在。它也证明了不需要把文档打包上传给科技巨头,同样能跑通文字处理流程。
商业模式决定数据去向
这份准入清单背后的深层驱动力是商业模式的差异。
对于按月卖订阅的商业软件公司,把 AI 助手塞进主界面是营收逻辑的核心。AI 助手的存在支撑起了订阅费用的涨价空间。它也让「把全部文档留在自家云端基础设施里」显得顺理成章。软件功能和商业模式互相加强。强制集成大模型从一个可选项,变成了营收层面的必选项。
文档基金会作为一个非营利组织,不用背负这些增长包袱。LibreOffice 没有需要保护的订阅分层。它没有追加销售的指标压力,也没有可供变现的用户数据。这种结构上的差异让它免受季度财务业绩的驱使。官方在文章中坦言,这不代表基金会比别人更聪明。但团队确实有足够的时间去判断某项技术是否真的对用户有用。
社区讨论回到本地可用性
在技术社区 Lobsters 上,关于这六条准入门槛的讨论呈现出务实的底色。讨论的第一战场发生在一处细节。有人要求不要给这个帖子打上 vibecoding 标签。
这个要求随即被社区管理员驳回。因为该标签的定义本就是「使用 AI 编码工具,且不再重复堆叠 ai 标签」。当话题从标签争议回到实质判断时,社区意见表现出高度一致。对于大部分长期关注隐私与数字主权的技术人员而言,本地没有出现一个真正跑通的方案之前,大规模集成的讨论缺乏成立前提。
这种共识反映了开发者对云端大模型渗透基础工具的普遍警惕。当一个工具试图把用户的核心知识资产批量导向单一服务商时,阻力必然首先来自那些最清楚数据传输链路的人。
硬件跑得动时再发牌
这套「数字主权」的表述与文档基金会近期的公开沟通是一脉相承的。就在 9 月 28 日,LibreOffice 刚刚发布了庆祝独立十六周年的文章。独立性让它能把准入门槛定得很严苛。但这份清单并不等于永远把 AI 拒之门外。
技术演进的趋势正朝着有利于本地运行的方向推进。本地推理在标准硬件上变得越来越可控。开放权重的模型进步速度超出了多数人的预期。官方留下了明确的口子。如果未来出现了能满足全部六条条件的方案,他们会仔细进行评估。
在符合标准的本地化方案成熟之前,LibreOffice 默认安装包里依然不会有任何形式的 AI。把判断标准从情绪化的站队变成可验证的工程清单。这是对技术演进最务实的交代。
参考链接:
- The Document Foundation Blog
- Lobsters 社区讨论