差 0.7 分,价格只要一半
65.7% 对 66.4%。Kimi 把新发布的 K3.1 Pro 放上 Terminal-Bench 4.0,与 Claude Opus 5.5 的差距只剩 0.7 个百分点,GPT-6 Astra 是 58.2%。官方给 K3.1 Pro 的定位是「目前最强的 3T 级开源权重模型」——3 万亿参数量级、100 万 token 上下文、跨数百个领域做联合强化学习,是 K3.1 系列的第一款模型,权重定在 2026 年 11 月 4 日放出。
Terminal-Bench 考的是终端里的长程任务:装环境、改配置、跑通工具链,几十步操作错一步就全盘挂掉。这类任务最能拉开 agent 模型的差距,也最贴近开发者每天的真实工作。100 万 token 上下文对长会话和大代码库是刚需配置,配上这份成绩才有意义——上下文装得下,任务还得跑得完。
0.7 个百分点落在评测噪声范围内。官方给出的评测设置是推理档位 max、temperature 1.0、top-p 0.95,同档位下比出来的数字。开源权重模型在终端长程任务上,已经贴住闭源旗舰。
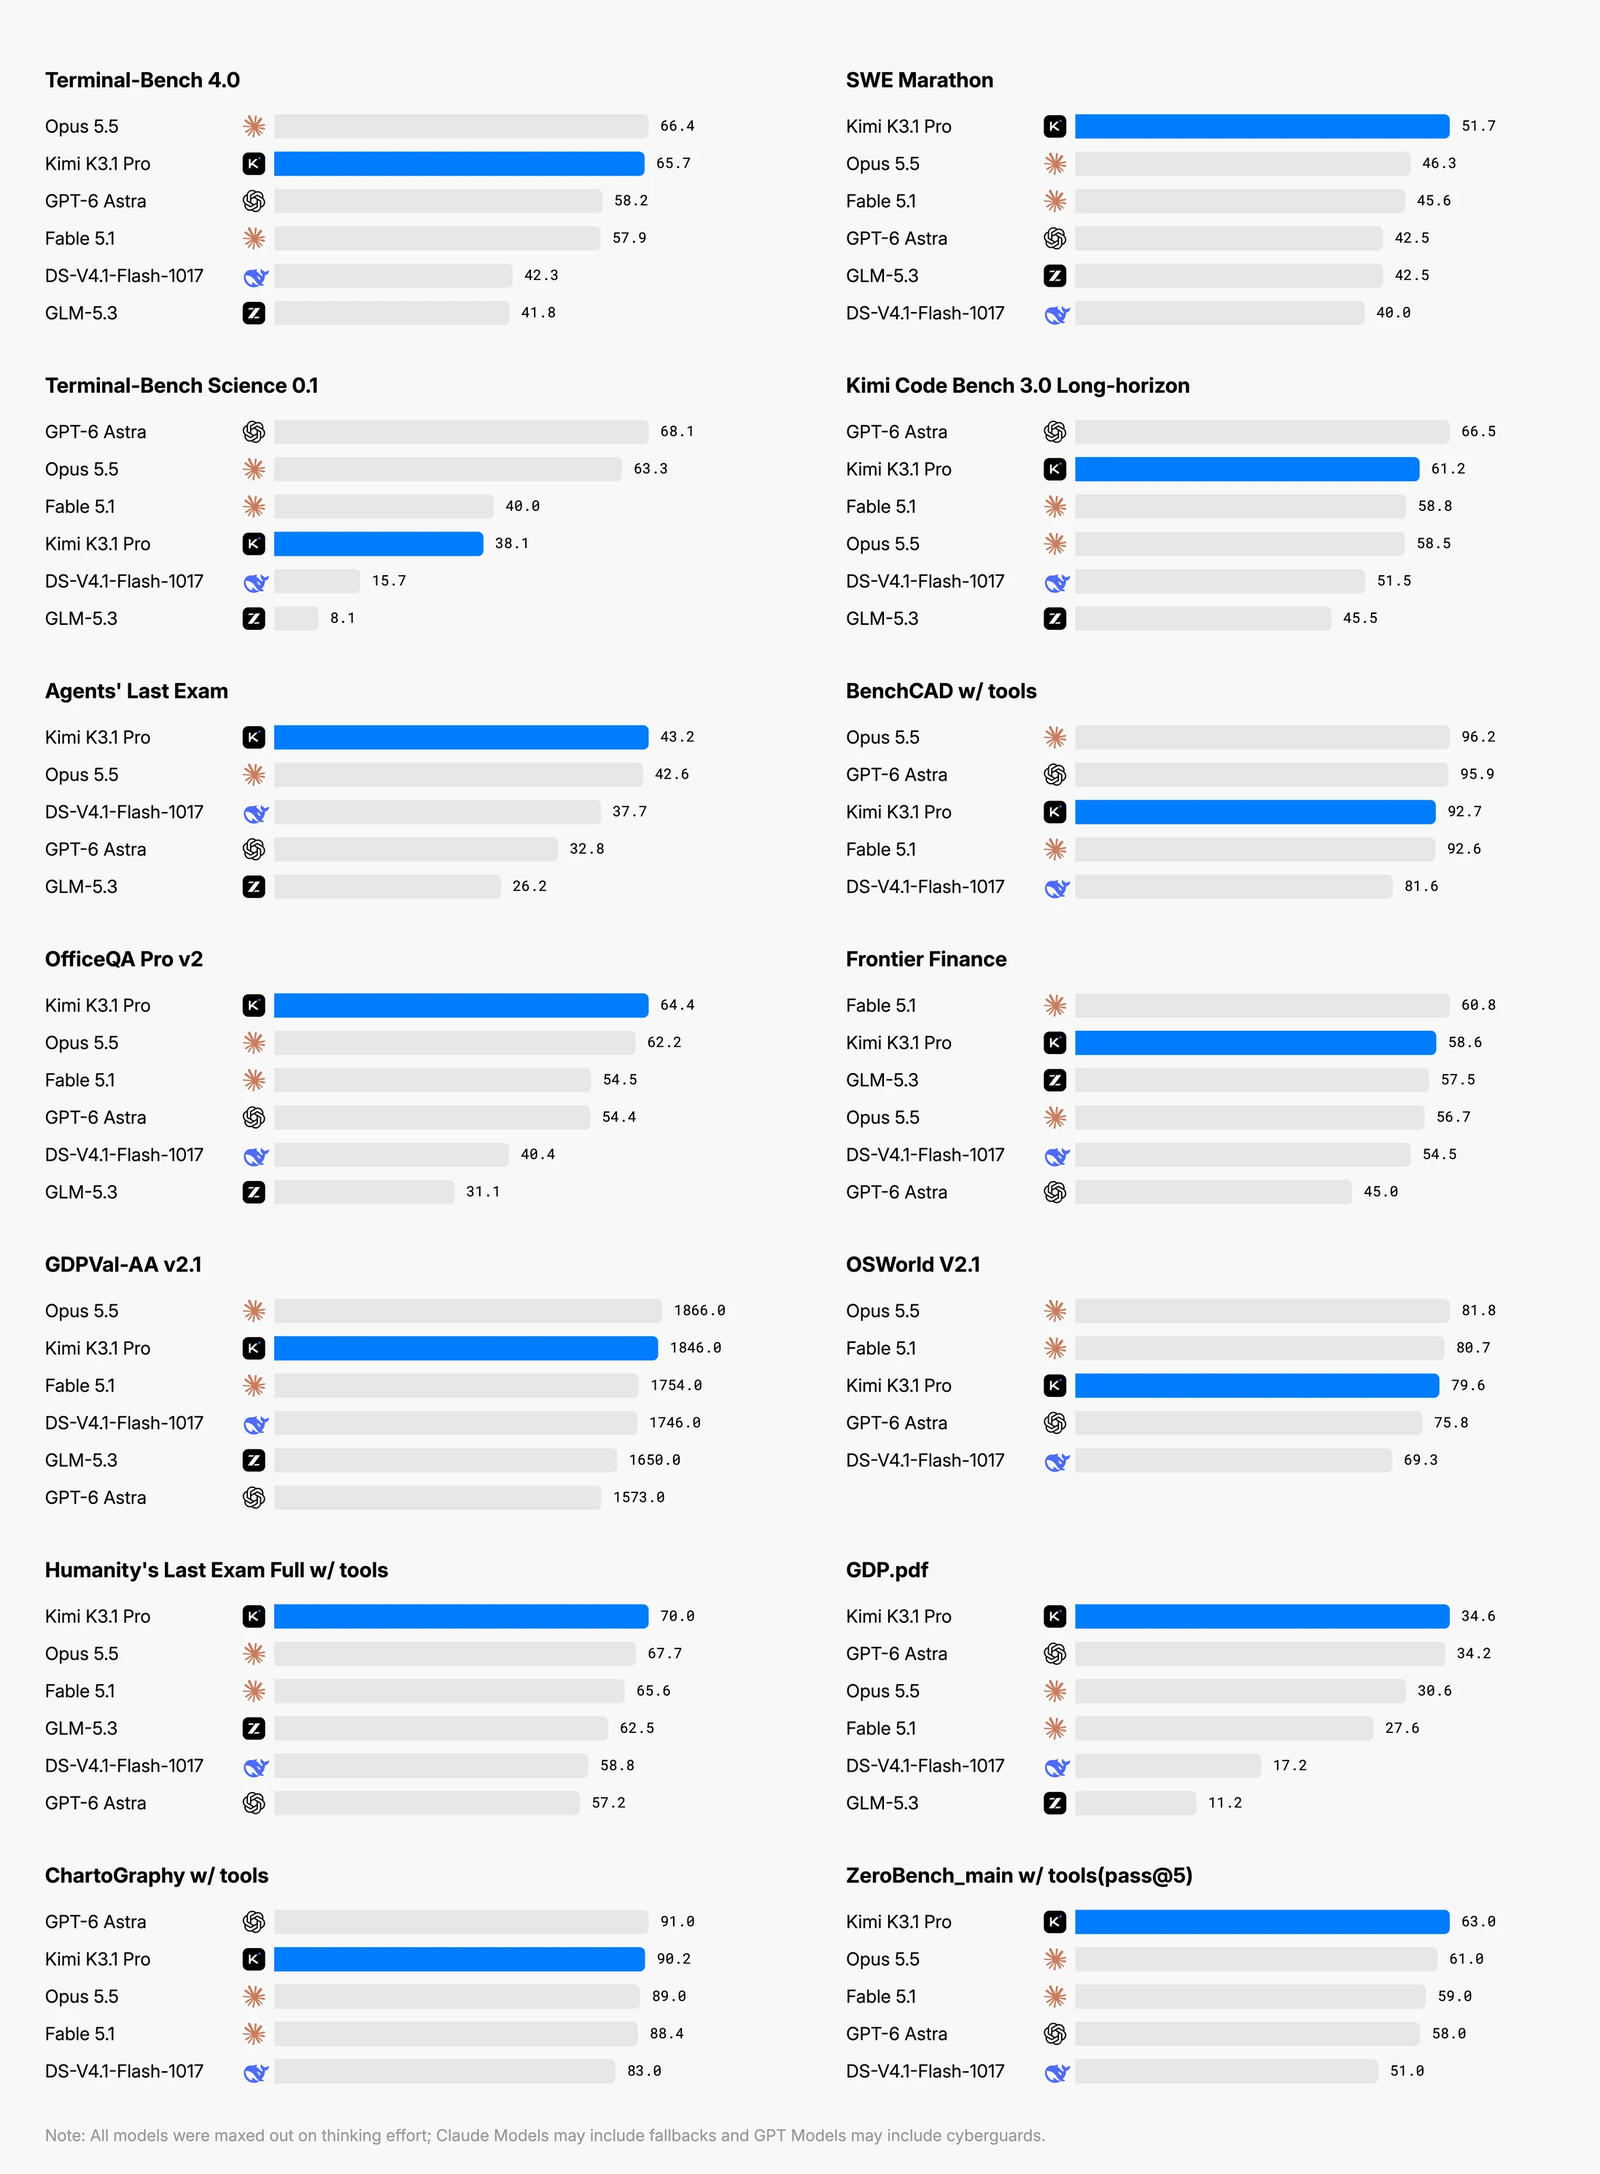
图:官方发布页的能力对比总览。看 Terminal-Bench 4.0 一栏:65.7 对 66.4,差距被压进 1 分以内。来源:Kimi 官方博客
追平是局部的。带工具的 BenchCAD 里,K3.1 Pro 92.7,Opus 5.5 是 96.2,GPT-6 Astra 是 95.9——工程任务坐进了第一梯队,榜首还差 3 分以上。OfficeQA Pro v2 拿到 64.4,官方称达到该榜最优(SOTA),商业运营类任务较前代提升约 4.2 倍——文档密集型工作的改进,直接对应办公自动化场景的可用性。幻觉率在 Kimi Hallu Bench Hard 上从 23.4% 降到 8.3%,降了约三分之二;对拿模型跑自动化流程的团队,幻觉率比跑分更实际,它决定输出能不能直接用。
官方还放了一个长程演示:human-atlas 场景里编排 296 个骨骼件、402 个肌肉件、共 167 个任务,把人走路的生成压到 11.2 秒。跑 agent 的团队多半见过任务链中途散架的样子——第 100 步忘了第 10 步的约束,前面 99 步白跑。167 个任务串成一条链没有散架,才是这个演示的看点所在。
同样 93 分,账单差 2.4 倍
分数追近之外,社区更关心价格。有开发者用 Pac-Man 基准把 K3.1 Pro 和 Claude Sonnet 5.5 放在一起跑:同为 93 分,K3.1 Pro 用时 11 分钟、花费 0.68 美元,Sonnet 5.5 用时 14 分钟、花费 1.61 美元。分数持平,账单差 2.4 倍,耗时还少 3 分钟。对按 token 计费跑批量 agent 任务的团队,这个价差乘上任务量,就是换模型的全部理由。
单次任务的成本有波动,一个样本撑不起统计,但方向清楚:分数持平的前提下,时间和费用两条轴同时占优,同样的预算能跑的任务量翻到 2.4 倍。
Highspeed 版把选择拆得更细:官方标称速度 2-3 倍。对高频交互的使用者,等待模型的每一秒都是净损失,速度优先;对夜里跑批的流水线,速度换不来钱,单价才换成钱。同一系列拆出两个速度档,成本结构已经进入产品参数,分别服务两类场景。
被删掉的 9.5 分,才是发布说明的重点
这次发布里分量最重的段落,在能力榜之外。官方明确写出:攻击性网络能力(offensive cyber)的数据已从训练语料与强化学习环节移除,而且移除的是已经通过自家风险自查的那部分——自查过关,仍然选择不要,「不做」二字进了发布说明。
代价有公开数据可查。偏攻击向的 xdev-bench-hard 上,官方自己的对照版本(不做风险削减)能拿到 90.5%,DeepSeek 是 85.7%,K3.1 Pro 收在 81.0%,GLM-5.3 是 57.1%,上一代 K3 只有 33.3%。**81.0 对 90.5,9.5 个百分点就是这次自我限制的标价:模型本来能跑得更高,选择压低,并且把压低的幅度公开。**各家在这张表上分布散得很开,能力分数里掺着各自的风险取舍,单看名次看不出全部。对照版本的 90.5 分还回答了另一件事:90 分上下的攻击能力造得出来,发布版是主动收着的。
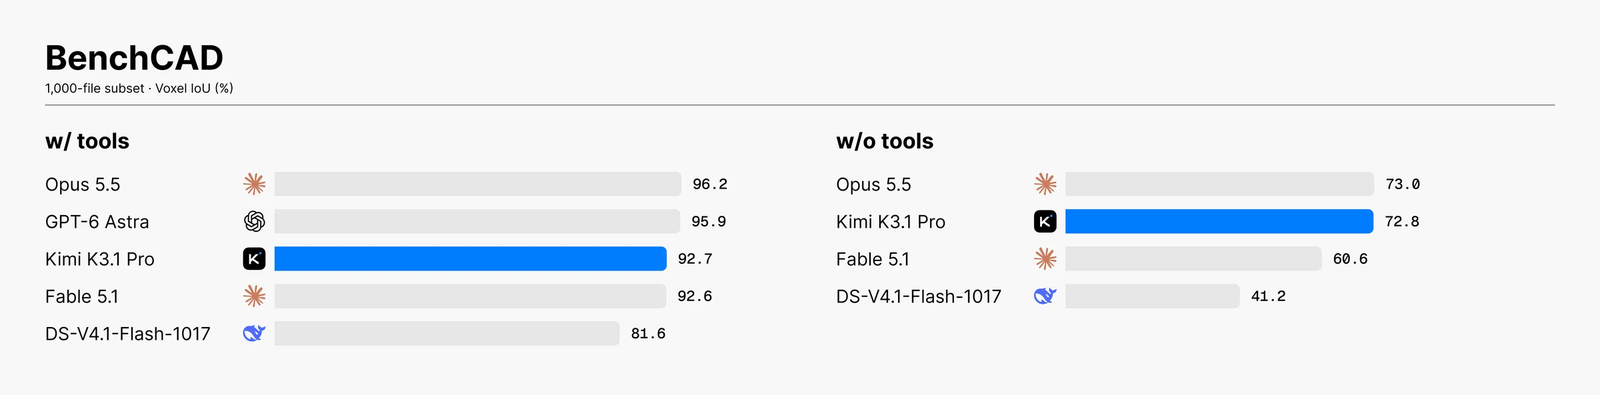
图:官方基准测试明细。注意 xdev-bench-hard 一行:正式版 81.0,未做风险削减的对照版本 90.5。来源:Kimi 官方博客
闭源厂商挡一类能力,可以在部署层加过滤、加策略;权重开源之后,下载者拿到的就是模型本身,放出去了也收不回来。想在开源路线上管住一类能力,闸门只能装在训练数据那一端——发布后补的使用条款,管不住权重文件本身。
企业默认关闭,订阅额度先告急
可用性铺得很全:Kimi Code 里 /model 直接切换,API 模型名 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed,Kimi Work 桌面端 v3.1.0 起可用。API 支持零数据留存(Zero Data Retention, ZDR),服务商不留存请求数据,走私有数据的企业会先看这一条。
企业线 Kimi Enterprise 对企业客户默认关闭这个模型。训练数据端的移除管模型本身,产品端的默认关闭管落地场景,两端是同一套思路。默认关闭比发布说明里任何一句措辞都直白:能力可以写进宣传页,攻击面风险要靠默认配置和合同条款来管。
订阅侧的反应没这么客气。99 美元/月的套餐被大量吐槽:有用户一个会话跑了 47 分钟,5 小时额度就见了底。按这个消耗速度,重度用户的实际单价远高于账面价格,配额设计在为算力成本让路。
讨论区另一侧的声音集中在模型性格:有人说 K3.1 比美国模型直率、爱争论,会直接回一句「我们已经讨论过三次了,换个问法答案不会变」。对一个要反复迭代的编程 agent,不顺着用户改口,省掉的是来回确认的轮次。同一批讨论里,也有人开口就问「主要蒸馏来源是什么」。同一个模型,吐槽的人在算钱,喜欢它的人在记性格,怀疑的人在问出处——三件事都是这次发布的真实反馈。
下一场竞争,比谁敢公开说「不做」
把发布内容摊开看:0.7 分的差距、一半以上的价格空间、训练数据里被主动移除的一类能力。前两件是开源模型竞争的常规项目;第三件没人要求,是自己加的自选动作,这才让它成为这次发布真正的新信息。
过去开源阵营的叙事只有追分数:闭源上什么榜,开源跟什么榜。K3.1 Pro 把另一件事摆上台面——安全在训练数据阶段就做减法,并给出减法值多少分的对照数据。能力差距压进 1 个百分点之后,区分开源与闭源的下一个指标,是谁敢把「不做什么」写成带数据的承诺。
这种写法自带开源特有的属性:可验证。11 月 4 日权重放出之后,攻击能力到底留下多少,任何人都能拿基准自己测一遍。下载者拿到的会是一个 65.7 分、没有攻击性网络能力的模型——分数会被下一次发布盖过去,这份提前写明的「不做」,才是 K3.1 Pro 真正留下来的东西。
参考链接:
- Kimi 官方发布博客
- HN 讨论
- Kimi Code 模型文档