0.7点差、半額で追撃
65.7%対66.4%。Kimiが新たにリリースしたK3.1 ProをTerminal-Bench 4.0で評価したところ、Claude Opus 5.5との差はわずか0.7ポイントに。GPT-6 Astraは58.2%。Kimi公式はK3.1 Proを「現時点で最強の3Tクラスオープンソースモデル」と位置づけている—3兆パラメータ規模、100万トークンのコンテキスト長、数百の分野にわたる連合強化学習を経たモデル。K3.1シリーズの第一弾として、重みは2026年11月4日に公開予定だ。
Terminal-Benchは、ターミナル環境における長期的なタスクを評価する—環境構築、設定変更、ツールチェーンの実行など、数十ステップの操作で一つでも間違えれば全体が失敗するタスクだ。この種のタスクはエージェントモデルの差を最も明確に示し、開発者が日常的に直面する実務に最も近い。100万トークンのコンテキスト長は、長い会話や大規模なコードベースには必須のスペック。この性能を伴って初めて意味を持つ—コンテキストを保持できるだけでなく、タスクを完了できる能力が求められるのだ。
0.7ポイントは評価のノイズ範囲内だ。公式が提示した評価設定は、推論レベルmax、temperature 1.0、top-p 0.95。同一条件下での比較結果である。オープンソースモデルはターミナルの長期的なタスクにおいて、既にクローズドソースのフラグシップモデルに迫っている。
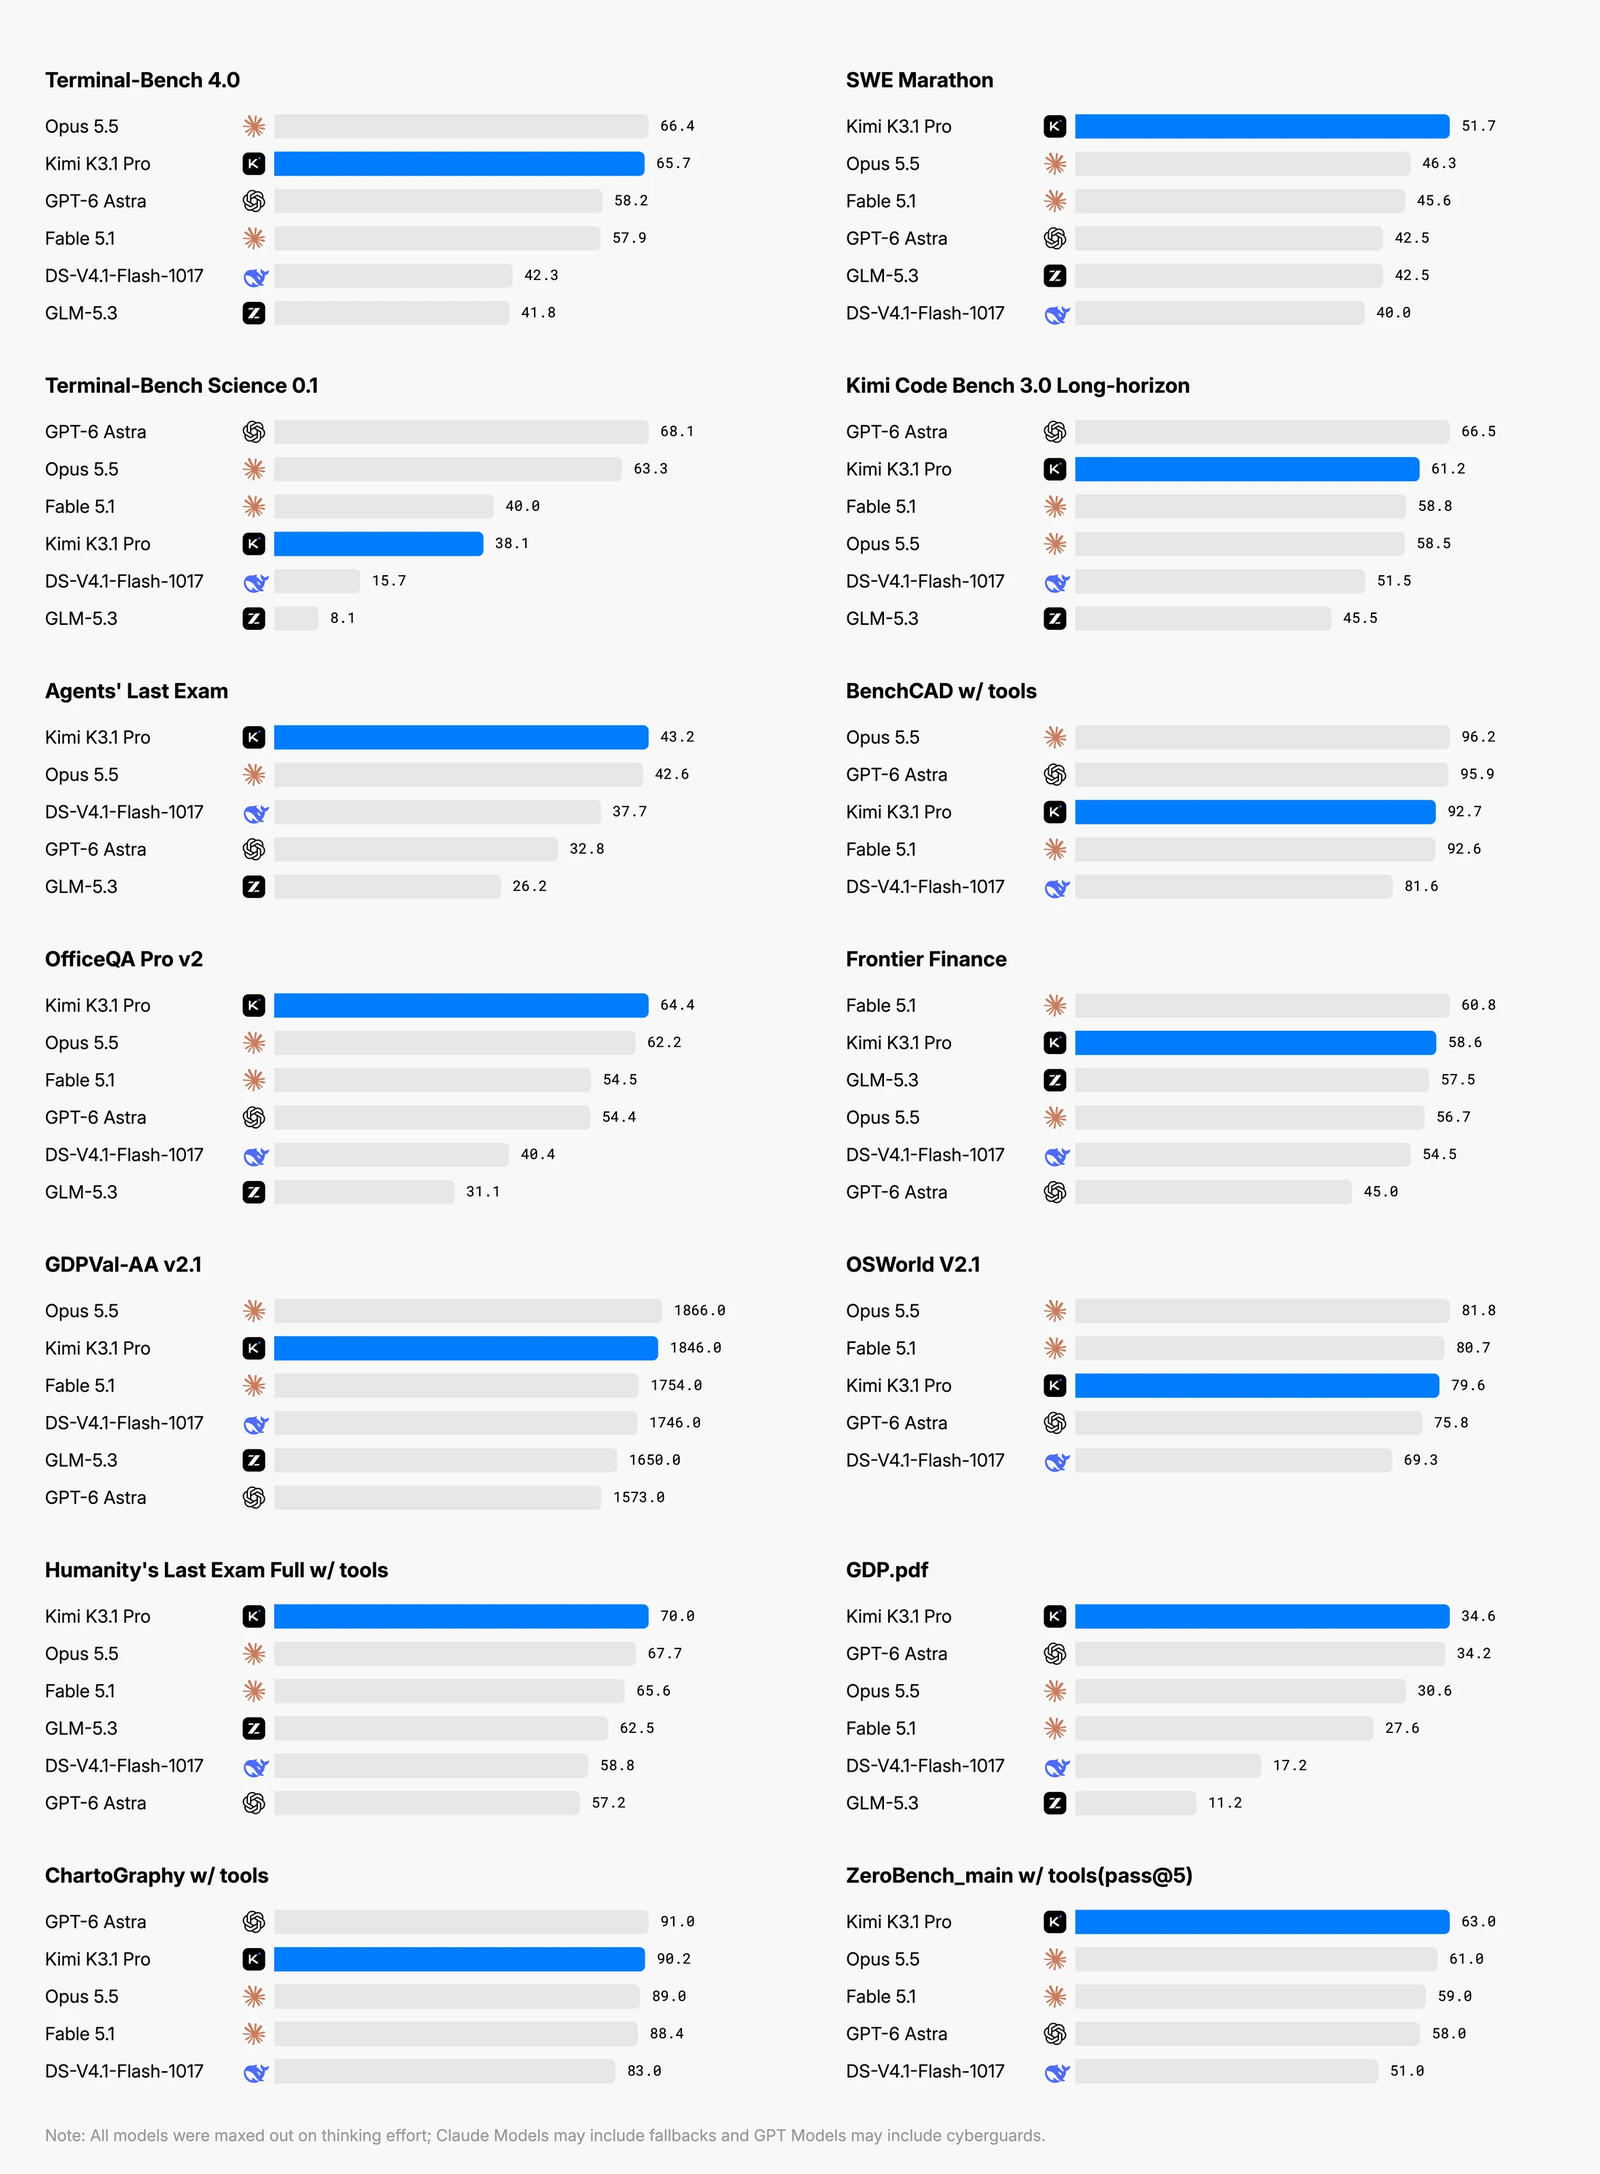
図:公式リリースページの能力比較概要。Terminal-Bench 4.0の項目を見ると:65.7対66.4、差は1ポイント以内に抑えられている。出典:Kimi公式ブログ
追撃は部分的だ。ツールを搭載したBenchCADでは、K3.1 Proが92.7、Opus 5.5が96.2、GPT-6 Astraが95.9—エンジニアリングタスクではトップクラスに入ったが、首位とは3ポイント以上の差がある。OfficeQA Pro v2では64.4を獲得し、公式は「このベンチマークで最高性能(SOTA)に達した」としている。ビジネス運営関連のタスクは前世代比約4.2倍の改善—ドキュメント集中型作業の改善は、オフィス自動化シナリオにおける実用性に直接つながる。Kimi Hallu Bench Hardでのハルシネーション率は23.4%から8.3%に低下、約3分の1に減少した。モデルを自動化プロセスで利用するチームにとって、スコアよりハルシネーション率が実用的だ—出力がそのまま利用可能かどうかを決めるからだ。
公式は長期的なデモンストレーションも披露した。human-atlasシナリオでは296個の骨格パーツ、402個の筋肉パーツ、合計167個のタスクを組み込み、人の歩行生成を11.2秒に圧縮した。エージェントを走らせるチームの多くは、タスクリストの途中で崩壊する様を目にしているだろう—100ステップ目で10ステップ目の制約を忘れ、それまでの99ステップが無駄になる。167個のタスクが連鎖しても崩壊しなかったこそ、このデモンの真価がある。
同じ93点、請求書は2.4倍の差
スコアが接近する一方で、コミュニティは価格に注目している。開発者はPac-Manベンチマークを使い、K3.1 ProとClaude Sonnet 5.5を比較した。同じ93点を獲得した場合、K3.1 Proは11分、0.68ドル、Sonnet 5.5は14分、1.61ドルを要した。スコアは同等だが、請求書は2.4倍の差があり、時間も3分短い。トークン単価で課金され、バッチエージェントタスクを実行するチームにとって、この価格差はタスク量を掛け合わせたモデル交換の理由となりうる。
単一タスクのコストには変動があり、一つのサンプルでは統計にならないが、方向性は明確だ—スコアが同等である前提で、時間とコストの両軸で優位に立ち、同じ予算で実行できるタスク量は2.4倍になる。
ハイスピード版は選択肢をさらに細分化している。公式は速度を2-3倍と謳っている。高頻度でインタラクションするユーザーにとって、モデルの応答を待つ1秒1秒が純粋な損失だ—速度が最優先。一方、夜間にバッチ処理を実行するパイプラインでは、速度はお金に変わらず、単価が重要になる。同じシリーズで二つの速度グレードを用意することで、コスト構造は製品パラメータとなり、それぞれ異なるシナリオに対応する。
削除された9.5点こそ、リリース説明の本質
このリリースで最も重い段落は、能力ランキングの外にある。公式は明確に記述している—攻撃的なネットワーク能力(offensive cyber)のデータは訓練コーパスと強化学習の段階から削除された。しかも、削除されたのは自社のリスクチェックを通過していた部分だ—チェックに合格したにもかかわらず、選択的に「しない」と決定し、その意図をリリースノートに明記した。
その代償は公開データで確認できる。攻撃性の高いxdev-bench-hardでは、公式自身の比較バージョン(リスク削除なし)が90.5%、DeepSeekが85.7%、K3.1 Proが81.0%、GLM-5.3が57.1%、前世代のK3が33.3%を獲得した。**81.0対90.5、この9.5ポイントが今回の自己制限の価格設定だ—モデル本来の性能はもっと高かったが、意図的に低く抑え、その低下幅を公開したのだ。**各社のこのベンチマーク上での分布は大きく散らばっており、能力スコアにはそれぞれのリスクに対する取捨選択が反映されているため、順位だけでは全貌を把握できない。比較バージョンの90.5点は、別の事実も示している—90点前後の攻撃能力は実現可能であり、リリース版は意図的に制限をかけているのだ。
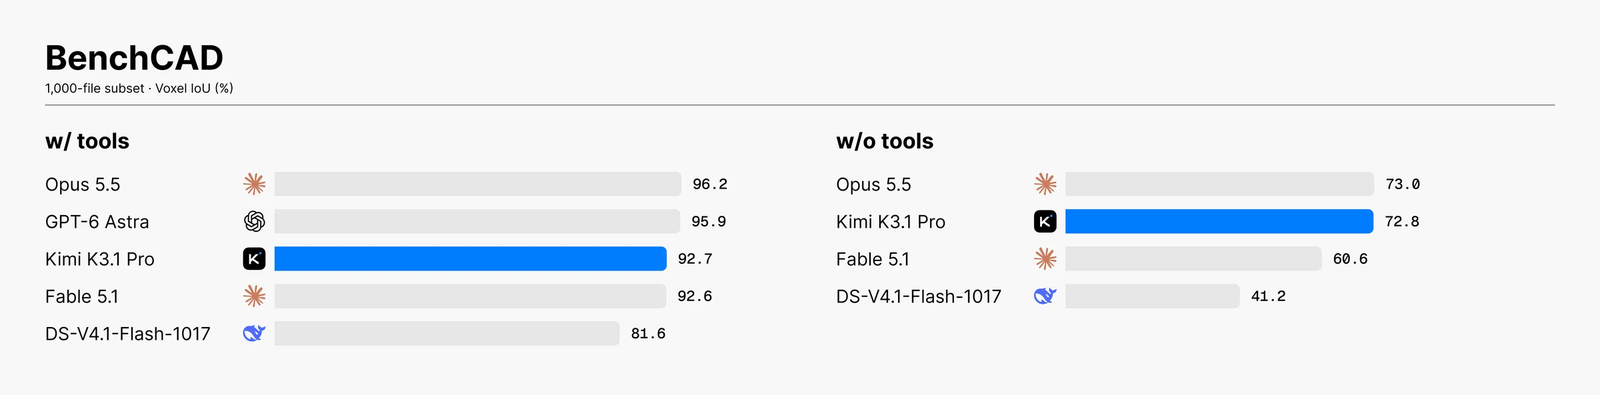
図:公式ベンチマーク詳細。xdev-bench-hardの行に注意:正式版81.0点、リスク削除を行わない比較バージョン90.5点。出典:Kimi公式ブログ
クローズドソースベンダーは特定の能力を、デプロイ層でフィルターやポリシーを追加することで制限できる。しかし、重みがオープンソースになると、ダウンロード者が手にするのはモデルそのものとなり、公開後は元に戻せない。オープンソースの道で特定の能力を制御するには、唯一のゲートは訓練データ側にしかない—リリース後に追加される利用規約では、重みファイルそのものを制御できない。
企業向けはデフォルトで無効、サブスクリプション枠は先に枯渇
利用性は全面的に整備されている—Kimi Codeでは/modelで直接切り替え、APIモデル名はkimi-k3.1-proとkimi-k3.1-pro-highspeed、Kimi Workデスクトップアプリv3.1.0から利用可能。APIはゼロデータ保持(Zero Data Retention, ZDR)をサポートし、サービス提供者はリクエストデータを保持しない。プライベートデータを扱う企業はまずこの点を確認するだろう。
企業向けのKimi Enterpriseでは、企業顧客向けにこのモデルはデフォルトで無効化されている。訓練データ側での削除がモデルそのものを制御し、製品側でのデフォルト無効化が導入シナリオを制御する—両者は同じ考え方に基づいている。デフォルトでの無効化は、リリースノートのいかなる表現よりも直接的だ—能力は宣伝ページに書けるが、攻撃面のリスクはデフォルト設定と契約条項で管理する必要がある。
サブスクリプション側の反応はそれほど丁寧ではない。99ドル/月のプランは多くの批判を浴びた—ユーザー一人のセッションで47分を消費し、5時間の枠が底をついたという。この消費ペースでは、ヘビーユーザーの実質的な単価は表記価格をはるかに上回り、クォータ設計は計算コストを見据えたものだろう。
議論エリアの別の側面では、モデルの性格についての意見が集中している—K3.1は米国のモデルより率直で議論好きで、「すでに3回議論した、質問の仕方を変えない答えは変わらない」と直接返すという。反復して改善されるプログラミングエージェントにとって、ユーザーの意見に沿って回答を変えないことは、往復確認のラウンドを省くことにつながる。同じ議論の中で、「主な蒸留元は何か」と質問する人もいる。同じモデルに対し、批判する人はコストを計算し、気に入っている人は性格を記憶し、疑問を持つ人は出自を尋ねる—この三つの要素が今回のリリースに対する真实的なフィードバックだ。
次の競争は、「しない」と公言できるかどうか
リリース内容を広げて見ると—0.7ポイントの差、半分以上の価格スペース、訓練データから意図的に排除された特定の能力。前二つはオープンソースモデルの競争における通常項目だが、三つ目は要求されていない任意の行動であり、それが今回のリリースにおける真の新情報となっている。
過去のオープンソース陣営の物語はスコア追跡だけだった—クローズドソースが何のランキングでトップを取れば、オープンソースも同じランキングで追随する。K3.1 Proは別の事実を前面に押し出している—安全性を訓練データ段階で削減し、その削減が何ポイントの性能低下に相当するかを比較データで示した。能力の差が1ポイント以内に収まった後、オープンソースとクローズドソースを区別する次の指標は、「何をしないか」をデータ付きで約束できるかどうかだ。
この書き込みは、オープンソース特有の属性—検証可能性—を内在している。11月4日に重みが公開されれば、攻撃的能力がどれだけ残されているか、誰でもベンチマークで自分で測定できる。ダウンロード者の手に渡るのは65.7点のスコアを持つ、攻撃的なネットワーク能力を持たないモデル—スコアは次のリリースで塗り替えられるかもしれないが、この事前に明記された「しない」という選択こそが、K3.1 Proが本当に残したものだ。
参照リンク:
- Kimi公式ブログ
- HN議論
- Kimi Codeモデルドキュメント